
Google ทดสอบเอเจนต์เขียนโค้ด 50 งานพบ Gemini thinkingLevel LOW ตอบถูกครบและถูกกว่าค่าเริ่มต้นราว 52% ส่วนการจำกัด maxOutputTokens ไม่ช่วยลดต้นทุน
โดย กองบรรณาธิการ THAI DATA อ่าน 4 นาที
สรุปประเด็นสำคัญ
- Sergio Villani จาก Google Cloud AI เผยแพร่ผลทดสอบใน Google Developers Blog เมื่อ 3 พฤศจิกายน 2026 กับชุดงานเอเจนต์เขียนโค้ด 50 งาน ที่ตรวจคำตอบอัตโนมัติ เพื่อวัด ต้นทุนต่องานที่สำเร็จ แทนราคาต่อโทเคน
- ตั้ง Gemini 3.8 Flash เป็น thinkingLevel LOW ตอบถูก 50 จาก 50 ในราคารวม 0.02632 ดอลลาร์ ส่วนค่าเริ่มต้นที่เพดาน 4,096 โทเคนตอบถูกเท่ากันแต่คิด 0.05535 ดอลลาร์ ซึ่งต่างราว 52% (คำนวณเอง)
- การจำกัด maxOutputTokens เป็น 300 ไม่ลดการคิดของโมเดล งานง่าย 27 งานใช้โทเคนคิดเฉลี่ย 185.6 เทียบกับ 179.7 ตอนไม่จำกัด และทำให้งานยาก 7 จาก 25 งาน พัง
- ตัวจัดเส้นทางแบบ Jev ส่งงานไป Flash-Lite ก่อนแล้วส่งเฉพาะงานยากไป Flash แบบ LOW ได้ 50 จาก 50 ที่ 0.02287 ดอลลาร์ และเวลาเฉลี่ย 1.90 วินาที เทียบกับ 3.55 วินาที ของ LOW อย่างเดียว ขณะที่กฎคีย์เวิร์ดตกจาก 93.8% เหลือ 70.6% กับงานที่ไม่เคยเห็น
Google เผยผลทดสอบใน Google Developers Blog เมื่อวันที่ 3 พฤศจิกายน 2026 ว่า Gemini thinkingLevel LOW กับ Gemini 3.8 Flash ทำให้เอเจนต์เขียนโค้ดตอบถูกครบ 50 จาก 50 งาน ด้วยต้นทุนรวม 0.02632 ดอลลาร์ ซึ่งต่ำกว่าค่าเริ่มต้นราว 52% ตามที่เราคำนวณจากตารางของ Google
ทำไม Google วัด Gemini thinkingLevel LOW ด้วยต้นทุนต่องานที่สำเร็จ
Sergio Villani จาก Google Cloud AI เขียนว่าราคาต่อล้านโทเคนลดลงต่อเนื่อง แต่ค่าใช้จ่ายของเอเจนต์เขียนโค้ดกลับสูงขึ้น เพราะเอเจนต์วนซ้ำ เรียกเครื่องมือ ลองใหม่ และคิดภายในหลายรอบ ตัวชี้วัดที่ควรใช้จึงเป็นต้นทุนต่องานที่สำเร็จ คือค่าใช้จ่ายทุกรอบหารด้วยจำนวนงานที่ผ่านการตรวจ ทีมทดสอบกับ API จริงของ Gemini และตัวจำแนก Jev ของ TypeSafe โดย Google ระบุว่าไม่มีความร่วมมือกับ TypeSafe และบทความไม่ใช่การรับรอง ตัวจัดเส้นทางแบบเดียวกันสร้างด้วยตัวจำแนกอื่นได้
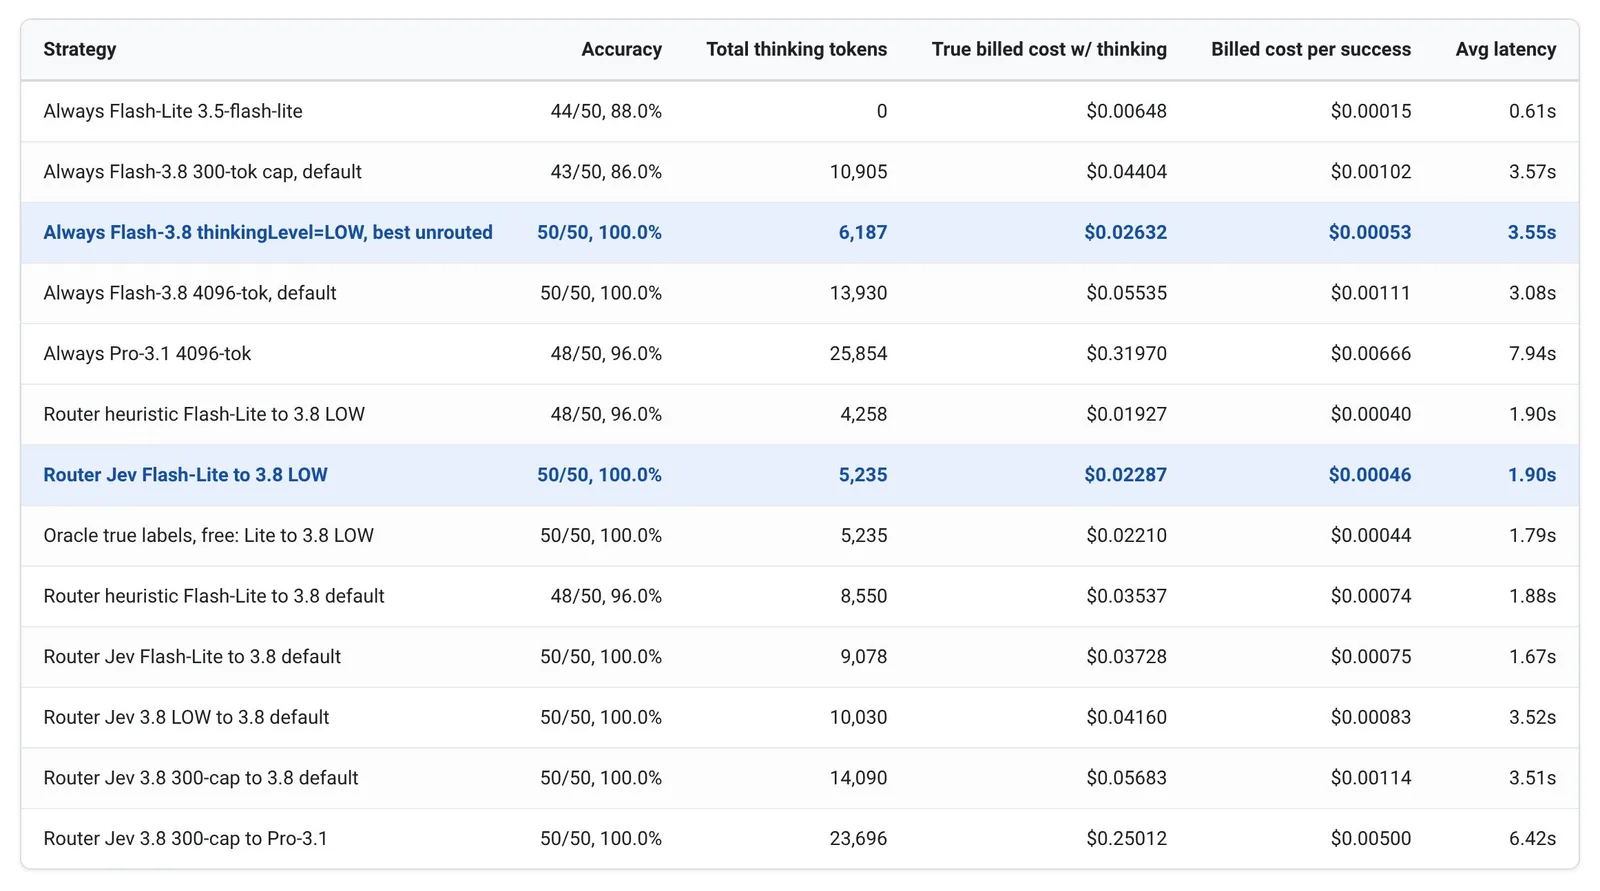
ผลทดสอบ Gemini thinkingLevel LOW เทียบวิธีอื่น
ตารางนี้คัดจากตารางผลของ Google ต้นทุนเป็นดอลลาร์สำหรับ 50 งาน
| วิธี | ตอบถูก | ต้นทุนรวม | ต้นทุนต่องานสำเร็จ | เวลาเฉลี่ย |
|---|---|---|---|---|
| Flash-Lite 3.5 ตลอด | 44/50 | 0.00648 | 0.00015 | 0.61 วินาที |
| Flash 3.8 เพดาน 300 โทเคน | 43/50 | 0.04404 | 0.00102 | 3.57 วินาที |
| Flash 3.8 thinkingLevel LOW | 50/50 | 0.02632 | 0.00053 | 3.55 วินาที |
| Flash 3.8 เพดาน 4,096 ค่าเริ่มต้น | 50/50 | 0.05535 | 0.00111 | 3.08 วินาที |
| Pro 3.1 เพดาน 4,096 | 48/50 | 0.31970 | 0.00666 | 7.94 วินาที |
| ตัวจัดเส้นทางกฎคีย์เวิร์ด Lite ไป LOW | 48/50 | 0.01927 | 0.00040 | 1.90 วินาที |
| ตัวจัดเส้นทาง Jev Lite ไป LOW | 50/50 | 0.02287 | 0.00046 | 1.90 วินาที |
Google ระบุว่า Gemini thinkingLevel LOW เป็นวิธีที่ดีที่สุดเมื่อไม่ใช้ตัวจัดเส้นทาง จึงควรเริ่มจาก Gemini thinkingLevel LOW ก่อนสร้างระบบเพิ่ม โดยตั้ง thinkingLevel เป็น LOW โดยตรง
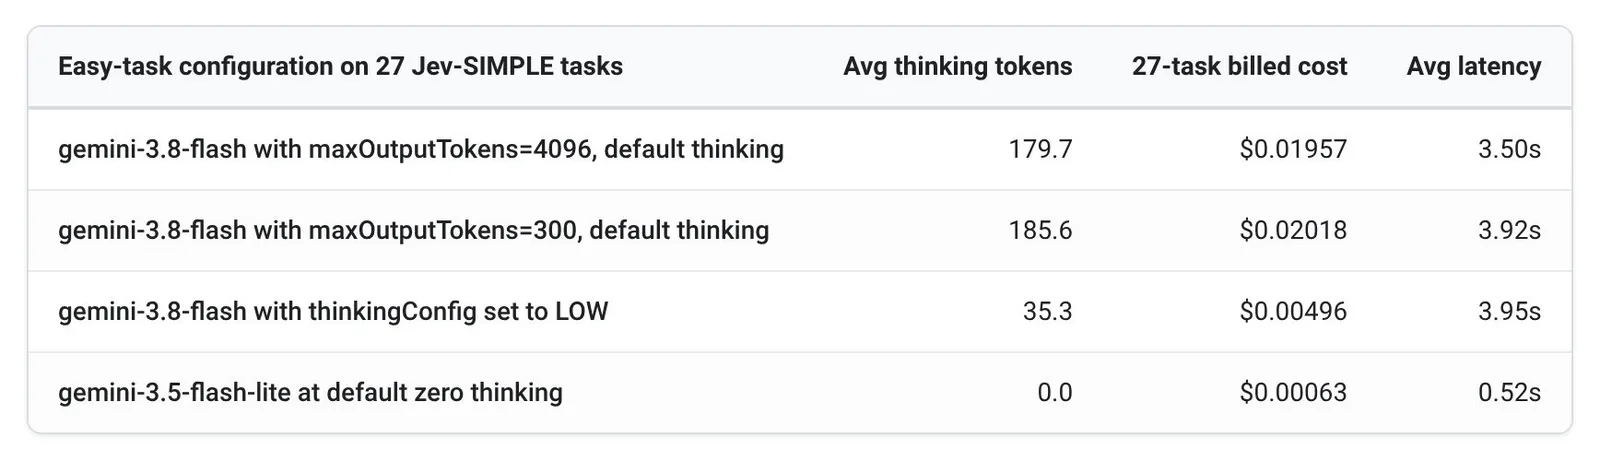
เพดาน maxOutputTokens ไม่ใช่ตัวคุมการคิดแบบ Gemini thinkingLevel LOW
หลายทีมคิดว่าจำกัด maxOutputTokens ต่ำจะทำให้โมเดลคิดน้อยลงกับงานง่าย ข้อมูลของ Google ชี้ตรงข้าม กับงานง่าย 27 งานที่ Jev ตัดสินว่า SIMPLE โมเดลใช้โทเคนคิดเฉลี่ย 185.6 เมื่อจำกัด 300 โทเคน และ 179.7 เมื่อจำกัด 4,096 ต้นทุนรวม 27 งานเป็น 0.02018 และ 0.01957 ดอลลาร์ ส่วน Gemini thinkingLevel LOW ใช้โทเคนคิดเฉลี่ยเพียง 35.3 และต้นทุน 0.00496 ดอลลาร์ ขณะที่ Flash-Lite ไม่คิดเลยและต้นทุน 0.00063 ดอลลาร์
เพดานยังทำให้งานยาก 7 จาก 25 งานพัง หกงานโมเดลหมดที่ขณะยังคิดอยู่และไม่ตอบ อีกงานบีบการคิดจนตอบผิด
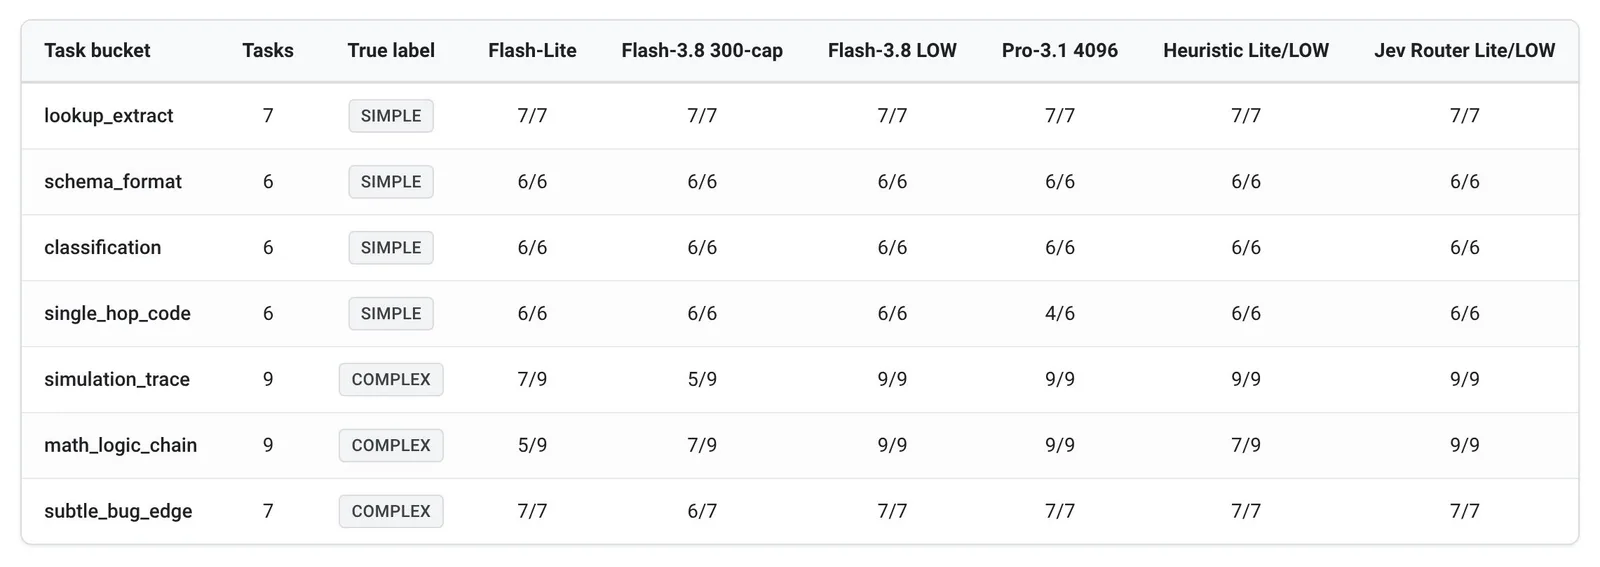
กฎคีย์เวิร์ดพังเมื่อเจองานใหม่
ทีมเขียนกฎ regex กับความยาวพรอมต์ที่คัดงานยากได้ 15 จาก 16 งาน (93.8%) แต่เมื่อตรึงโค้ดแล้วทดสอบ 34 งานที่ไม่เคยเห็นใน 7 กลุ่ม ความแม่นยำตกเหลือ 70.6% เพราะงานง่าย เช่น ดึงพอร์ตจาก Kubernetes YAML ยาวเกิน 35 คำจึงถูกส่งไปโมเดลแพงเกินจำเป็น ส่วนงานตามรอยหลายขั้นที่สั้นไม่มีคำที่กฎจับจึงถูกส่งไปทางง่าย Jev แก้ได้เมื่อถามคำถามใช่หรือไม่ที่เจาะจงข้อเดียว แทนถามกว้างว่างานง่ายหรือยาก
ตัวจัดเส้นทาง Jev ส่งทุกงานไป Flash-Lite ก่อน และส่งเฉพาะที่ถูกตัดสินว่าซับซ้อนไป Flash แบบ Gemini thinkingLevel LOW Flash-Lite เพียงอย่างเดียวพลาด 6 จาก 25 งานยาก Jev จับได้ครบทั้ง 6 ผลคือตอบถูก 50 จาก 50 ที่ 0.02287 ดอลลาร์ ถูกกว่า Gemini thinkingLevel LOW อย่างเดียวราว 13% และเร็วกว่าราว 46% (คำนวณเอง) Google บอกว่าบนพรอมต์สั้นเช่นนี้ผลต่างต้นทุนต่องานเล็กน้อย ประโยชน์ที่ใหญ่กว่าคือเวลารอ
แคชบริบทกับตัวจัดเส้นทางดึงไปคนละทาง
Google เตือนว่าเอเจนต์จริงมักส่งบริบทก้อนใหญ่ซ้ำทุกรอบ เช่น แผนที่ของคลังโค้ดและนิยามเครื่องมือ การแคชบริบทบน Agent Platform ลดค่าส่งซ้ำ 75% ถึง 90% แต่แคชผูกกับโมเดลเดียว ถ้าสลับ Flash-Lite กับ Flash ทุกรอบ จะต้องมีสองแคชหรือเสียส่วนลด จึงควรจัดเส้นทางเฉพาะงานสั้นที่ครบในตัว เช่น แยกวิเคราะห์ล็อกหรือตรวจสคีมา และคงรอบที่พึ่งบริบทหนักไว้กับโมเดลเดียว Google ยังพบว่าการตั้งค่า Pro ปฏิเสธโจทย์ตรวจความปลอดภัยโค้ดสั้น 2 ข้อที่ Flash ตอบได้ ทีมที่ใช้เอเจนต์ตรวจความปลอดภัยจึงควรทดสอบโจทย์เหล่านั้นกับการตั้งค่าที่จะใช้จริง
ผลต่อองค์กรไทยที่ใช้ Gemini thinkingLevel LOW
ข้อมูลเป็นการรันเดียวกับ 50 โจทย์ ไม่ใช่มาตรฐานของงานทั่วไป ข้อเสนอต่อไปนี้ส่วนที่ 1 ถึง 3 สอดคล้องกับ Google และส่วนที่ 4 ถึง 5 เป็นความเห็นของเรา
- ตั้ง Gemini thinkingLevel LOW ก่อน แล้ววัดคำตอบกับงานจริง แทนการลดเพดานโทเคน
- เปลี่ยนจากพารามิเตอร์เดิมไปใช้ Gemini thinkingLevel LOW โมเดล Gemini 3 ขึ้นไปใช้ thinkingLevel ซึ่งสัมพันธ์กับการย้ายจาก Gemini 2.5 ตามข่าวGemini 2.5 Pro ถูกส่งต่อ 1 ธันวาคม
- เก็บร่องรอยการใช้โทเคนก่อนและหลังเปิด Gemini thinkingLevel LOW ส่งจำนวนโทเคนคิดของเอเจนต์ไป Cloud Logging และ BigQuery เพื่อดูว่างานใดกินงบ
- ตั้งชุดโจทย์ของตัวเอง รวมงานภาษาไทยและงานภายในองค์กร แล้วแยกชุดสำหรับเขียนกฎกับชุดสำหรับทดสอบ เพราะกฎที่เขียนจากตัวอย่างเดิมจะตกเมื่อเจองานใหม่
- คิดต้นทุนต่องานสำเร็จ ไม่ดูเฉพาะราคาต่อโทเคนหรือจำนวนครั้งที่เรียก
ติดตามข่าว AI อื่น ๆ ได้ที่หมวด AI
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
Google ชี้ว่าตัวจำแนกขนาดเล็กรันเองบนเครื่องของตนได้ โดยโมเดลที่โฮสต์เองคิดเงินเป็นชั่วโมง GPU ไม่ใช่ตามโทเคน องค์กรที่อยากทดลองทางนี้ประเมินสเปกกับโมเดลที่เลือกก่อน GPU Server ของ THAI DATA CLOUD ให้เช่า NVIDIA Tesla T4 และ V100 สำหรับงาน AI บน Data Center มาตรฐาน ISO 27001 (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
คำถามที่พบบ่อย
Gemini thinkingLevel LOW คืออะไร?
Gemini thinkingLevel LOW คือการตั้งระดับการคิดของโมเดลรุ่น Gemini 3 ขึ้นไปให้ต่ำ ผ่านพารามิเตอร์ thinkingLevel แทน thinking_budget เดิม Google ทดสอบกับ Gemini 3.8 Flash แล้วพบว่าลดโทเคนคิดรวมของ 50 งานเหลือ 6,187 จาก 13,930 ของค่าเริ่มต้นโดยยังตอบถูกครบ
ทำไมจำกัด maxOutputTokens จึงไม่ประหยัด?
Google อธิบายว่า maxOutputTokens เป็นเพดาน ไม่ใช่ตัวปรับงบการคิด งานง่ายตอบสั้นไม่ถึงเพดานอยู่แล้ว เพดาน 300 โทเคนจึงไม่ลดต้นทุน และทำให้งานยาก 7 จาก 25 งานพัง เพราะโมเดลหมดที่ขณะยังคิดอยู่
ควรสร้างตัวจัดเส้นทางโมเดลหรือไม่?
Google แนะนำให้เริ่มจาก Gemini 3.8 Flash แบบ LOW ก่อน เพราะตอบถูกครบและถูกกว่าค่าเริ่มต้นมาก จากนั้นจึงเพิ่มตัวจำแนกขนาดเล็กส่งงานง่ายไป Flash-Lite ถ้าต้องการลดเวลารอ ในการทดสอบวิธีนี้ลดเวลาเฉลี่ยจาก 3.55 เหลือ 1.90 วินาทีและค่าใช้จ่ายลงอีกเล็กน้อย
ผลทดสอบของ Google เชื่อถือได้แค่ไหน?
Google ระบุว่าเป็นการรันเดียวต่อการตั้งค่า กับ 50 โจทย์ที่กำหนดระดับความยากด้วยมือและตรวจอัตโนมัติแบบง่าย ตัวเลขจริงขึ้นกับความยาวพรอมต์ การแคชบริบท และภาระงาน องค์กรควรวัดซ้ำกับงานของตัวเอง
แหล่งอ้างอิง
- Cost per task: Using cheap classifiers to route across Gemini models and thinking levels — Google for Developers Blog
- Gemini API release notes — Google (Gemini API docs)
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Google204Google Cloud101NVIDIA145Tesla106
- ผลิตภัณฑ์และเทคโนโลยี
- Gemini76Kubernetes44BigQuery14
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ