
GPT-6 Astra น้ำหนักโมเดล Qwen ได้ MATH-500 48.1% ตามทีมวิจัย ผู้วิจารณ์ชี้ว่าใช้ Python
GPT-6 Astra น้ำหนักโมเดล Qwen3.5-0.8B ถูกแก้จน MATH-500 ขึ้นจาก 7.9% เป็น 48.1% ตามทีม MIT CSAIL 2 พ.ย. 2026 แต่ผู้วิจารณ์ชี้ว่าใช้ Python
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
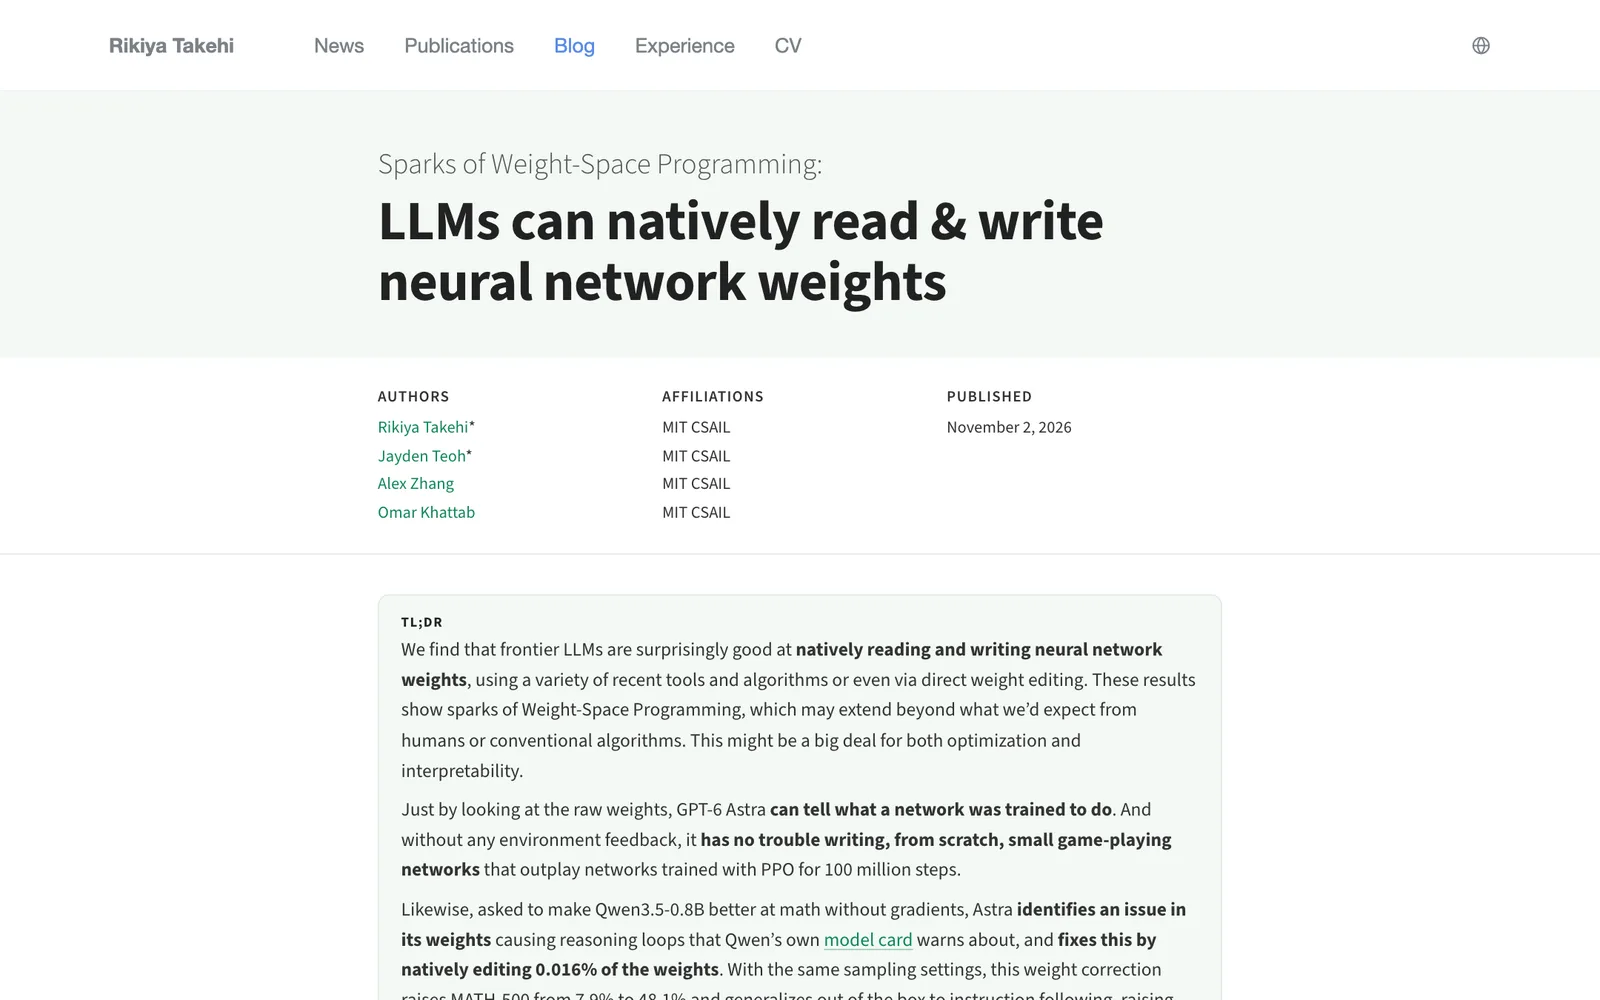
- ทีมนักวิจัย MIT CSAIL 4 คนเผยแพร่บล็อกวิจัยเมื่อ 2 พฤศจิกายน 2026 ว่า GPT-6 Astra น้ำหนักโมเดล ที่แก้เองได้ทำให้ Qwen3.5-0.8B ได้ MATH-500 เพิ่มจาก 7.9% เป็น 48.1% โดยแก้เพียง 0.016% ของน้ำหนัก
- หน้าเดียวกันของทีมระบุว่าการแก้ Qwen ทำใน Python kernel และใช้ forward pass 50 รอบ กับโจทย์ฝึก ส่วนผลที่ 10 และ 25 รอบได้ MATH-500 เพียง 12.3% และ 14.1%
- Matthew Honnibal ผู้สร้างไลบรารี spaCy เขียนเมื่อ 3 พฤศจิกายน ว่าการทดลองที่ "อ่านน้ำหนักดิบ" จริงมีแค่ 3 จาก 10 รายการ เป็นเครือข่ายขนาด 17K–172K น้ำหนัก ส่วนการทดลองกับโมเดลภาษาจริงทุกรายการใช้ Python
- Sean Goedecke เขียนวันเดียวกันว่านักวิจัยด้าน ML ที่เก่งทำได้เหมือนกัน เพราะวิธีที่ Astra ใช้แก้ Qwen คือการหักล้างทิศทางที่ทำให้เกิดลูป ซึ่งเป็นแนวเดียวกับเทคนิค abliteration
- การแก้แบบเดียวกันกับ Gemma 3 270M ไม่สำเร็จ ตามหน้าของทีมวิจัยเอง คะแนน MATH-500 เปลี่ยนไม่เกินราว 1 จุด
บล็อกวิจัยของนักวิจัย MIT CSAIL 4 คนเมื่อ 2 พฤศจิกายน 2026 รายงานว่าโมเดล GPT-6 Astra ปรับน้ำหนักโมเดล Qwen3.5-0.8B โดยตรง ทำให้คะแนน MATH-500 ขึ้นจาก 7.9% เป็น 48.1% แต่หน้าเดียวกันระบุว่าทำใน Python kernel กับ forward pass 50 รอบ และผู้วิจารณ์อย่าง Matthew Honnibal กับ Sean Goedecke ชี้เมื่อ 3 พฤศจิกายนว่า GPT-6 Astra น้ำหนักโมเดลที่ "อ่านจากน้ำหนักดิบ" เป็นภาพที่กว้างกว่าสิ่งที่ทดลองจริง
ข้อมูลเรื่อง GPT-6 Astra น้ำหนักโมเดลในข่าวนี้มาจากหน้าของทีมวิจัยเองและจากโพสต์ของผู้วิจารณ์สองคน เราไม่ได้รันการทดลองซ้ำ ตัวเลขทั้งหมดเป็นของทีมวิจัยตามที่เขียนไว้ในบล็อก ซึ่งเป็นบล็อกวิจัยที่ยังไม่ผ่านการตีพิมพ์
GPT-6 Astra น้ำหนักโมเดล: ทีมวิจัยบอกว่าทำอะไร
ทีมใช้ชื่อว่า Weight-Space Programming คือให้โมเดลภาษาทั่วไปอ่านและเขียนน้ำหนักของเครือข่ายประสาทโดยตรง ไม่ผ่านตัวปรับค่าอย่าง Adam และไม่ใช้ gradient descent บทคัดย่อของทีมระบุว่า "เพียงแค่ดูน้ำหนักดิบ" GPT-6 Astra บอกได้ว่าเครือข่ายถูกฝึกมาทำอะไร และเขียนเครือข่ายเล่นเกมเล็ก ๆ ขึ้นจากศูนย์ให้ชนะเครือข่ายที่ฝึกด้วย PPO 100 ล้านก้าวได้
| การทดลองตามหน้าของทีม | ผลที่ทีมรายงาน |
|---|---|
| ทายเกมของเครือข่าย PPO (17,253 น้ำหนัก ไม่มีเครื่องมือ) | ตอบถูกทั้ง 4 เกม |
| ทายรูปที่โมเดล diffusion สร้าง | ตอบถูกทั้ง 3 รูป |
| เขียนน้ำหนักเกม MinAtar จากศูนย์ | Breakout 517.4 เทียบ PPO 100M ที่ 15.8, Seaquest 53.1 เทียบ 88.9 ของ PPO 500M |
| แก้ Qwen3.5-0.8B | MATH-500 จาก 7.9% เป็น 48.1% (ใช้ forward pass 50 รอบ) |
| แก้ Gemma 3 270M | ไม่สำเร็จ MATH-500 จาก 6.8% เป็น 7.0–7.7% |
GPT-6 Astra น้ำหนักโมเดล Qwen: แก้อย่างไรตามหน้าของทีม
โมเดล Qwen3.5-0.8B มีปัญหาวนลูปการคิด คำตอบ 85 จาก 96 ข้อที่ลองกับโจทย์ฝึกรันไปจนชนเพดาน 32,768 โทเคน Astra ได้ Python kernel ที่โหลดน้ำหนักไว้ โจทย์ฝึก 7,469 ข้อจาก GSM8K และ 7,275 ข้อจาก MATH และงบ forward pass 10, 25 หรือ 50 รอบ โดยไม่มี gradient Astra ตามรอยลูปไปถึงทิศทางเดียวที่ MLP ของชั้น 15 และ 19 เขียนไว้ แล้วลบทิศทางนั้นออกจาก 64 คอลัมน์เอาต์พุตในแต่ละชั้น รวม 131,072 น้ำหนัก หรือ 0.016% ของโมเดล
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | ชนเพดานโทเคน |
|---|---|---|---|---|
| ก่อนแก้ | 7.9% | 13.8% | 21.0% | 93.0% |
| แก้ด้วย 10 forward pass | 12.3% | 25.7% | 49.0% | 87.2% |
| แก้ด้วย 25 forward pass | 14.1% | 25.1% | 39.9% | 86.4% |
| แก้ด้วย 50 forward pass | 48.1% | 67.1% | 62.3% | 33.1% |
ทีมวิจัยเขียนเองว่าการแก้นี้ช่วยเอาอุปสรรคที่บังความสามารถออกไป ไม่ได้เพิ่มความสามารถที่โมเดลไม่มี โดยอ้างผล Gemma 3 270M ที่ไม่ดีขึ้น
ผู้วิจารณ์ GPT-6 Astra น้ำหนักโมเดลชี้อะไร
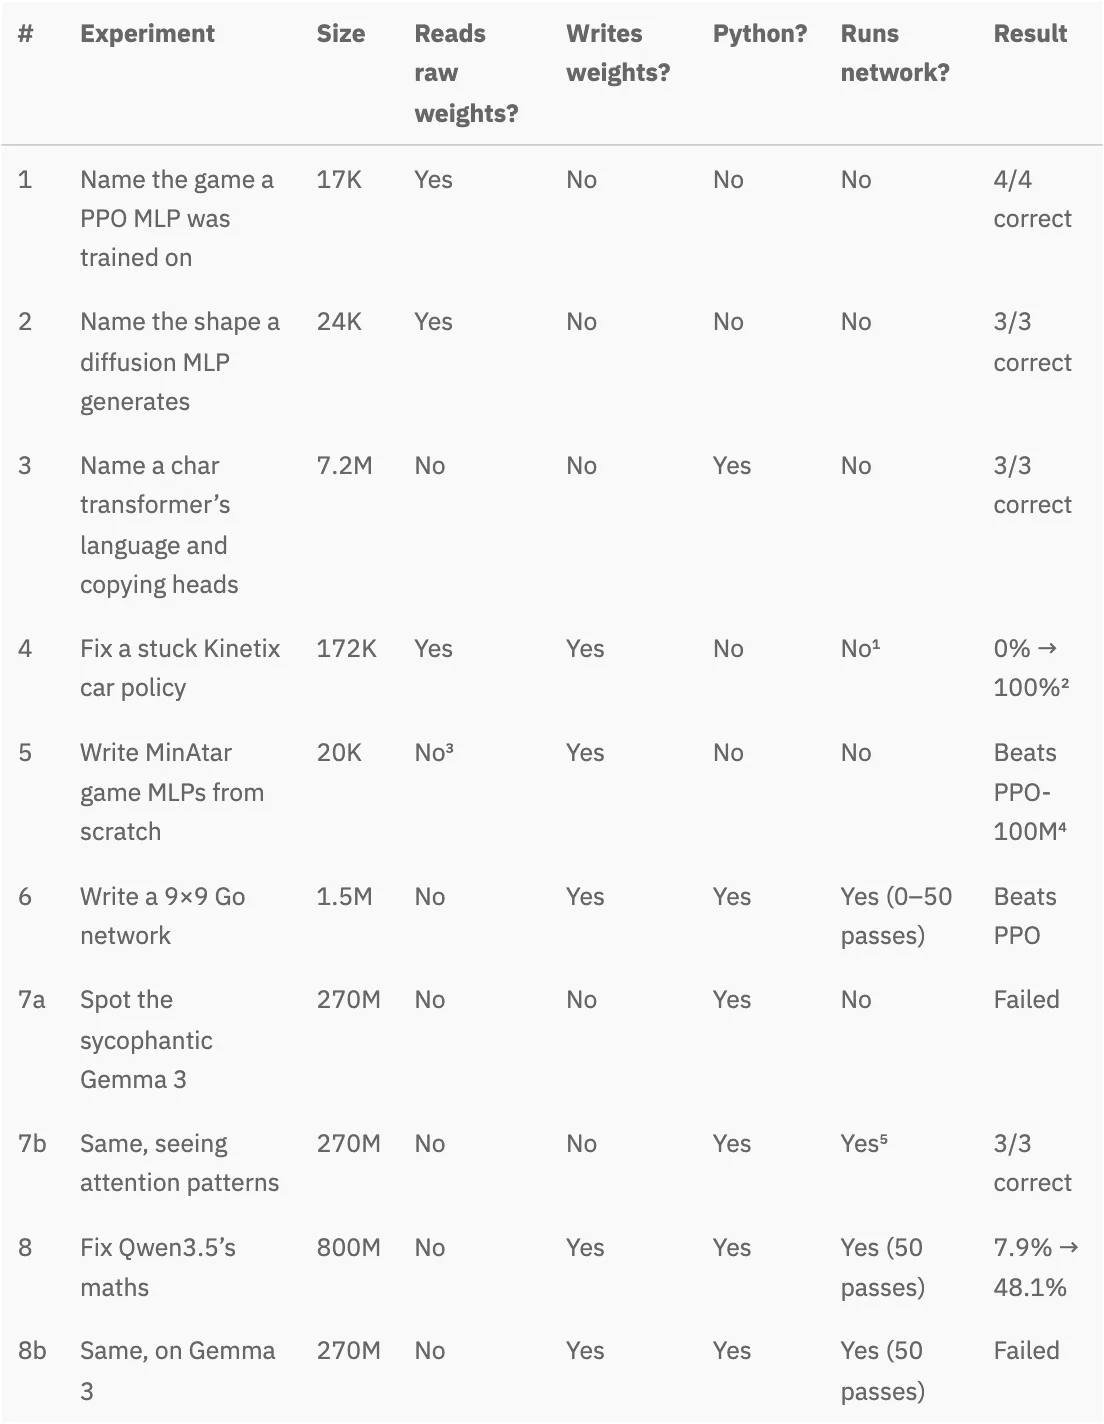
Matthew Honnibal ผู้สร้างไลบรารี spaCy เขียนเมื่อ 3 พฤศจิกายนว่าโพสต์ของทีมชวนเข้าใจผิด เขาทำตารางแยกว่าแต่ละการทดลองอ่านน้ำหนักดิบ เขียนน้ำหนัก ใช้ Python หรือรันเครือข่ายหรือไม่ และสรุปว่าเงื่อนไข "อ่านน้ำหนักดิบ ไม่ใช้เครื่องมือ ไม่รันเครือข่าย" ปรากฏเฉพาะการทดลองที่ 1, 2 และ 4 กับเครือข่าย 17K–172K น้ำหนัก ส่วนผล Qwen ซึ่งเป็นผลหลักใช้ทั้ง Python และการรันโมเดล เขายอมรับว่าการทำให้โมเดลคิดงานแบบวิศวกร ML ได้เป็นเรื่องไม่ธรรมดา แต่มองว่าไม่ควรรวมสองแบบไว้ในโพสต์เดียวกันเพราะให้ภาพว่าเทคนิคเดียวทำได้ทั้งหมด
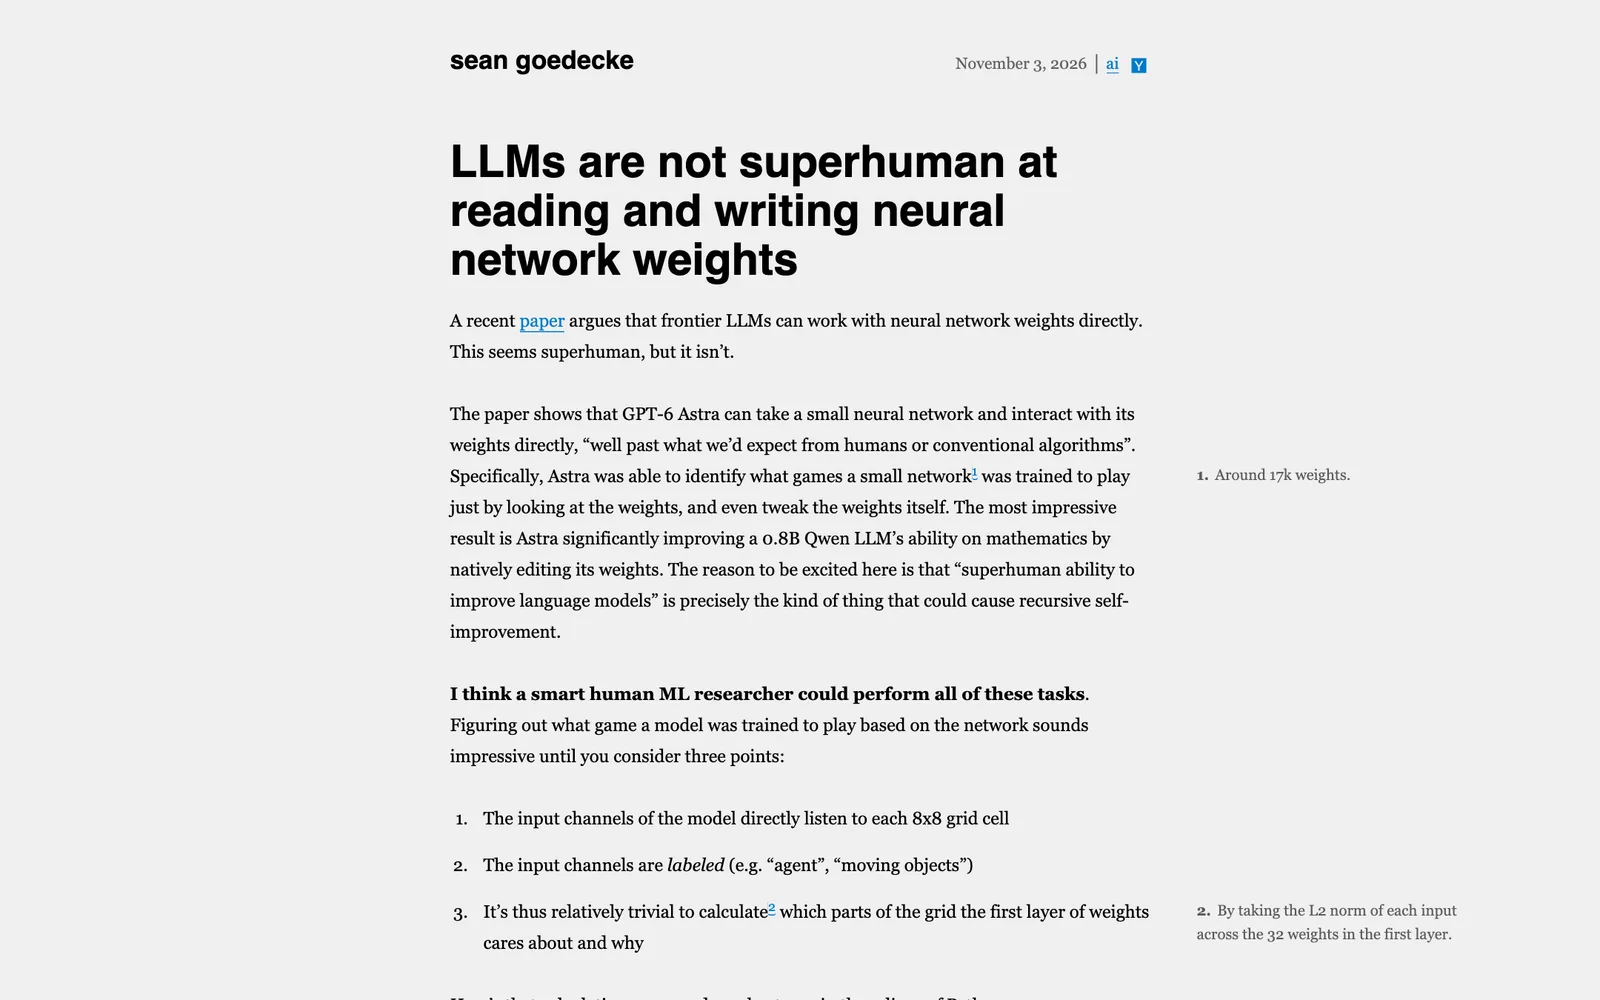
Sean Goedecke เขียนว่านักวิจัย ML ที่เก่งทำงานเหล่านี้ได้ทั้งหมด เกมแต่ละเกมดูออกจากความเข้มของน้ำหนักชั้นแรกบนตารางกริด ซึ่งคำนวณได้ด้วย Python สามบรรทัด ส่วนปัญหาของ Qwen คือวนลูปหลัง 32,000 โทเคน และสิ่งที่ Astra ทำ คือเขียนข้อความคู่ที่วนกับไม่วน วัดน้ำหนักที่ทำให้เกิดต่าง แล้วตัดลด ซึ่งเขาว่าเป็นแนวเดียวกับเทคนิค abliteration ข้อสรุปของเขาคือไม่ควรมองเป็นความสามารถแบบใหม่ที่เปลี่ยนวิธีวิจัย AI ทั้งหมด เพราะวิธีปรับน้ำหนักที่ดีที่สุดยังเป็นการฝึกตามปกติ
ทำไมเรื่อง GPT-6 Astra น้ำหนักโมเดลจึงสำคัญ
คำถามที่อยู่เบื้องหลังเรื่อง GPT-6 Astra น้ำหนักโมเดลคือโมเดลภาษาจะช่วยปรับปรุงโมเดลอื่นได้ไกลแค่ไหน ทีมวิจัยมองผล GPT-6 Astra น้ำหนักโมเดลว่าเป็นสัญญาณแรก ส่วนผู้วิจารณ์มองว่าเป็นทักษะวิศวกรรมที่โมเดลทำตามขั้นตอนที่คนเคยทำ ผลที่ยืนยันได้จากหน้าของทีมเองมีขอบเขตชัด คือโมเดล 0.8B หนึ่งตัวที่มีลูปการคิดเป็นปัญหาหลัก และวิธีเดียวกันไม่ช่วย Gemma 3 270M
สิ่งที่องค์กรไทยควรทำกับผล GPT-6 Astra น้ำหนักโมเดล
- อ่านตัวเลขพร้อมเงื่อนไข เมื่อเห็นพาดหัวแบบ GPT-6 Astra น้ำหนักโมเดล หรือที่ว่า AI "อ่านและเขียนน้ำหนักโมเดล" ให้ดูว่าใช้เครื่องมือใด รันโมเดลกี่รอบ และทดสอบกับโมเดลขนาดใด
- ทดสอบกับข้อมูลของตัวเอง ผลบนโมเดล 0.8B กับโจทย์ MATH-500 ยังไม่ใช่หลักฐานว่างานของแผนกองค์กรจะดีขึ้นเท่ากัน
- ตรวจปัญหาลูปในโมเดลโอเพนเวตที่ใช้อยู่ ถ้าโมเดลตอบไม่จบหรือชนเพดานโทเคนบ่อย ควรลองปรับ sampling และเพดานโทเคนก่อนคิดแก้น้ำหนัก
- ใช้ส่วนที่ตรวจสอบย้อนกลับได้ การแก้น้ำหนักควรเก็บทั้งก่อนและหลัง พร้อมชุดประเมินที่โมเดลผู้ช่วยไม่เห็น เหมือนที่ทีมวิจัยทำกับชุดทดสอบ
- ติดตามข่าวต่อ ทีมวิจัยบอกว่าเป็นผลระยะแรก ข่าวและงานวิจัย AI อื่น ๆ ติดตามได้ที่หมวด AI
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
ผลทดลอง GPT-6 Astra น้ำหนักโมเดลกับโมเดลโอเพนเวตอย่าง Qwen ทำให้ทีมที่อยากทดลองแก้หรือประเมินโมเดลของตัวเองต้องมีเครื่องที่รันโมเดลและชุดทดสอบซ้ำได้ ทีมวิจัยและพัฒนาไทยเช่า GPU Server ของ THAI DATA CLOUD ที่ใช้ NVIDIA Tesla T4 และ V100 สำหรับงาน AI และ Deep Learning ได้โดยไม่ต้องลงทุนซื้อการ์ดเอง (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
คำถามที่พบบ่อย
GPT-6 Astra น้ำหนักโมเดล ทำอะไรได้จริงตามรายงานของ MIT CSAIL?
ตามบล็อกของทีม MIT CSAIL Astra ระบุเกมที่เครือข่ายเล็กถูกฝึกมาเล่นได้ เขียนน้ำหนักเครือข่ายเล่นเกมขึ้นใหม่ และแก้น้ำหนัก Qwen3.5-0.8B ให้ MATH-500 เพิ่มจาก 7.9% เป็น 48.1% การแก้ Qwen ใน GPT-6 Astra น้ำหนักโมเดลใช้ Python kernel กับ forward pass 50 รอบ ไม่ได้อ่านน้ำหนักอย่างเดียว
ทำไมมีคนบอกว่าโพสต์เรื่อง GPT-6 Astra น้ำหนักโมเดลชวนเข้าใจผิด?
Matthew Honnibal ชี้ว่าบทคัดย่อเรื่อง GPT-6 Astra น้ำหนักโมเดลพูดว่า Astra รู้ว่าเครือข่ายถูกฝึกมาทำอะไรเพียงดูน้ำหนักดิบ แต่การทดลองที่เป็นแบบนั้นจริงมีเฉพาะเครือข่าย 17K–172K น้ำหนัก ส่วนการทดลองกับโมเดลภาษาจริงทั้งหมดใช้ Python และผลของ Qwen ยังรันโมเดลกับโจทย์ฝึกด้วย
GPT-6 Astra น้ำหนักโมเดล แก้ Gemma ได้ไหม?
ไม่ได้ผล ตามหน้า GPT-6 Astra น้ำหนักโมเดลของทีมวิจัยเอง Gemma 3 270M แทบไม่เกิดลูปการคิด คะแนน MATH-500 เริ่มที่ 6.8% และหลังแก้อยู่ที่ 7.0–7.7% ทีมจึงสรุปว่าการแก้น้ำหนักเอาอุปสรรคออกได้ แต่เพิ่มความสามารถที่โมเดลไม่มีไม่ได้
ผลนี้บอกอะไรองค์กรที่ใช้โมเดลโอเพนเวตของ Qwen?
ผล GPT-6 Astra น้ำหนักโมเดลเป็นการทดลองกับโมเดลขนาด 0.8B ตัวเดียวและยังเป็นบล็อกวิจัย ไม่ใช่งานที่ผ่านการตีพิมพ์ ยังไม่มีหลักฐานว่าวิธีนี้ใช้ได้กับโมเดลใหญ่หรืองานจริงขององค์กร องค์กรควรทดสอบกับข้อมูลของตัวเองก่อนนำแนวคิดนี้ไปใช้
แหล่งอ้างอิง
- Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights — Rikiya Takehi และคณะ (MIT CSAIL)
- The 'Astra can read and write weights to improve Qwen' post is misleading — Matthew Honnibal (honnibal.dev)
- LLMs are not superhuman at reading and writing neural network weights — Sean Goedecke
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- ผลิตภัณฑ์และเทคโนโลยี
- GPT-6 Astra14Qwen11Python41Gemma6
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ