
AWS TorchNeuron เปิดซอร์สแล้ว ให้โค้ด PyTorch รันบนชิป Trainium โดยไม่ต้องเขียนใหม่
AWS TorchNeuron แบ็กเอนด์ PyTorch แบบเนทีฟสำหรับชิป Trainium เปิดซอร์สแบบ Apache 2.0 เป็นรุ่น Beta วันที่ 20 ต.ค. 2026 ให้โค้ดเดิมรันบน Trainium2 และ Trainium3
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- 19 ตุลาคม 2026 AWS เปิดตัว AWS TorchNeuron แบ็กเอนด์ PyTorch แบบเนทีฟสำหรับชิป Trainium และเปิดซอร์สภายใต้สัญญาอนุญาต Apache 2.0 เป็นรุ่น public Beta ในงาน PyTorch Conference North America วันที่ 20 ตุลาคม 2026
- Amazon ระบุว่า 85% ของนักวิจัยและนักพัฒนา AI เขียนโค้ดด้วย PyTorch และ TorchNeuron ให้โค้ดเดิมรันบน Trainium ได้ด้วยการเปลี่ยนการตั้งค่าเพียงจุดเดียว คือเลือกอุปกรณ์เป็น neuron
- รองรับ Trainium2 และ Trainium3 ทั้งโหมด eager และ torch.compile รวมถึง API กระจายงานอย่าง DDP และ FSDP2 ส่วน FP8 และ TorchAO ยังเป็น private Beta
- Deepgram ระบุว่าในการทดสอบของบริษัท Trainium ประมวลผลเสียงได้มากกว่า GPU เดิมราว 60% ต่อดอลลาร์ ขณะที่ AWS ระบุว่าเครื่อง Trn2 มี price performance ดีกว่าเครื่อง GPU รุ่น P5e และ P5en 30–40%
- เอกสาร EC2 ของ AWS ระบุเครื่อง Trn2 ใน 4 Region คือ Ohio, Hyderabad, Melbourne และ São Paulo และไม่มีเครื่องตระกูล Trn ใน Region Asia Pacific (Thailand) และ Singapore
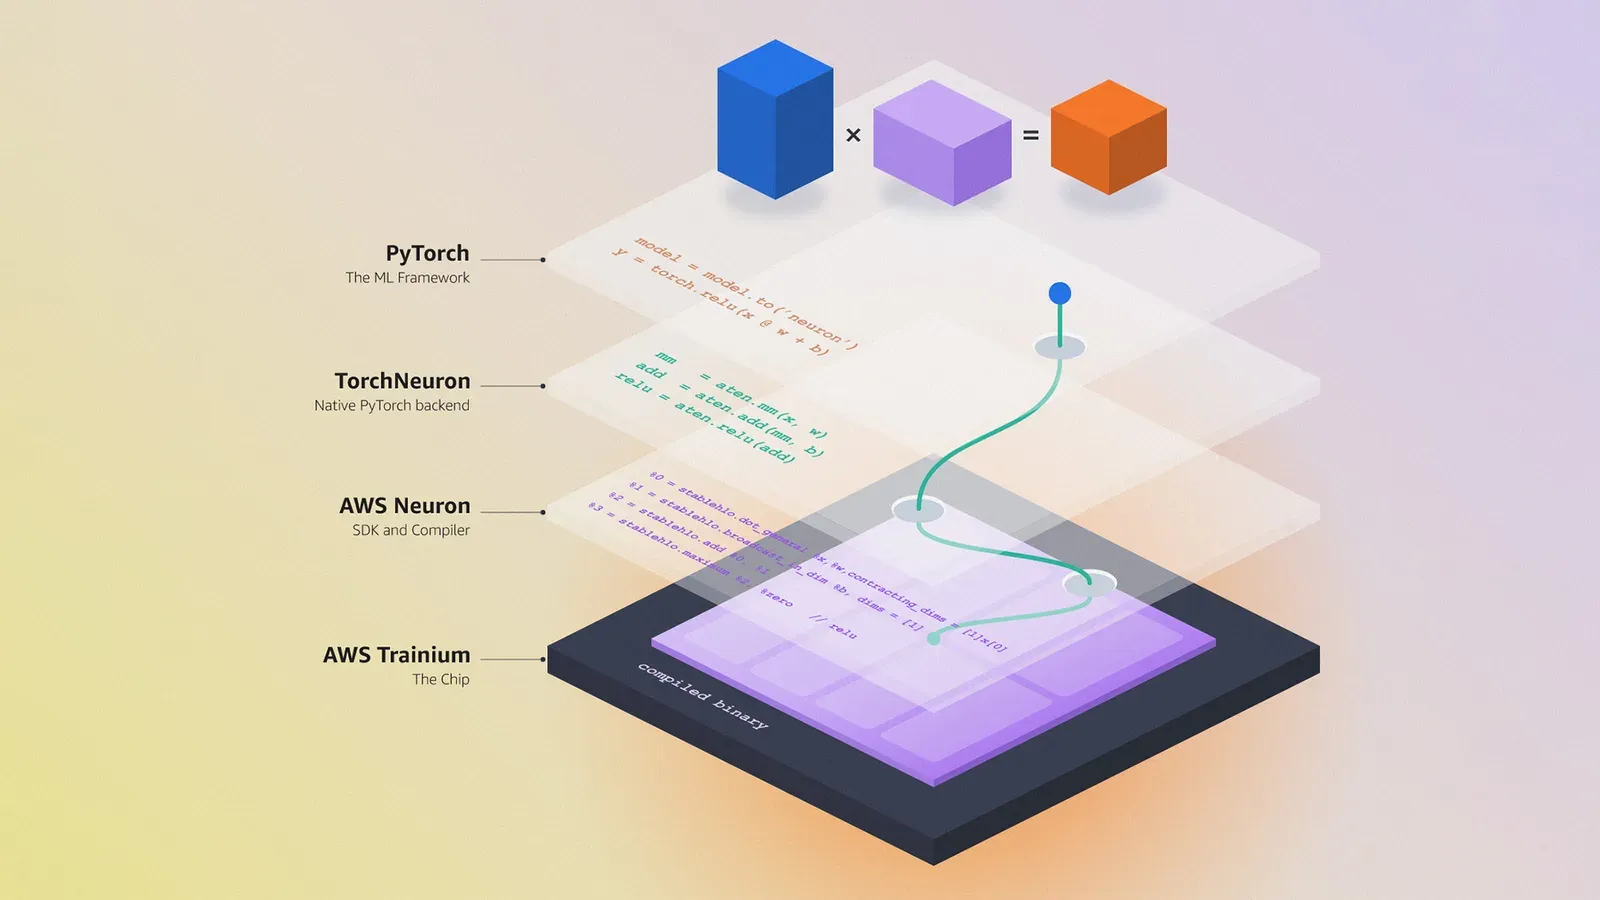
AWS เปิดตัว AWS TorchNeuron เมื่อวันที่ 19 ตุลาคม 2026 เป็นแบ็กเอนด์ PyTorch แบบเนทีฟที่ทำให้โค้ด AI ที่เขียนด้วย PyTorch รันบนชิป AWS Trainium ได้โดยแทบไม่ต้องแก้ และเปิดซอร์สภายใต้สัญญาอนุญาต Apache 2.0 เป็นรุ่น public Beta ในงาน PyTorch Conference North America วันที่ 20 ตุลาคม 2026
Amazon ระบุในประกาศว่า 85% ของนักวิจัยและนักพัฒนา AI ทุกวันนี้เขียนโค้ดด้วย PyTorch แต่ที่ผ่านมาการขยายไปใช้ชิปใหม่หมายถึงการเขียนและตรวจสอบงานที่ใช้เวลาหลายเดือนกว่าจะลงตัวขึ้นใหม่ AWS TorchNeuron คือความพยายามของ AWS ที่จะลดแรงเสียดทานส่วนนี้ เพื่อให้การเปลี่ยนมาใช้ชิปของ AWS เองทำได้ง่ายขึ้น
AWS TorchNeuron เปลี่ยนวิธีเขียนโค้ดอย่างไร
บล็อกที่ทีม AWS เขียนบนเว็บไซต์ PyTorch อธิบายว่า TorchNeuron ลงทะเบียน Trainium เข้ากับ PyTorch ผ่าน PrivateUse1 ซึ่งเป็นช่องทางมาตรฐานที่ PyTorch เปิดไว้ให้ฮาร์ดแวร์ใหม่ API ที่นักพัฒนาใช้อยู่แล้ว เช่น torch.nn, torch.autocast, torch.distributed และ torch.profiler จึงทำงานกับอุปกรณ์ชื่อ neuron ได้ตามเดิม
- โค้ดทั่วไป เปลี่ยนเพียงบรรทัดที่ย้ายโมเดลไปยังอุปกรณ์ เป็น
.to('neuron') - โค้ดที่เขียนด้วย torch.accelerator ซึ่งเป็น API กลางที่ PyTorch แนะนำ รันได้โดยไม่ต้องแก้เลย
- โมเดลที่ใช้ torch.compile ต้องระบุแบ็กเอนด์ neuron หนึ่งครั้ง จากนั้นคอมไพเลอร์ของ Neuron จะแปลงกราฟของโมเดลเป็นไฟล์ที่รันบนชิป
ในการสาธิตของ Amazon วิศวกรรันสคริปต์ฝึกโมเดลชุดเดียวกันบนชิปทั่วไปและบน Trainium โดยต่างกันเพียงค่าตั้งที่บอกว่าใช้ชิปใด Amazon ระบุว่าผลที่ได้คือโมเดลเรียนรู้สิ่งเดียวกันในอัตราเดียวกัน
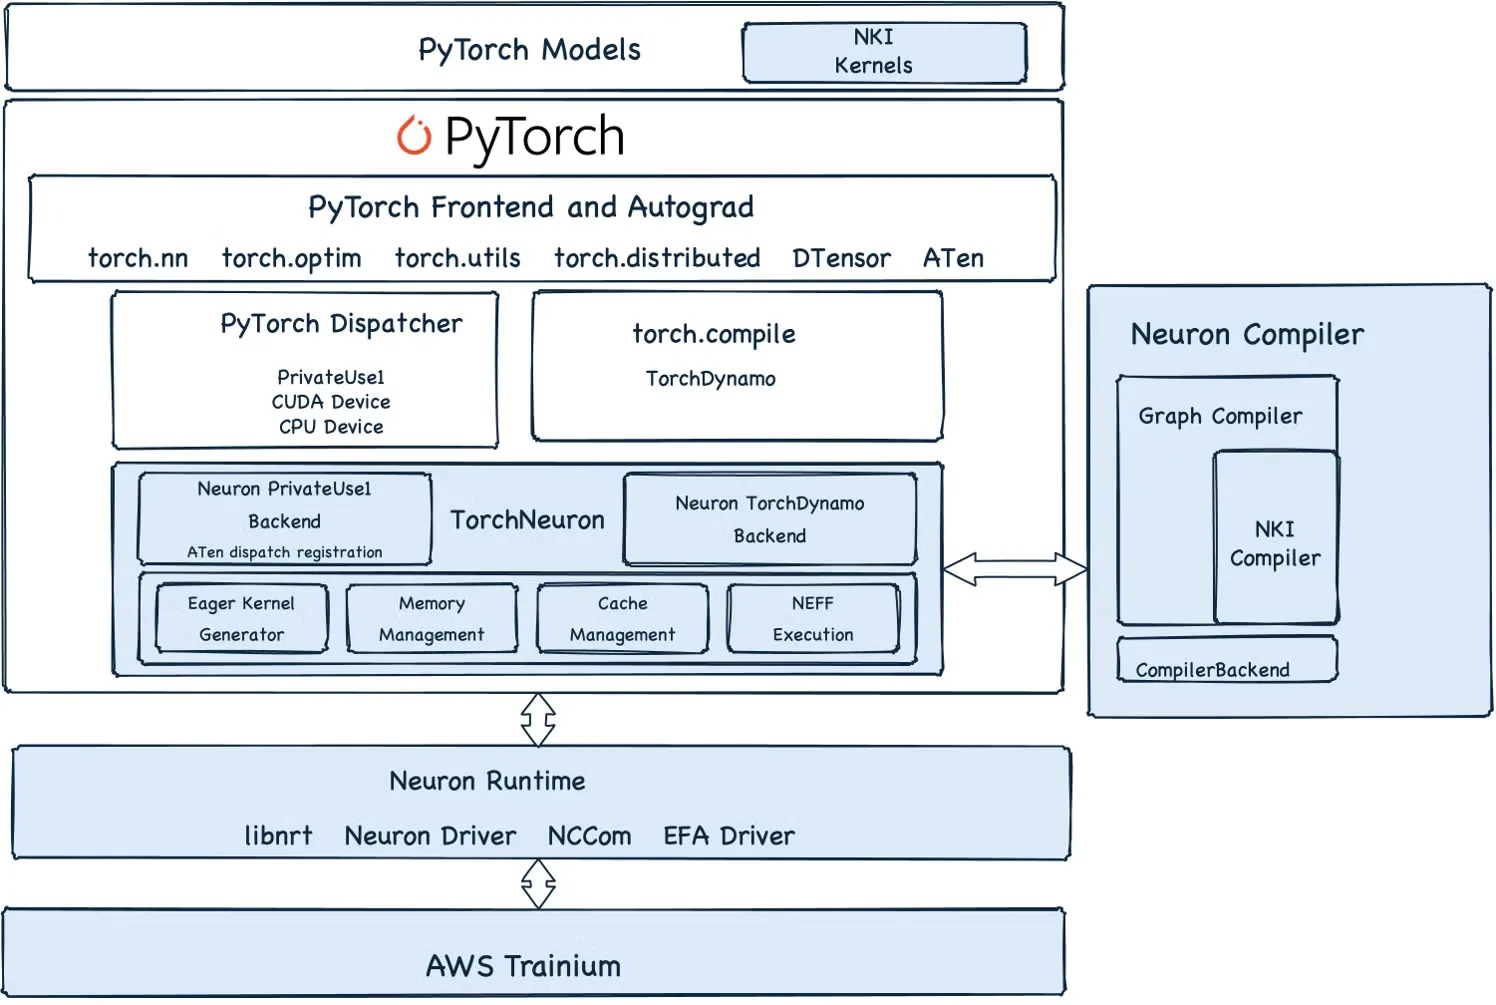
ความสามารถของ AWS TorchNeuron รุ่น Beta
| ด้าน | สิ่งที่รองรับตามบล็อกของ PyTorch |
|---|---|
| โหมดการรัน | eager สำหรับงานวิจัยและดีบัก, adaptive eager (ทดลอง) และ torch.compile สำหรับงาน production |
| ชนิดข้อมูล | BF16, FP32, FP16 และชนิดจำนวนเต็มกับบูลีน ส่วน FP8 และ TorchAO เป็น private Beta |
| การกระจายงาน | DDP, FSDP2, SimpleFSDP, tensor parallelism, pipeline parallelism, DTensor และ DeviceMesh |
| การสื่อสารข้ามเครื่อง | Elastic Fabric Adapter (EFA) และคอร์สำหรับ collective ในตัวชิป |
| เคอร์เนลเฉพาะ | Neuron Kernel Interface (NKI) และไลบรารีโอเพนซอร์ส NKI-lib เช่น FlashAttention |
| การให้บริการโมเดล | vLLM Neuron และ vLLM Omni Neuron สำหรับโมเดลสร้างภาพและวิดีโอ |
| ชิปที่รองรับ | Trainium2 และ Trainium3 |
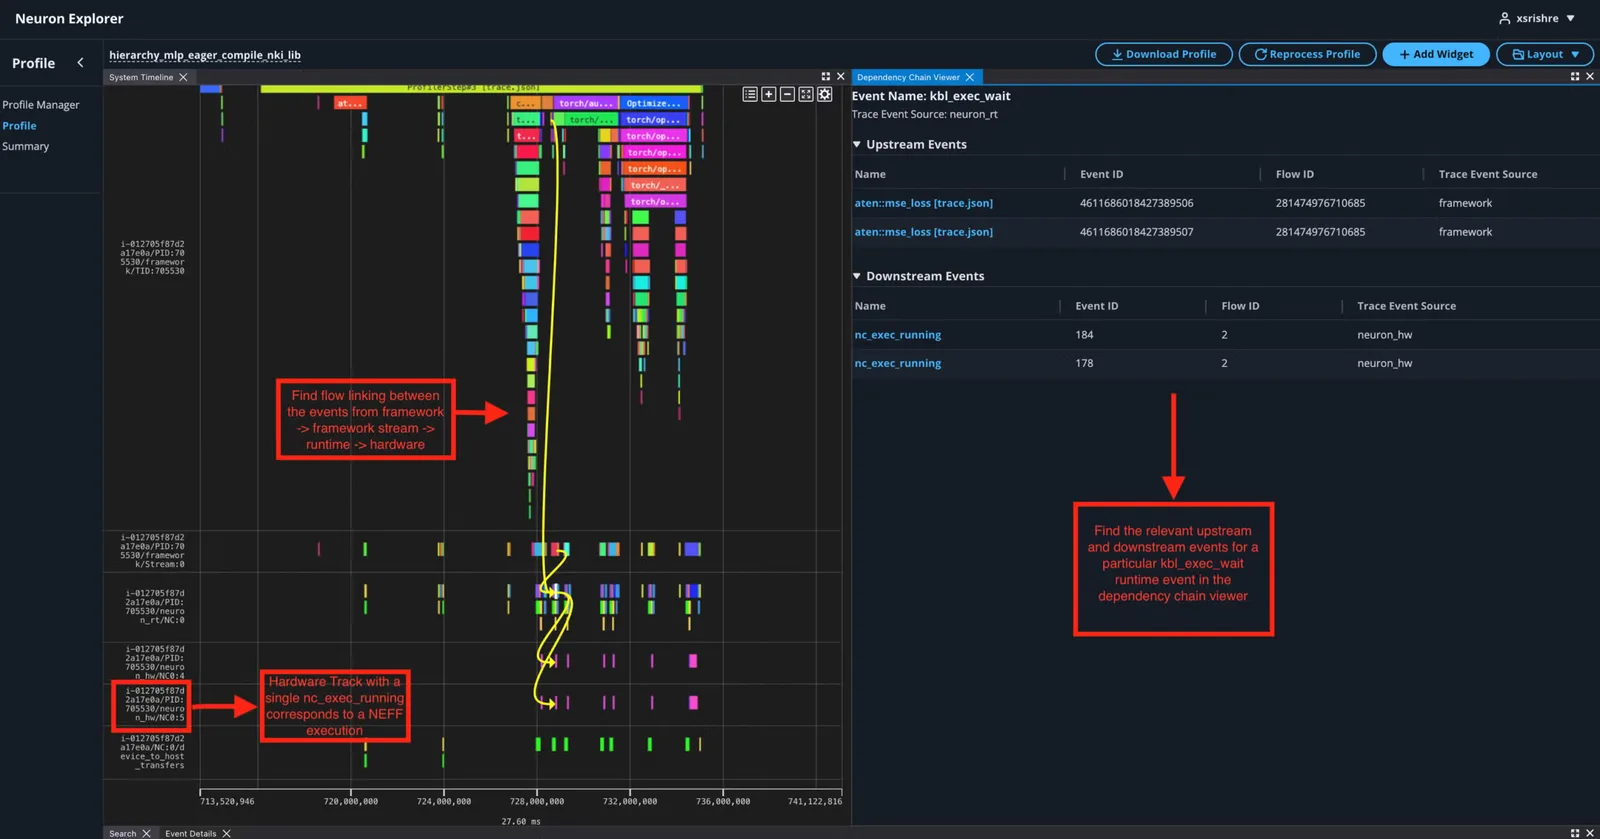
ทีม AWS ระบุว่า FP8 และ TorchAO จะเปิดใช้ทั่วไปในรุ่นถัดไป ส่วนการวิเคราะห์ประสิทธิภาพใช้ torch.profiler ร่วมกับเครื่องมือ Neuron Explorer ซึ่งไล่ดูการทำงานตั้งแต่ระดับเฟรมเวิร์กลงไปถึงฮาร์ดแวร์ และกดย้อนกลับไปหาบรรทัดของซอร์สโค้ดที่เป็นคอขวดได้
ใครเริ่มใช้ AWS TorchNeuron แล้ว
Amazon ระบุว่าผู้ใช้กลุ่มแรกมีทั้งสตาร์ตอัปและองค์กรในงานหุ่นยนต์ วิดีโอ world model รถยนต์ไร้คนขับ เสียงพูด การค้นคว้ายา LLM และการเงิน ตัวอย่างที่บริษัทยกมาในบล็อกของ PyTorch มีดังนี้
- Deepgram ผู้ให้บริการ AI ด้านเสียง ย้ายโมเดลมาใช้ PyTorch แบบเนทีฟบน Trainium ร่วมกับ AWS Generative AI Innovation Center ในโครงการหลายเดือน Adam Sypniewski ประธานเจ้าหน้าที่ฝ่ายเทคโนโลยีของ Deepgram ระบุว่าในการทดสอบที่บริษัทประเมิน Trainium ประมวลผลเสียงอินพุตได้มากกว่า GPU ที่ใช้อยู่เดิมราว 60% ต่อดอลลาร์
- Cartesia ผู้พัฒนาโมเดลเสียงพูด รันไปป์ไลน์ inference ชุดเดิมบน Trainium โดยแก้โค้ด PyTorch เพียงเล็กน้อย
- Hugging Face ทำให้ Trainium เป็นแบ็กเอนด์เนทีฟของไลบรารี Transformers และ Diffusers โดยไม่ต้องใช้โค้ดเฉพาะของ Amazon
- พาร์ตเนอร์ ที่กำลังพัฒนาร่วมกัน ได้แก่ Anyscale, Decart, Kernelize, Loka, Luminal, Makora, Modular, Nota AI, Radix, Wafer และ Yasp
Amazon ระบุด้วยว่าบริษัททดสอบ TorchNeuron กับโมเดล AI หลายแสนโมเดลในทุกการ build และกำลังส่งการแก้ไขกลับเข้า PyTorch เพื่อลบโค้ดที่ผูกเฟรมเวิร์กไว้กับชิปเฉพาะรุ่น ตัวโค้ดเปิดให้ดาวน์โหลดที่ GitHub ภายใต้ชื่อ aws-neuron/torch-neuronx
ทำไมเรื่องนี้สำคัญ
ข้อได้เปรียบของ GPU ในงาน AI ไม่ได้อยู่ที่ชิปอย่างเดียว แต่อยู่ที่ซอฟต์แวร์ที่นักพัฒนาคุ้นเคย Amazon เขียนในประกาศว่าเมื่อนักพัฒนาย้ายงานข้ามชิปได้โดยไม่เสียต้นทุน ผู้ผลิตชิปจะต้องแข่งกันเพื่อให้ได้งานนั้น และนักพัฒนาจะได้ประโยชน์จากต้นทุนที่ต่ำลง
AWS ไม่ได้เดินทางนี้คนเดียว Google ประกาศในงาน PyTorch Conference 2026 ว่าเปิดซอร์ส TorchTPU แบ็กเอนด์ PyTorch แบบเนทีฟสำหรับชิป TPU ที่พัฒนาร่วมกับทีม PyTorch ของ Meta แปลว่าคลาวด์รายใหญ่สองรายกำลังทำให้ชิปของตัวเองเป็นตัวเลือกที่สลับกับ GPU ได้ในโค้ดชุดเดียวกัน
ฝั่งราคา หน้าสินค้าของ AWS ระบุว่าเครื่อง Trn2 ซึ่งมีชิป Trainium2 16 ตัว มี price performance ดีกว่าเครื่อง GPU รุ่น P5e และ P5en 30–40% ตัวเลขนี้เป็นข้อมูลของผู้ขาย ส่วนตัวเลข 60% ของ Deepgram มาจากการทดสอบกับโมเดลของบริษัทเอง ทั้งสองตัวเลขจึงต้องวัดซ้ำกับงานจริงของแต่ละองค์กร เรื่องนี้ยังมาในช่วงที่ AWS เพิ่งขึ้นค่าจอง GPU ใน EC2 Capacity Blocks เมื่อต้นเดือนตุลาคม ทำให้ทางเลือกที่ไม่ใช่ GPU น่าสนใจขึ้นสำหรับทีมที่ต้องจองเครื่องฝึกโมเดล
ผลต่อองค์กรไทย
- ตรวจ Region ก่อนวางแผน เอกสาร Amazon EC2 instance types by Region ระบุเครื่อง Trn2 ใน US East (Ohio), Asia Pacific (Hyderabad), Asia Pacific (Melbourne) และ South America (São Paulo) แต่ไม่มีเครื่องตระกูล Trn ใน Asia Pacific (Thailand) และ Asia Pacific (Singapore) งานที่จะใช้ AWS TorchNeuron จึงต้องรันนอกประเทศ
- ประเมิน PDPA ถ้าข้อมูลฝึกโมเดลมีข้อมูลส่วนบุคคล การส่งข้อมูลไปฝึกหรือให้บริการโมเดลใน Region ต่างประเทศคือการโอนข้อมูลข้ามพรมแดน ฝ่ายกฎหมายควรตรวจเงื่อนไขก่อนย้ายงาน และพิจารณาเลือกเฉพาะงานที่ใช้ข้อมูลไม่ระบุตัวตน
- เขียนโค้ดให้ย้ายชิปได้ตั้งแต่วันนี้ โค้ดที่เขียนด้วย torch.accelerator รันได้ทั้งบน GPU และ Trainium ส่วนโค้ดที่ระบุอุปกรณ์ cuda ไว้ตรง ๆ ต้องแก้จุดนั้นก่อน การเขียนโค้ดแบบไม่ผูกกับชิปจึงช่วยให้เลือกได้ทั้ง GPU, Trainium และ TPU ของ Google
- ทดลองกับงานรองก่อน AWS TorchNeuron ยังเป็นรุ่น Beta และฟีเจอร์ FP8 ยังไม่เปิดใช้ทั่วไป ควรเริ่มจากงาน fine-tune หรือ inference ที่ไม่ใช่ระบบหลัก แล้วเทียบต้นทุนต่อผลลัพธ์กับ GPU ที่ใช้อยู่
- นับต้นทุนทั้งหมด ไม่ใช่แค่ราคาชิป รวมค่าโอนข้อมูลข้าม Region เวลาของวิศวกรในการปรับจูน และบริการที่ต้องใช้คู่กัน เช่น Amazon SageMaker หรือ Amazon EKS ซึ่งหน้าสินค้า Trn2 ระบุว่ารองรับ
ติดตามข่าวคลาวด์และชิป AI สำหรับองค์กรเพิ่มเติมได้ที่หมวดคลาวด์
คำถามที่พบบ่อย
AWS TorchNeuron คืออะไร?
AWS TorchNeuron คือแบ็กเอนด์ PyTorch แบบเนทีฟสำหรับชิป AWS Trainium ที่ลงทะเบียน Trainium เป็นอุปกรณ์มาตรฐานของ PyTorch ผ่านช่องทาง PrivateUse1 ทำให้โค้ด ไลบรารี และเครื่องมือ PyTorch เดิมรันบน Trainium ได้ AWS เปิดซอร์สภายใต้ Apache 2.0 เป็นรุ่น public Beta เมื่อ 20 ตุลาคม 2026
ต้องแก้โค้ด PyTorch มากแค่ไหนถึงจะรันบน Trainium?
บล็อกของ PyTorch ระบุว่าโค้ดที่เขียนด้วย torch.accelerator รันได้โดยไม่ต้องแก้ ส่วนโค้ดทั่วไปเปลี่ยนอุปกรณ์เป็น neuron ด้วยคำสั่ง .to('neuron') และถ้าใช้ torch.compile ต้องระบุแบ็กเอนด์ neuron หนึ่งครั้ง AWS TorchNeuron รองรับชิป Trainium2 และ Trainium3
AWS TorchNeuron ใช้กับ Region ในไทยได้หรือไม่?
ซอฟต์แวร์ AWS TorchNeuron ดาวน์โหลดได้จาก GitHub แต่ต้องรันบนเครื่อง Trainium และเอกสาร Amazon EC2 instance types by Region ไม่ได้ระบุเครื่องตระกูล Trn ใน Asia Pacific (Thailand) และ Singapore องค์กรไทยจึงต้องใช้ Region อื่นที่มีเครื่อง Trn2 เช่น Hyderabad หรือ Melbourne
AWS TorchNeuron พร้อมใช้กับงานจริงหรือยัง?
ยังเป็นรุ่น public Beta ตามที่ทีม AWS เขียนในบล็อกของ PyTorch และฟีเจอร์บางส่วนอย่าง FP8 กับ TorchAO ยังเป็น private Beta ซึ่งจะเปิดใช้ทั่วไปในรุ่นถัดไป องค์กรจึงควรทดลองกับงานที่ไม่ใช่ระบบหลักและวัดผลกับโมเดลของตัวเองก่อน
แหล่งอ้างอิง
- Amazon opens its AWS Trainium AI chips to every PyTorch developer, no rewrite needed — Amazon
- Introducing TorchNeuron: Native PyTorch backend for AWS Trainium — PyTorch Foundation
- aws-neuron/torch-neuronx — GitHub (AWS Neuron)
- Gen AI Compute Instance - Amazon EC2 Trn2 Instances — Amazon Web Services
- Amazon EC2 instance types by Region — Amazon Web Services
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- ผลิตภัณฑ์และเทคโนโลยี
- PyTorch7AWS Trainium4Amazon EC23vLLM6
- กฎหมายและมาตรฐาน
- PDPA104
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ