
Lambda GPU Managed Instances เปิด 18 พ.ย. 2026 รันฟังก์ชันบน GPU NVIDIA ของ EC2 G-series โดย AWS ดูแลไดรเวอร์และการขยาย จ่ายค่าเครื่อง EC2 บวกค่าจัดการ 9.75%
โดย กองบรรณาธิการ THAI DATA อ่าน 6 นาที
สรุปประเด็นสำคัญ
- AWS ประกาศเมื่อ 18 พฤศจิกายน 2026 ว่า Event Functions บน Lambda Managed Instances รันบน GPU ของ EC2 G-series ได้แล้ว
- รองรับ 7 ตระกูลเครื่อง ตั้งแต่ G4dn (NVIDIA T4 16 GB) ถึง G6e (NVIDIA L40S 48 GB) หนึ่ง execution environment ได้ 1 GPU และรับคำขอพร้อมกันได้สูงสุด 48 รายการ
- ค่าใช้จ่ายคือราคา EC2 On-Demand ของเครื่อง บวก ค่าจัดการ 9.75% (ต่ำกว่า 15% ของเครื่อง CPU) และ 0.20 ดอลลาร์ต่อล้านคำขอ ใช้ Savings Plans และ Reserved Instances ได้
- ฟังก์ชัน GPU ใช้ container image สูงสุด 32 GB พื้นที่ชั่วคราวสูงสุด 32 GB และรันงานแบบ asynchronous ได้นานถึง 90 นาที
- เอกสาร AWS ณ 19 พ.ย. 2026 ระบุว่า Region ไทยมีเครื่อง GPU เพียง G7e ซึ่งไม่อยู่ในรายชื่อที่ฟีเจอร์นี้รองรับ
Lambda GPU Managed Instances เปิดใช้แล้ว Amazon Web Services ประกาศเมื่อ 18 พฤศจิกายน 2026 ว่า Event Functions บน Lambda Managed Instances รันบนเครื่อง EC2 G-series ที่มี GPU ของ NVIDIA ได้ ทีมพัฒนาจึงรันโมเดล AI ประมวลผลวิดีโอ หรือเรนเดอร์ภาพเป็นขั้นหนึ่งของแอปแบบ serverless ได้ โดย Lambda ดูแลไดรเวอร์ GPU และการขยายเครื่องให้
ก่อนหน้านี้ไม่กี่วัน AWS เพิ่งเปิดให้ Lambda Managed Instances ลดเครื่องเหลือศูนย์ ได้ ความสามารถนั้นใช้กับฟังก์ชัน GPU ด้วย จึงตั้งให้ไม่จ่ายค่า GPU ช่วงที่ไม่มีงานได้
Lambda GPU Managed Instances ทำงานอย่างไร
AWS อธิบายว่าการรันงาน GPU เองต้องเลือกเครื่อง ติดตั้งไดรเวอร์และไลบรารี CUDA ให้ตรงรุ่นกัน วางแผนความจุ และเขียนระบบขยายเครื่องเอง ฟีเจอร์นี้ย้ายงานเหล่านั้นไปให้ Lambda ทำ ขั้นตอนตามคู่มือมี 4 ขั้น
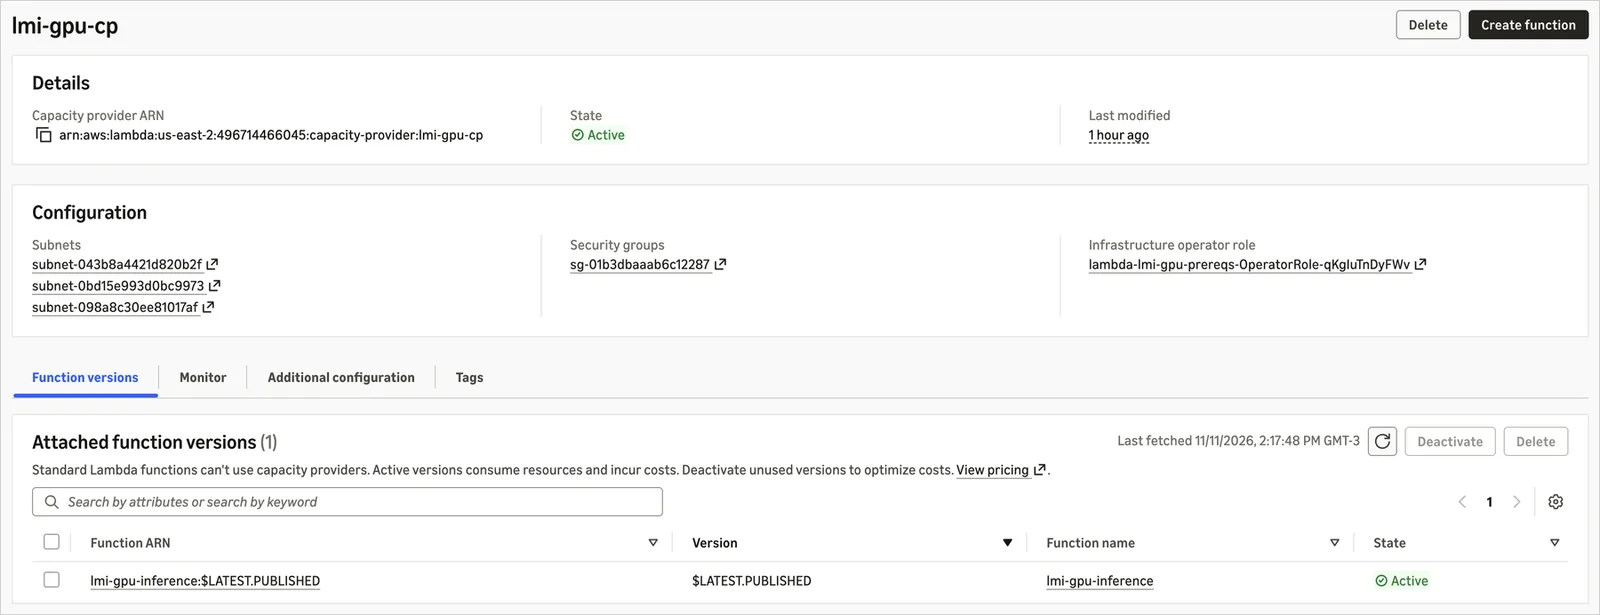
- สร้าง capacity provider: ระบุเฉพาะเครื่อง GPU ที่อนุญาตให้ Lambda ใช้ ระบุหลายรุ่นได้เพื่อให้ Lambda สลับไปรุ่นเก่ากว่าเมื่อรุ่นใหม่ไม่ว่าง
- สร้าง container image: ใช้ base image ของ Lambda ที่มี CUDA, PyTorch, CuPy และเซิร์ฟเวอร์ inference vLLM กับ SGLang หรือสร้าง image เอง
- สร้างฟังก์ชัน: ผูกกับ capacity provider และตั้ง AcceleratorMemorySize เป็นหน่วยความจำ GPU ขั้นต่ำที่ต้องการ (3, 6, 12, 16, 24 หรือ 48 GB)
- เผยแพร่เวอร์ชัน: Lambda เปิดเครื่อง GPU ในบัญชีของลูกค้า ดึง image และเริ่ม execution environment บน GPU
execution environment หนึ่งตัวได้ GPU หนึ่งตัว หรือ GPU แบบแบ่งส่วนหนึ่งส่วน และรับคำขอพร้อมกันได้ตามค่า PerExecutionEnvironmentMaxConcurrency ค่าเริ่มต้น 4 สูงสุด 48 Lambda ขยายจำนวนเครื่องตามการใช้ GPU การใช้ CPU และจำนวนคำขอพร้อมกัน ฟังก์ชันเรียกได้จากบริการของ AWS กว่า 200 ตัวเหมือน Event Functions อื่น เช่น Amazon S3, Amazon SQS และ Amazon API Gateway
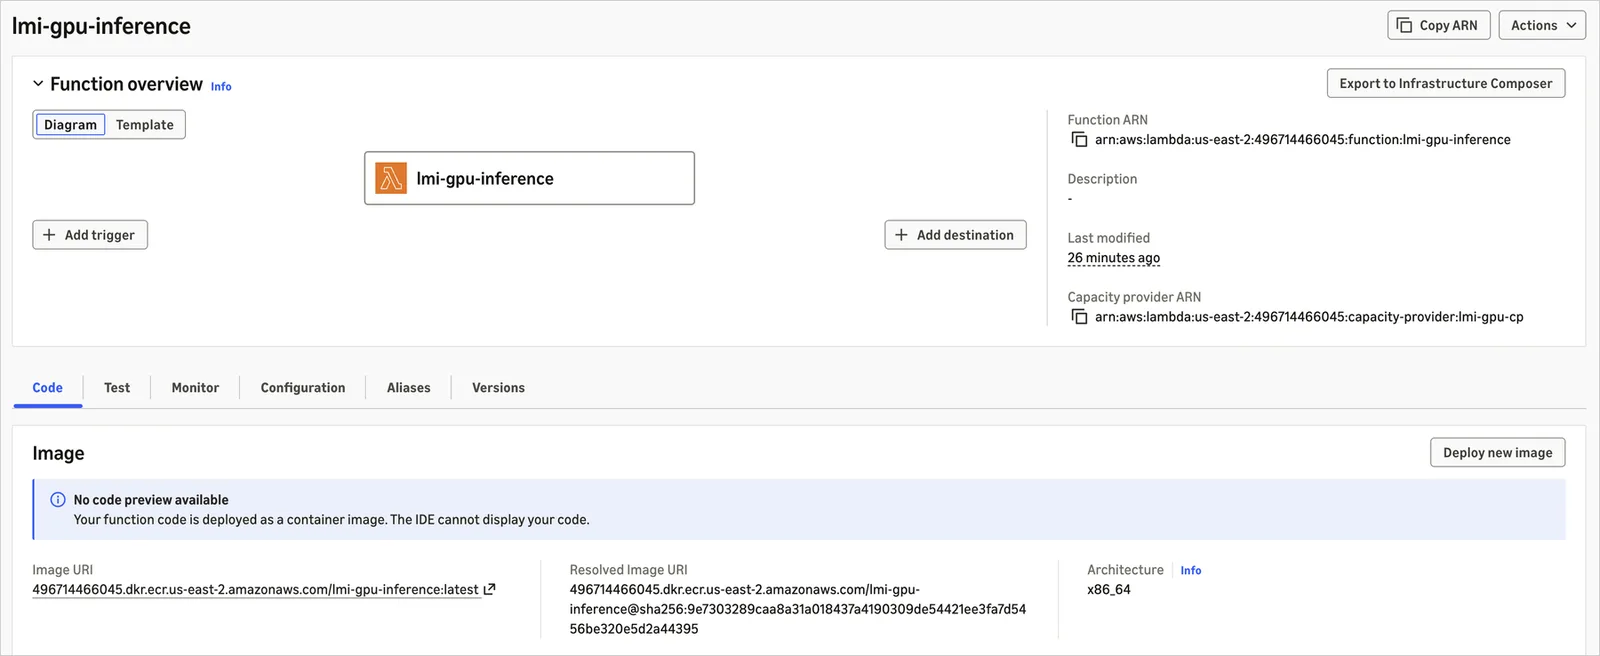
ในบล็อกสาธิตของ AWS ผู้เขียนรันโมเดล Qwen2.5-1.5B-Instruct จาก Hugging Face ด้วย base image ของ vLLM โดย Dockerfile มีบรรทัดเดียว และตั้งชื่อโมเดลผ่านตัวแปร MODEL_ID โดยไม่ต้องเขียนโค้ด inference
เครื่อง GPU ที่ Lambda GPU Managed Instances รองรับ
คู่มือ AWS Lambda ระบุว่า Lambda GPU Managed Instances รองรับ 7 ตระกูลเครื่อง ทุกขนาดใช้ได้ยกเว้น g4dn.metal
| ตระกูลเครื่อง | GPU | หน่วยความจำต่อ GPU |
|---|---|---|
| G4dn | NVIDIA T4 | 16 GB |
| G5 | NVIDIA A10G | 24 GB |
| G6 | NVIDIA L4 | 24 GB |
| Gr6 | NVIDIA L4 | 24 GB |
| G6e | NVIDIA L40S | 48 GB |
| G6f | NVIDIA L4 แบบแบ่งส่วน | 3, 6 หรือ 12 GB ตามขนาดเครื่อง |
| Gr6f | NVIDIA L4 แบบแบ่งส่วน | 12 GB |
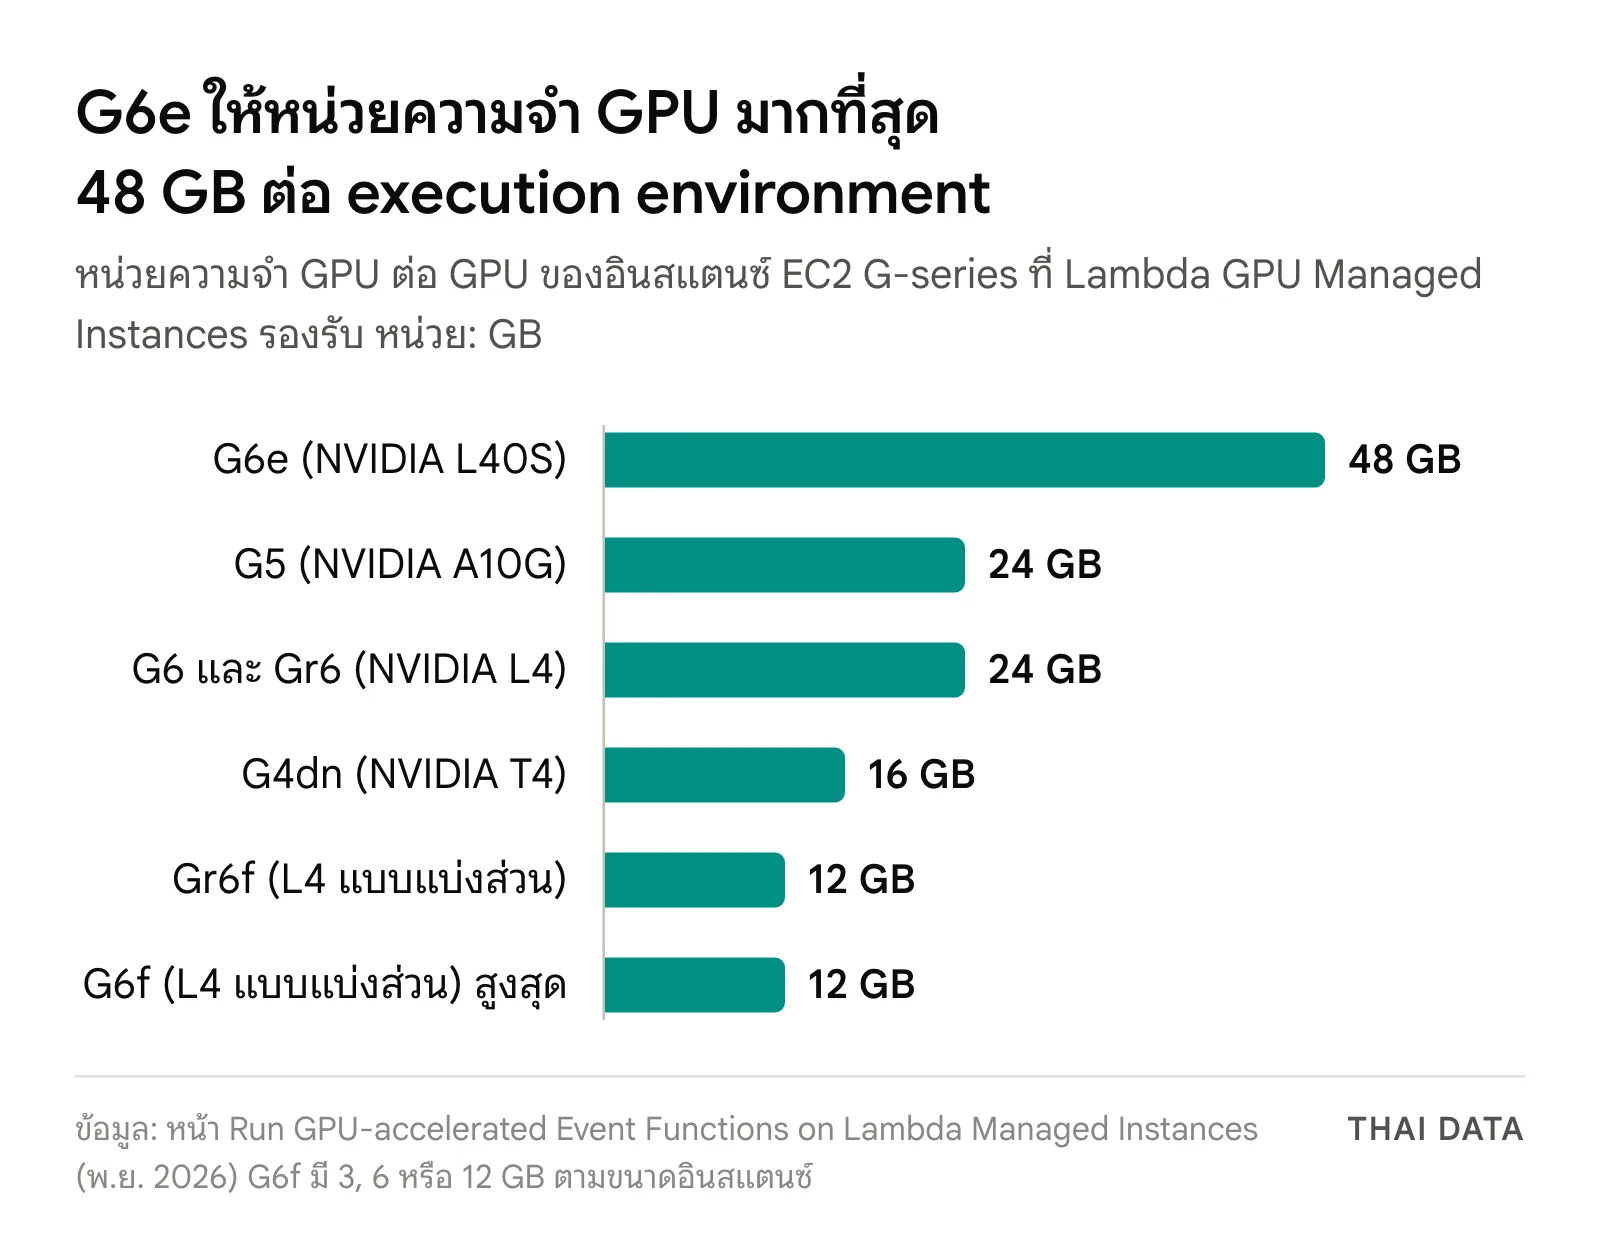
ขีดจำกัดของ Lambda GPU Managed Instances ต่างจากฟังก์ชันทั่วไปบน Lambda Managed Instances ในหลายจุด
- แพ็กเกจ: ใช้ได้เฉพาะ container image ขนาดสูงสุด 32 GB (ไฟล์เดียวไม่เกิน 10 GB) ส่วนฟังก์ชันทั่วไปสูงสุด 10 GB
- พื้นที่ชั่วคราว /tmp: 512 MB ถึง 32,768 MB
- หน่วยความจำของฟังก์ชัน: 2,048 ถึง 32,768 MB
- เวลารัน: งานแบบ asynchronous และ event source mapping รันได้นานถึง 90 นาที
- ขนาด capacity provider: สูงสุด 15,000 vCPU
- ลดเวลาเริ่มเครื่อง: ใช้ Seekable OCI (SOCI) โหลด image เท่าที่ใช้ และสตรีมน้ำหนักโมเดลจาก Amazon S3
ราคาของ Lambda GPU Managed Instances
หน้า AWS Lambda Pricing แบ่งค่าใช้จ่ายเป็นสามส่วน คือค่าคำขอ 0.20 ดอลลาร์ต่อล้านคำขอ ค่าจัดการที่บวกจากราคา EC2 On-Demand และค่าเครื่อง EC2 ตามราคามาตรฐาน ค่าจัดการของเครื่อง GPU G-series อยู่ที่ 9.75% ต่ำกว่าเครื่อง CPU ที่ 15% และส่วนลดจาก Compute Savings Plans หรือ Reserved Instances ใช้กับค่าเครื่องได้
ข้อที่ต้องรู้ก่อนเริ่มใช้ Lambda GPU Managed Instances คือโควตา Running On-Demand G and VT instances ของ EC2 ตั้งต้นที่ 0 vCPU ต้องยื่นขอเพิ่มก่อน ไม่เช่นนั้น Lambda เปิดเครื่อง GPU ไม่ได้ ผู้ดูแลยังจำกัดค่าใช้จ่ายได้ด้วยค่า MaxVCpuCount ของ capacity provider เช่น g6.4xlarge ใช้ 16 vCPU ต่อเครื่อง
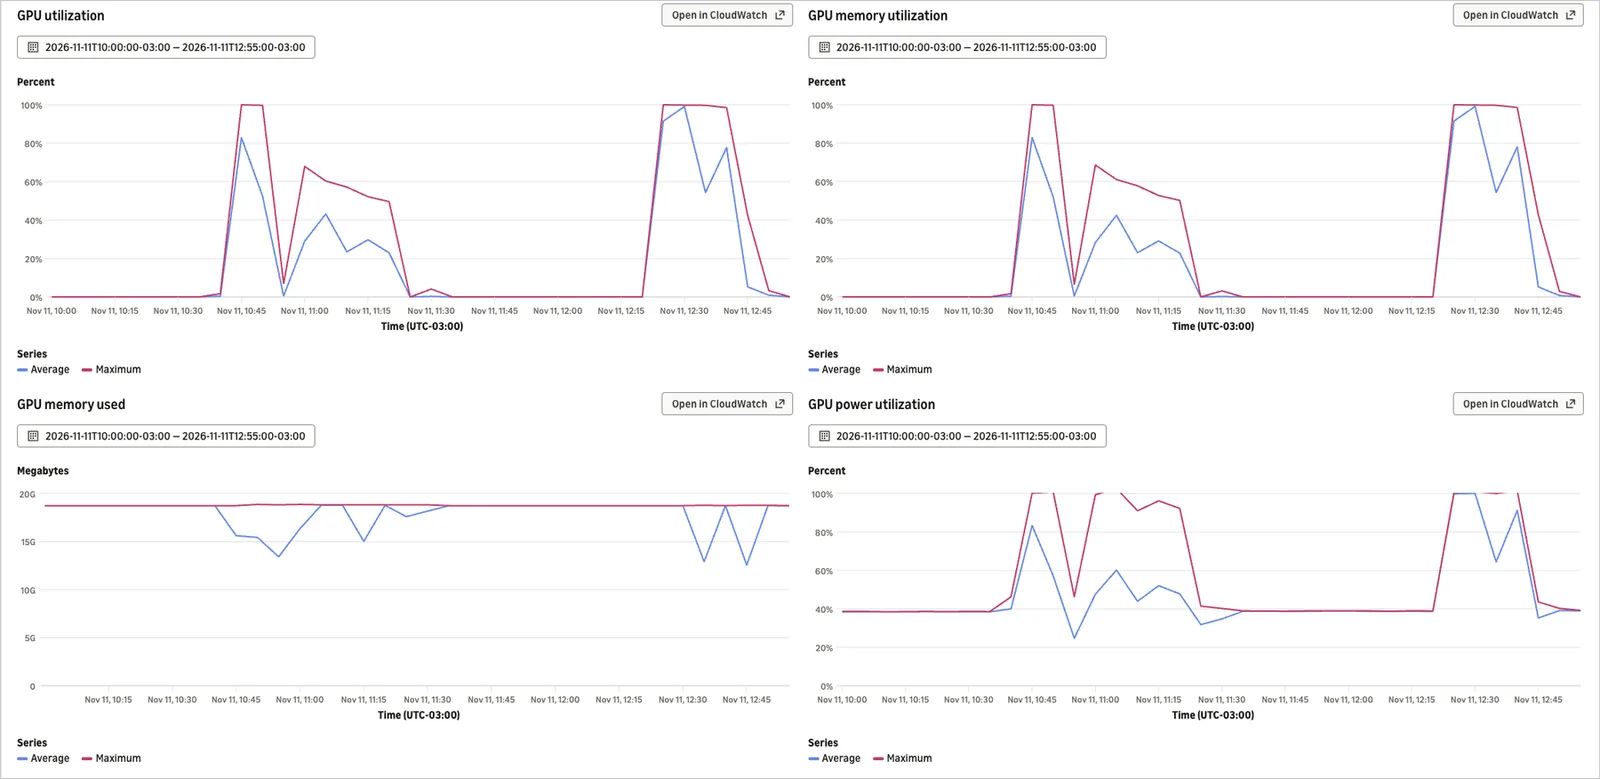
Lambda GPU Managed Instances ส่งค่า GPU utilization, GPU memory utilization, GPU memory used และ GPU power utilization ไปที่ Amazon CloudWatch ทั้งระดับ capacity provider และระดับฟังก์ชัน ใช้ดูว่า GPU ที่จ่ายเงินอยู่ถูกใช้คุ้มหรือไม่
Lambda GPU Managed Instances กับ Region ใกล้ไทย
AWS ระบุว่าฟีเจอร์นี้เปิดในทุก Region เชิงพาณิชย์ที่มีทั้ง Lambda Managed Instances และเครื่อง G-series แต่ไม่ได้ให้รายชื่อ Region เราจึงเทียบกับหน้า Amazon EC2 instance types by Region ที่เปิดดูเมื่อ 19 พ.ย. 2026
| Region | เครื่อง G-series ที่มี | ตรงกับรายชื่อที่รองรับ |
|---|---|---|
| Asia Pacific (Thailand) | G7e | ไม่ตรง |
| Asia Pacific (Singapore) | G4dn, G5g | G4dn |
| Asia Pacific (Malaysia) | G6, Gr6, G7e | G6, Gr6 |
| Asia Pacific (Jakarta) | G5, G5g, G7e | G5 |
ตารางนี้บอกเพียงว่ามีเครื่องที่ตรงรายชื่อหรือไม่ ผู้ใช้ยังต้องตรวจในคอนโซลว่า Region นั้นเปิด Lambda Managed Instances แล้ว ส่วนองค์กรที่วาง workload ไว้ที่ Region ไทยเพื่อเก็บข้อมูลในประเทศ ตอนนี้ยังใช้ฟีเจอร์นี้ใน Region ไทยไม่ได้ตามเอกสาร เพราะ G7e ไม่อยู่ในรายชื่อ ภาพรวมเครื่อง GPU ใกล้ไทยอ่านต่อได้ที่ GPU Cloud ในไทย
ทำไม Lambda GPU Managed Instances จึงสำคัญ
GPU ราคาแพงและมักถูกใช้ไม่เต็ม AWS ยกตัวอย่างว่างาน inference เล็ก ๆ งานเดียวอาจใช้ GPU ไม่ถึงส่วนใหญ่ของเครื่อง แต่ต้องจ่ายเต็มเครื่อง การให้หลายคำขอใช้ GPU เดียวกันและลดเครื่องเหลือศูนย์ได้จึงตอบปัญหาต้นทุนโดยตรง
AWS วางตำแหน่งฟีเจอร์นี้ไว้สำหรับ inference ของโมเดลที่องค์กรสร้างหรือเลือกเอง ไม่ใช่การฝึกโมเดล งานที่ใช้ foundation model ให้ไปที่ Amazon Bedrock ส่วนการฝึกโมเดลให้ใช้ Amazon SageMaker AI ฟังก์ชัน GPU ยังทำงานร่วมกับ Lambda MicroVMs ได้ ตัวอย่างของ AWS คือให้ MicroVM รันโค้ดของเอเจนต์บน CPU แล้วเรียกฟังก์ชัน GPU เพื่อ inference
สิ่งที่องค์กรไทยควรทำก่อนใช้ Lambda GPU Managed Instances
- เลือกงานที่เหมาะ: งานที่เกิดเป็นช่วงจากเหตุการณ์ เช่น อ่านเอกสารหรือแปลงเสียงเป็นข้อความเมื่อมีไฟล์ใหม่ใน S3 เหมาะกว่างานที่ใช้ GPU เต็มเวลา
- ขอโควตาล่วงหน้า: ยื่นขอ Running On-Demand G and VT instances ใน Region ที่จะใช้ก่อนเริ่มทดสอบ
- ตรวจ Region และที่ตั้งข้อมูล: Region ไทยยังไม่มีเครื่องที่รองรับ ถ้าข้อมูลเป็นข้อมูลส่วนบุคคล ให้ตรวจเงื่อนไขการส่งข้อมูลไปต่างประเทศตาม PDPA ก่อนใช้ Region อื่น
- คุมต้นทุน: ตั้ง MaxVCpuCount เปิด scale to zero และดูกราฟ GPU utilization ใน CloudWatch หลังเปิดใช้จริง
- ทดสอบหลายรุ่นเครื่อง: ใส่หลายตระกูลใน capacity provider เพื่อให้ Lambda สลับรุ่นเมื่อเครื่องไม่ว่าง แต่ระวังว่าอาจได้ GPU ที่หน่วยความจำมากกว่าที่ขอ
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
งาน AI ที่ใช้ GPU ต่อเนื่องทั้งวันเป็นอีกรูปแบบที่ต้องวางแผนต่างจากงานที่เกิดเป็นช่วงตามเหตุการณ์ GPU Server ของ THAI DATA CLOUD ใช้ NVIDIA Tesla T4 และ V100 สำหรับงาน AI, Deep Learning และการเรนเดอร์กราฟิก 3D พร้อมใช้งานได้ภายในไม่กี่นาที ใน Data Center มาตรฐาน ISO 27001 (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
ติดตามข่าวคลาวด์เพิ่มเติมได้ที่หมวดคลาวด์
ภาพบันทึก
คำถามที่พบบ่อย
Lambda GPU Managed Instances คืออะไร?
Lambda GPU Managed Instances คือความสามารถใหม่ของ AWS Lambda ที่ประกาศเมื่อ 18 พ.ย. 2026 ให้ Event Functions บน Lambda Managed Instances รันบนเครื่อง EC2 G-series ที่มี GPU ของ NVIDIA โดย Lambda ดูแลไดรเวอร์ GPU แพตช์ระบบ การตรวจสุขภาพเครื่อง และการขยายจำนวนเครื่องให้
Lambda GPU Managed Instances คิดเงินอย่างไร?
จ่ายสามส่วน คือราคา EC2 On-Demand ของเครื่อง GPU ที่ Lambda เปิดในบัญชี ค่าจัดการของ Lambda 9.75% ของราคาเครื่อง และค่าคำขอ 0.20 ดอลลาร์ต่อล้านคำขอ ส่วนลดจาก Compute Savings Plans และ Reserved Instances ใช้กับค่าเครื่องได้
ใช้ Lambda GPU Managed Instances ใน Region ไทยได้ไหม?
AWS ระบุว่าใช้ได้ในทุก Region เชิงพาณิชย์ที่มีทั้ง Lambda Managed Instances และเครื่อง G-series แต่หน้าเอกสาร EC2 ณ 19 พ.ย. 2026 ระบุว่า Region Asia Pacific (Thailand) มีเครื่องกลุ่ม Accelerated Computing เพียง G7e ซึ่งไม่อยู่ในรายชื่อเครื่องที่ฟีเจอร์นี้รองรับ
ทำไมเปิด Lambda GPU Managed Instances แล้วไม่ขึ้นเครื่อง?
สาเหตุที่ AWS เตือนไว้คือโควตา Running On-Demand G and VT instances ของ EC2 ตั้งต้นที่ 0 vCPU ต้องขอเพิ่มโควตาใน Service Quotas ก่อน และ capacity provider ต้องมีเครื่องที่หน่วยความจำ GPU ไม่น้อยกว่าค่า AcceleratorMemorySize ที่ตั้งไว้
แหล่งอ้างอิง
- AWS Lambda adds support for GPU instances on Lambda Managed Instances — Amazon Web Services
- AWS Lambda now supports GPU instances for Event Functions on Lambda Managed Instances — Amazon Web Services
- Run GPU-accelerated Event Functions on Lambda Managed Instances — Amazon Web Services
- AWS Lambda Pricing — Amazon Web Services
- Amazon EC2 instance types by Region — Amazon Web Services
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- NVIDIA180AWS158Amazon102Hugging Face29Tesla131
- ผลิตภัณฑ์และเทคโนโลยี
- AWS Lambda7PyTorch16vLLM17SGLang12Amazon CloudWatch18Amazon EC211Amazon Bedrock14
- กฎหมายและมาตรฐาน
- PDPA349
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ