
เนื้อหาสนับสนุน สนับสนุนโดย THAI DATA CLOUDหมายความว่าอย่างไร
CloudเปรียบเทียบT4 กับ V100 เลือก GPU รุ่นไหนบน THAI DATA CLOUD หลัง CUDA 13 เลิกรองรับ Volta
T4 กับ V100 ต่างกันที่หน่วยความจำ งานทศนิยมสองเท่า และการรองรับ CUDA 13 GPU Server ของ THAI DATA CLOUD ให้เช่าทั้งสองรุ่น เริ่ม 33,210 และ 139,730 บาทต่อเดือน
โดย กองบรรณาธิการ THAI DATA อ่าน 7 นาที
สรุปประเด็นสำคัญ
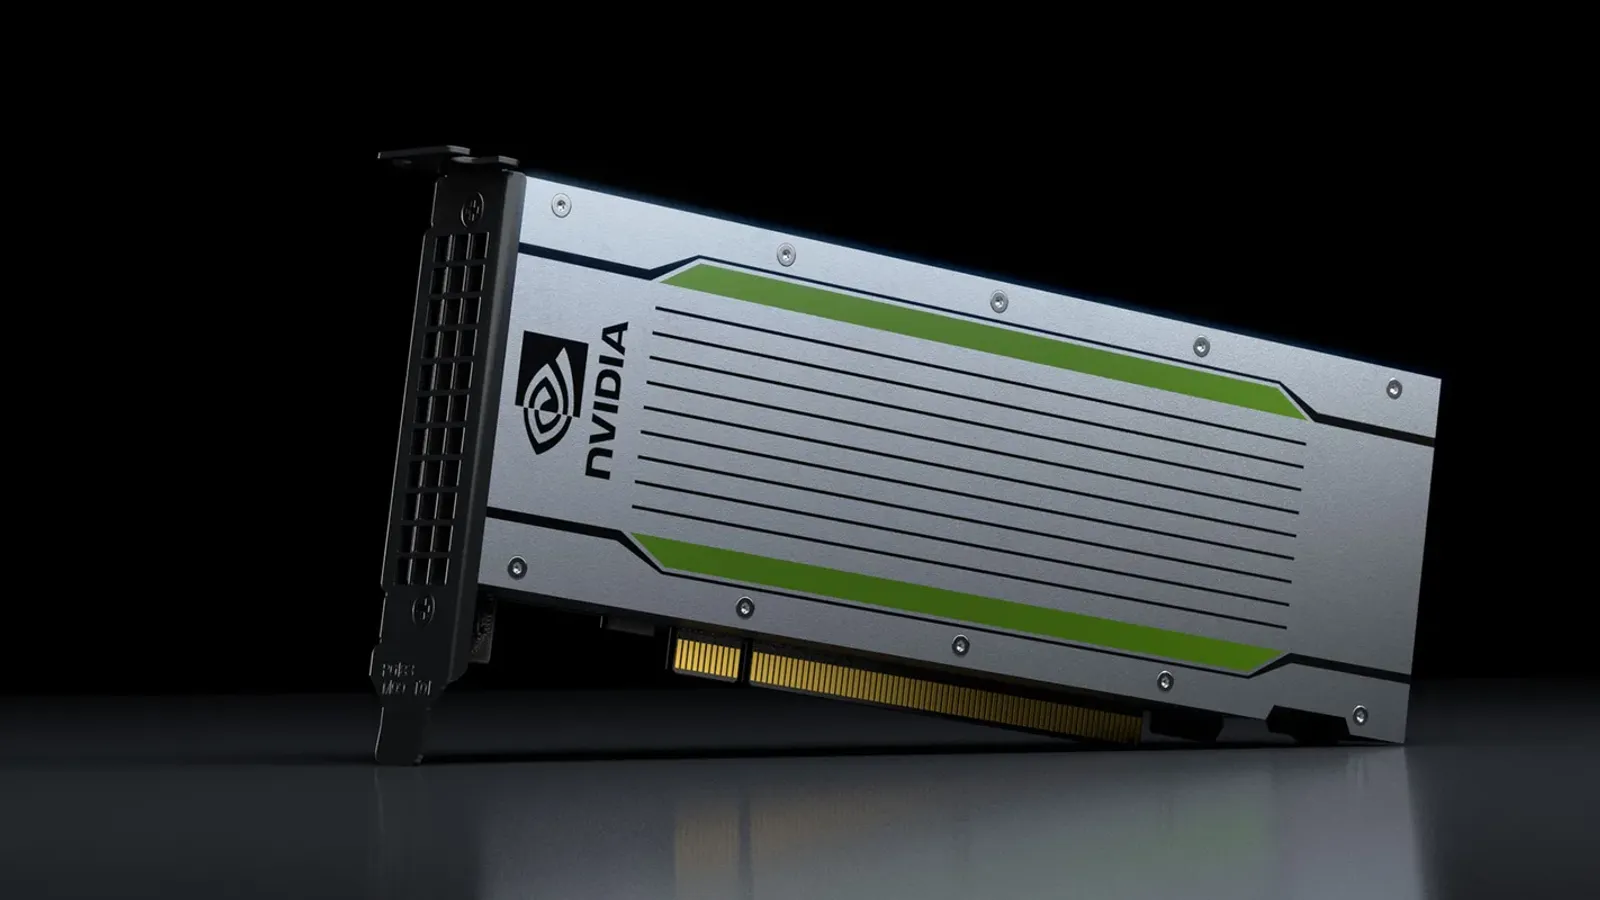
- ไลบรารี cuFFT และ cuSPARSE ใน CUDA 13.0 ตัดการรองรับ GPU สถาปัตยกรรม Maxwell, Pascal และ Volta ซึ่งรวม V100 ส่วน T4 เป็น Turing ที่ NVIDIA ยังจัดไว้ใน compute capability 7.5
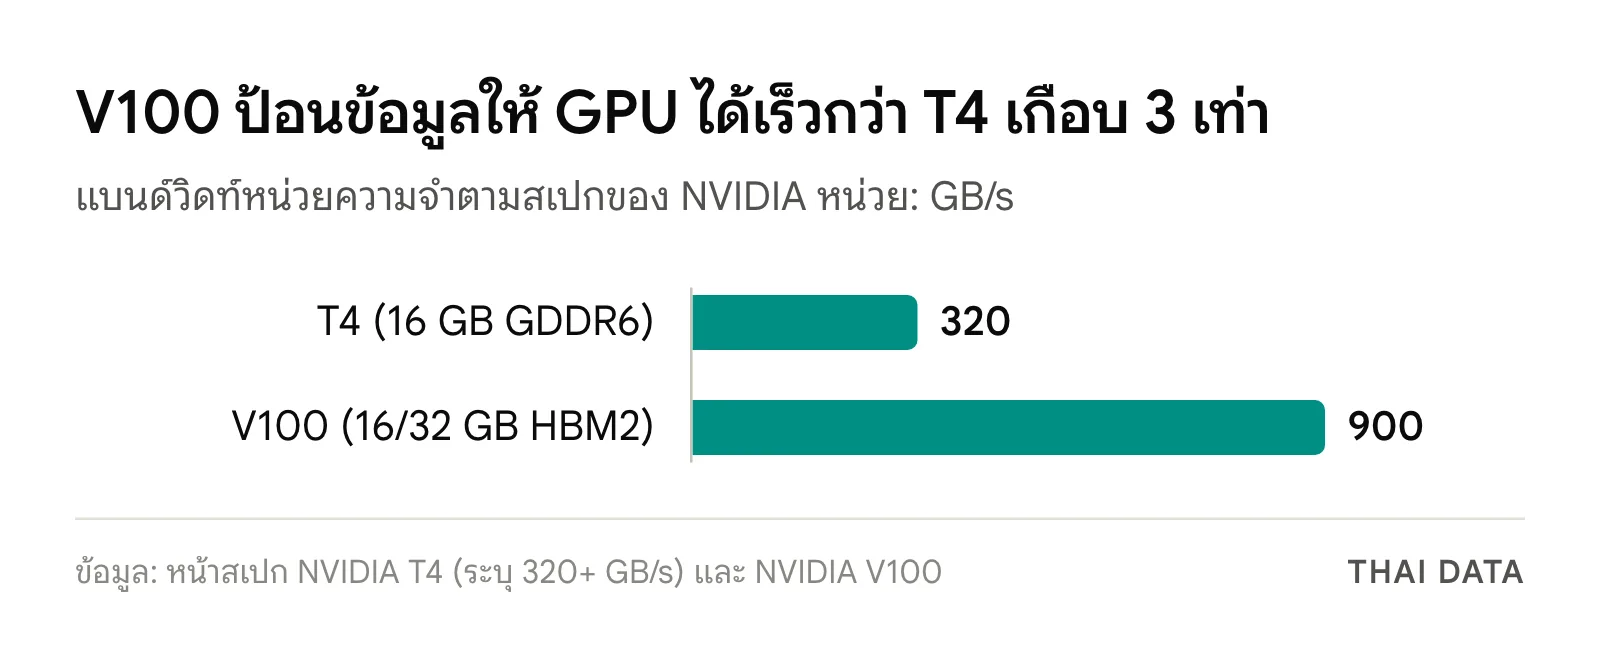
- T4 มีหน่วยความจำ 16 GB GDDR6 แบนด์วิดท์ 320+ GB/s กินไฟ 70 วัตต์ ทำ INT8 ได้ 130 TOPS เหมาะกับงาน Inference
- V100 มีหน่วยความจำ 16 หรือ 32 GB HBM2 แบนด์วิดท์ 900 GB/s และคำนวณทศนิยมสองเท่าได้ 7–7.8 TFLOPS ตามรุ่น เหมาะกับการฝึกโมเดลและงาน HPC
- GPU Server ของ THAI DATA CLOUD รุ่น T4 เริ่ม 33,210 บาทต่อเดือน (RAM 32GB / 8 vCPU) และรุ่น V100 เริ่ม 139,730 บาทต่อเดือน (RAM 64GB / 8 vCPU) ยังไม่รวม VAT
T4 กับ V100 คือ GPU ระดับ Data Center ของ NVIDIA สองรุ่นที่ GPU Server ของ THAI DATA CLOUD ให้เช่า T4 เน้นงาน Inference ราคาเริ่ม 33,210 บาทต่อเดือน ส่วน V100 เน้นการฝึกโมเดลและงานคำนวณทศนิยมสองเท่า เริ่ม 139,730 บาทต่อเดือน และตั้งแต่ CUDA 13.0 ไลบรารีของ NVIDIA ตัดการรองรับสถาปัตยกรรม Volta ของ V100 แล้ว
บทความนี้เป็นเนื้อหาสนับสนุนจาก THAI DATA CLOUD ซึ่งเป็นผู้ดำเนินงานเว็บไซต์ thaidata.co.th ขอบเขตบริการและราคามาจากหน้า GPU Server บน thaidata.cloud ณ วันที่ 4 พฤศจิกายน 2026 ส่วนสเปกของการ์ดและการรองรับของ CUDA มาจากหน้าผลิตภัณฑ์และเอกสารของ NVIDIA
CUDA 13 เปลี่ยนการเลือก T4 กับ V100 อย่างไร
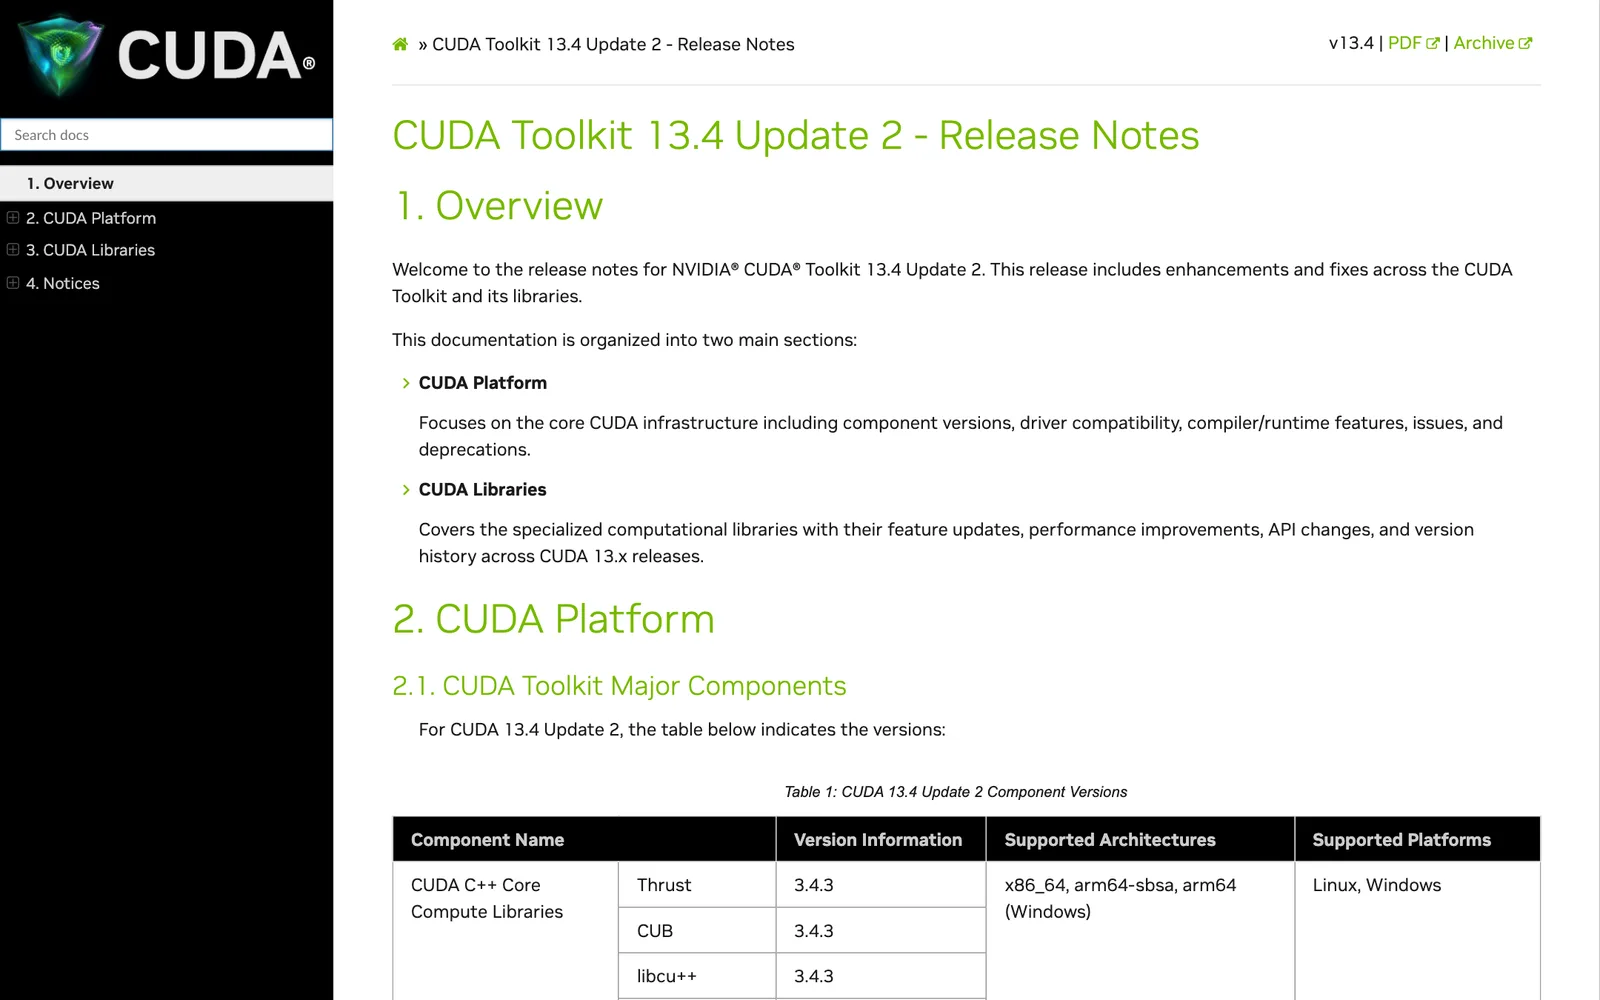
NVIDIA ปรับหน้า release notes ของ CUDA Toolkit 13.4 Update 2 ครั้งล่าสุดเมื่อ 12 ตุลาคม 2026 ในประวัติของไลบรารี cuFFT และ cuSPARSE รุ่น 13.0 ระบุตรงกันว่าตัดการรองรับ GPU สถาปัตยกรรม Maxwell, Pascal และ Volta คือ GPU ทุกรุ่นที่มี compute capability ต่ำกว่า Turing ส่วนหน้ารายชื่อ CUDA GPU Compute Capability ฉบับปัจจุบันไล่ลงไปถึง 7.5 ซึ่งมี T4 อยู่ และส่ง GPU รุ่นเก่ากว่าไปที่หน้า Legacy
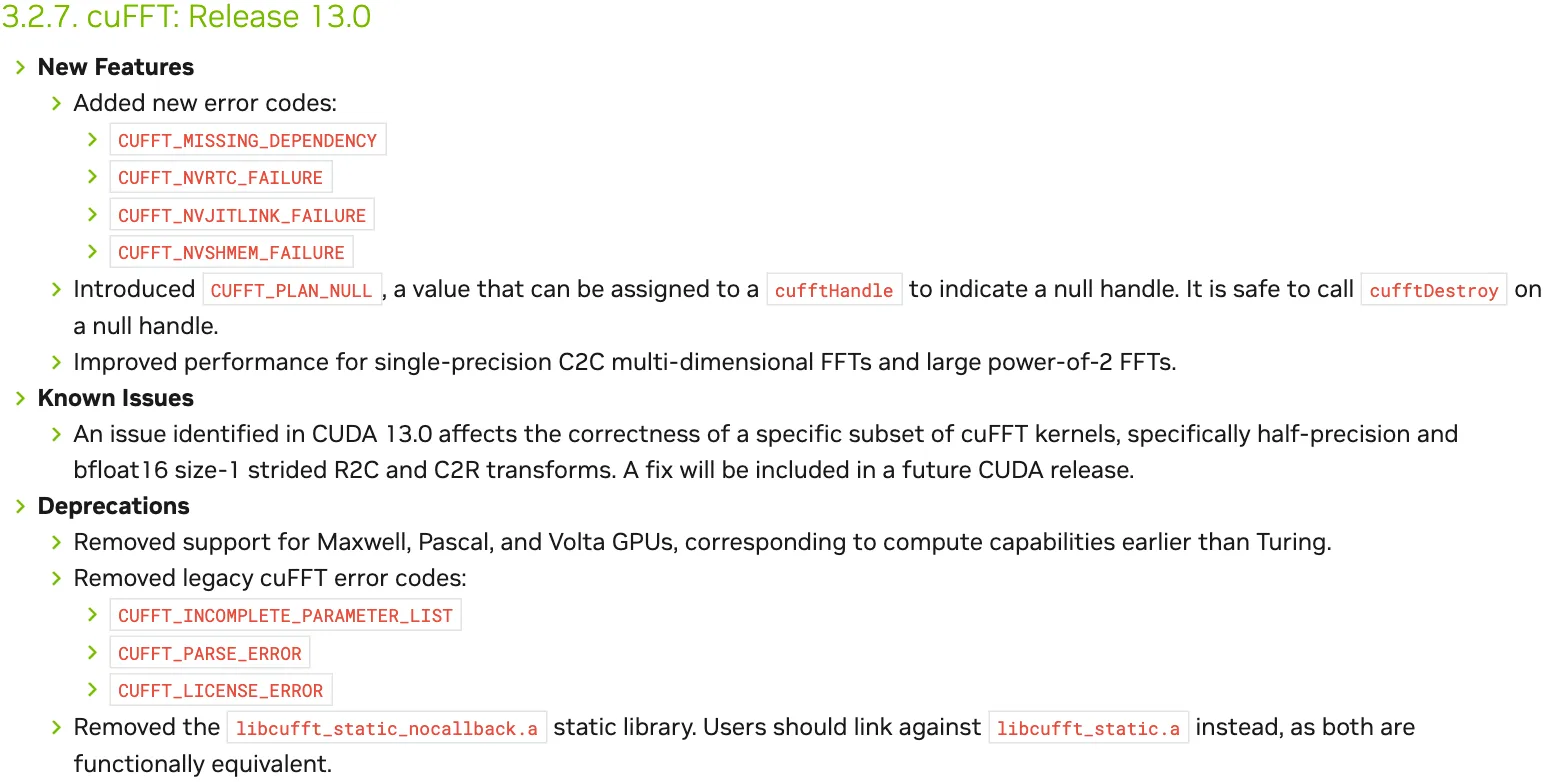
หน้าผลิตภัณฑ์ของ NVIDIA ระบุว่า V100 ใช้สถาปัตยกรรม Volta ส่วน T4 ใช้ Turing การเลือก T4 กับ V100 ในปี 2026 จึงไม่ได้ดูแค่ว่าตัวไหนแรงกว่า แต่ต้องดูว่าซอฟต์แวร์ของทีมจะอยู่บน CUDA รุ่นไหนด้วย
- โปรเจกต์ใหม่ ที่อยากใช้ CUDA 13 และไลบรารีรุ่นล่าสุด เลือก T4
- โค้ดเดิม ที่ทำงานบน CUDA ชุดก่อนรุ่น 13 อยู่แล้ว และต้องการหน่วยความจำ HBM2 หรือความเร็วทศนิยมสองเท่า เลือก V100 ได้ โดยตรึงไดรเวอร์ CUDA และเฟรมเวิร์กไว้ที่ชุดเดิม
- ทุกเครื่อง ต้องติดตั้งไดรเวอร์แยกจาก CUDA Toolkit เพราะ NVIDIA เลิกรวมไดรเวอร์ไว้ในชุดติดตั้งบน Windows ตั้งแต่ CUDA 13.1 และบน Linux ตั้งแต่ CUDA 13.4
องค์กรที่กำลังเทียบแหล่งเช่า GPU ใกล้ไทยอ่านภาพรวมเพิ่มได้ที่GPU Cloud ในไทย
สเปก T4 กับ V100 ตามตัวเลขของ NVIDIA
ตัวเลขด้านล่างมาจากหน้าผลิตภัณฑ์ของ NVIDIA โดย V100 มีสองแบบ คือการ์ด PCIe และโมดูลสำหรับ NVLink ซึ่งให้ตัวเลขต่างกันเล็กน้อย
| สเปก | T4 | V100 (PCIe / NVLink) |
|---|---|---|
| สถาปัตยกรรม | Turing | Volta |
| หน่วยความจำ | 16 GB GDDR6 | 16 หรือ 32 GB HBM2 |
| แบนด์วิดท์หน่วยความจำ | 320+ GB/s | 900 GB/s |
| ทศนิยมสองเท่า (FP64) | หน้าสเปกไม่ระบุ | 7 / 7.8 TFLOPS |
| ทศนิยมเดี่ยว (FP32) | 8.1 TFLOPS | 14 / 15.7 TFLOPS |
| งาน Deep Learning | FP16 65 TFLOPS, INT8 130 TOPS, INT4 260 TOPS | 112 / 125 TFLOPS |
| กำลังไฟสูงสุด | 70 วัตต์ | 250 / 300 วัตต์ |
| การเชื่อมต่อ | PCIe Gen3 x16 | PCIe 32 GB/s หรือ NVLink 300 GB/s |
| CUDA 13 | รองรับ | ไลบรารีตัดการรองรับ Volta |
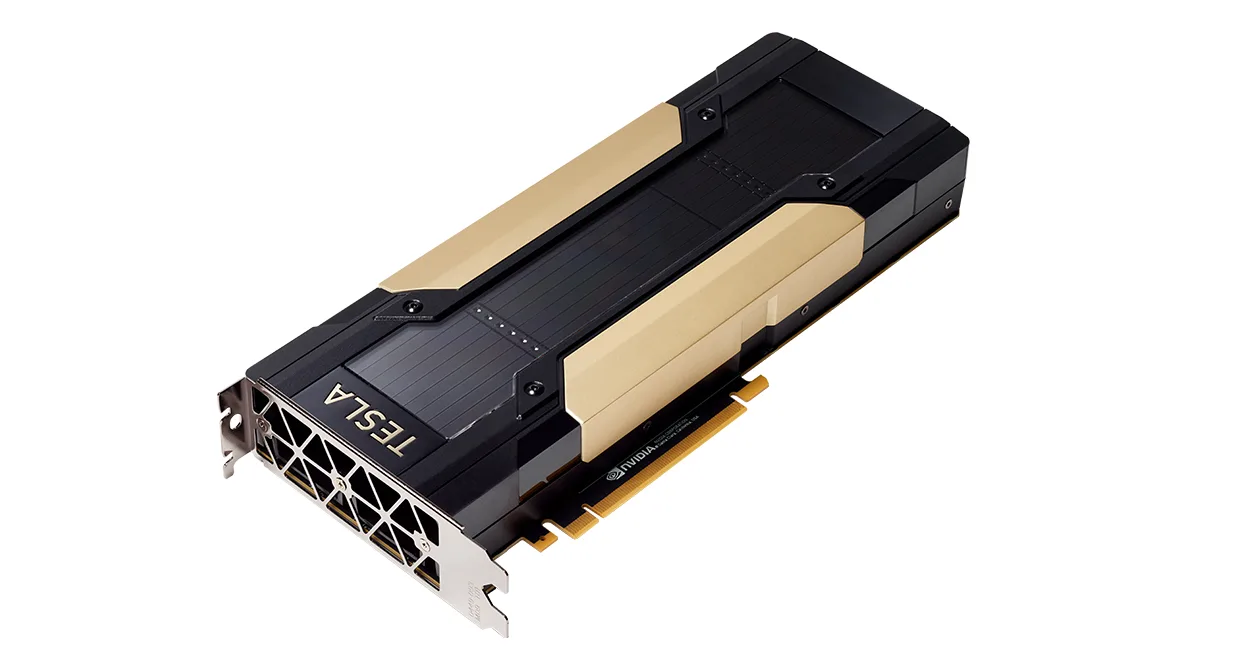
ความต่างที่เห็นชัดที่สุดของ T4 กับ V100 อยู่ที่หน่วยความจำ V100 ใช้ HBM2 ที่ป้อนข้อมูลให้ GPU ได้ 900 GB/s เกือบสามเท่าของ T4 จึงได้เปรียบในงานฝึกโมเดลที่ต้องย้ายข้อมูลจำนวนมากเข้าออกหน่วยความจำตลอดเวลา
ส่วน T4 ชนะเรื่องขนาดและพลังงาน การ์ดใช้ไฟ 70 วัตต์ในรูปแบบ PCIe ขนาดเล็ก และมี Tensor Core ของ Turing ที่ทำงานได้ตั้งแต่ FP32, FP16 ไปจนถึง INT8 และ INT4 ซึ่งเป็นความแม่นยำที่งาน Inference ใช้กันมาก
งานแบบไหนเหมาะกับ T4 กับ V100
หน้า GPU Server ของ THAI DATA CLOUD แบ่งไว้ว่า T4 เหมาะกับ AI inference, Deep Learning ขนาดกลาง และงานภาพและวิดีโอ ส่วน V100 ออกแบบมาเพื่อฝึก AI ที่ซับซ้อน Deep Learning ขนาดใหญ่ และงาน HPC ตารางนี้ขยายการเลือก T4 กับ V100 ตามงานจริง
| งาน | รุ่นที่เหมาะ | เหตุผลจากสเปก |
|---|---|---|
| Inference จำแนกภาพ ถอดเสียง หรือแชตบอตที่โมเดลพอดีกับ 16 GB | T4 | INT8 130 TOPS และ INT4 260 TOPS ราคาเริ่มต้นต่ำกว่า |
| วิเคราะห์วิดีโอจากกล้องหลายตัว | T4 | NVIDIA ระบุว่า T4 ถอดรหัสวิดีโอ Full HD ได้สูงสุด 38 สตรีม |
| ฝึกโมเดล Deep Learning ขนาดใหญ่ | V100 | HBM2 900 GB/s และ Tensor Core 112–125 TFLOPS |
| จำลองโมเลกุลหรืองานวิทยาศาสตร์ที่ต้องการความแม่นยำสองเท่า | V100 | FP64 7–7.8 TFLOPS |
| งานที่กระจายหลายเครื่อง | ทั้งสองรุ่น | เครือข่าย GPU Direct ผ่าน RDMA ของบริการ 100 Gbit/s |
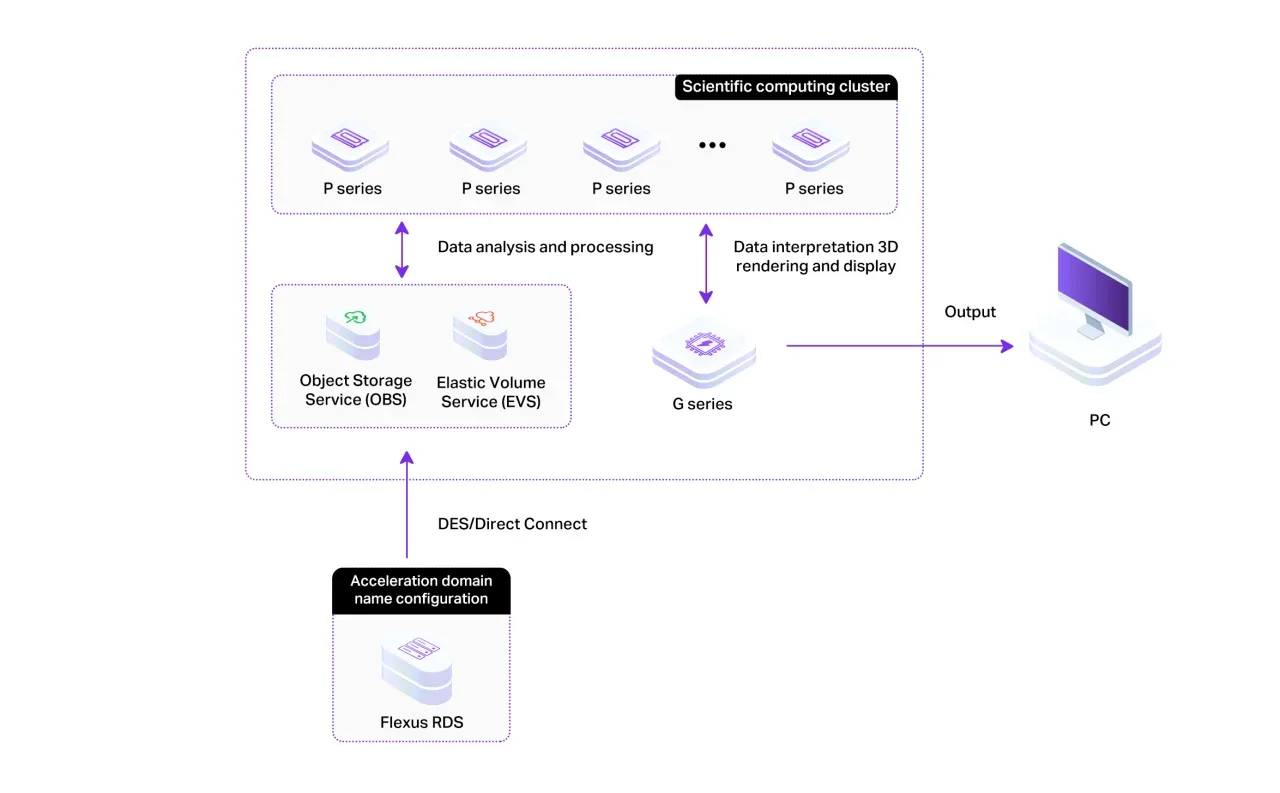
งานคำนวณทางวิทยาศาสตร์คือจุดที่ T4 กับ V100 ห่างกันมากที่สุด หน้าสเปกของ T4 ไม่ได้ให้ตัวเลข FP64 เลย ขณะที่ V100 ทำได้ 7–7.8 TFLOPS ทีมวิจัยที่จำลองโมเลกุลหรือระดับอะตอมจึงควรเริ่มที่ V100
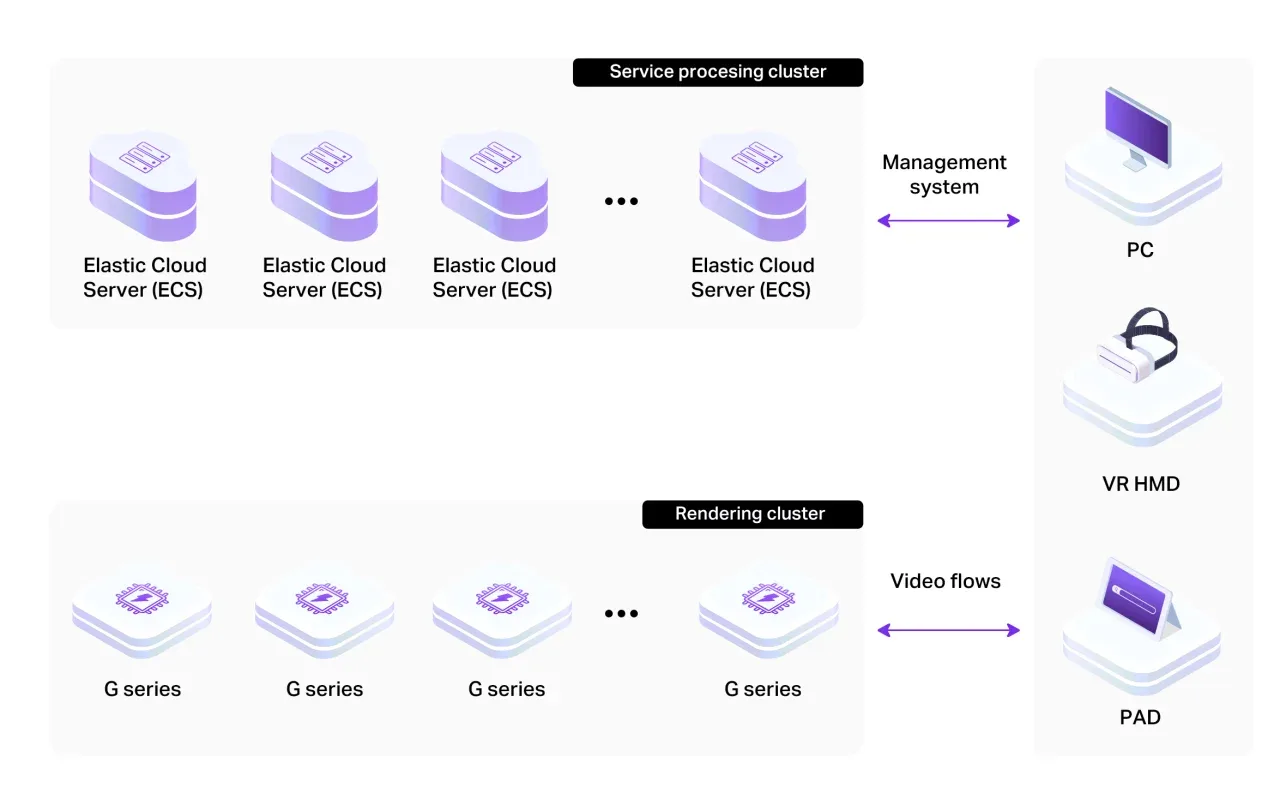
งานเรนเดอร์ 3D, CAD และ Graphic Workstation บนคลาวด์ หน้าเว็บจัดเป็นอีกรูปแบบการใช้งานหนึ่ง ทีมออกแบบทำงานจากที่ไหนก็ได้โดยไม่ต้องมีเวิร์กสเตชันประจำโต๊ะ งานกลุ่มนี้ควรให้ทีมวิศวกรประเมินรุ่นการ์ดจากโปรแกรมที่ใช้จริงก่อน
ตอบ 4 คำถามนี้ก่อนตัดสินใจ
ทีมที่ยังตัดสินใจไม่ได้ระหว่าง T4 กับ V100 ตอบคำถามสี่ข้อนี้ก่อนขอใบเสนอราคา คำตอบส่วนใหญ่ชี้รุ่นที่เหมาะได้เอง
- โมเดลและข้อมูลต่อรอบใช้หน่วยความจำ GPU เท่าไร ถ้าไม่เกิน 16 GB รวมพื้นที่สำหรับ batch แล้ว T4 รับได้ ถ้าเกินต้องดู V100 แบบ 32 GB
- งานต้องการความแม่นยำระดับไหน งานที่ต้องใช้ FP64 เช่น การจำลองทางฟิสิกส์ ควรใช้ V100 ส่วนงานที่รันด้วย FP16, INT8 หรือ INT4 ได้ T4 ตอบโจทย์
- เฟรมเวิร์กที่ใช้สร้างบน CUDA รุ่นไหน ถ้าต้องอยู่บน CUDA 13 ขึ้นไป เลือก T4 ได้ทางเดียว
- ต้องใช้ GPU นานแค่ไหน งานฝึกโมเดลที่ใช้ไม่กี่สัปดาห์เช่า V100 เป็นช่วงแล้วลดสเปกลงได้ งาน Inference ที่รันทั้งปีควรคิดค่าใช้จ่ายระยะยาวของ T4 ก่อน
ราคาเช่า T4 กับ V100 บน GPU Server ของ THAI DATA CLOUD
| รุ่น | สเปกเริ่มต้นของเซิร์ฟเวอร์ | ราคาเริ่มต้น |
|---|---|---|
| NVIDIA Tesla T4 | RAM 32GB / 8 vCPU | 33,210 บาท/เดือน |
| NVIDIA Tesla V100 | RAM 64GB / 8 vCPU | 139,730 บาท/เดือน |
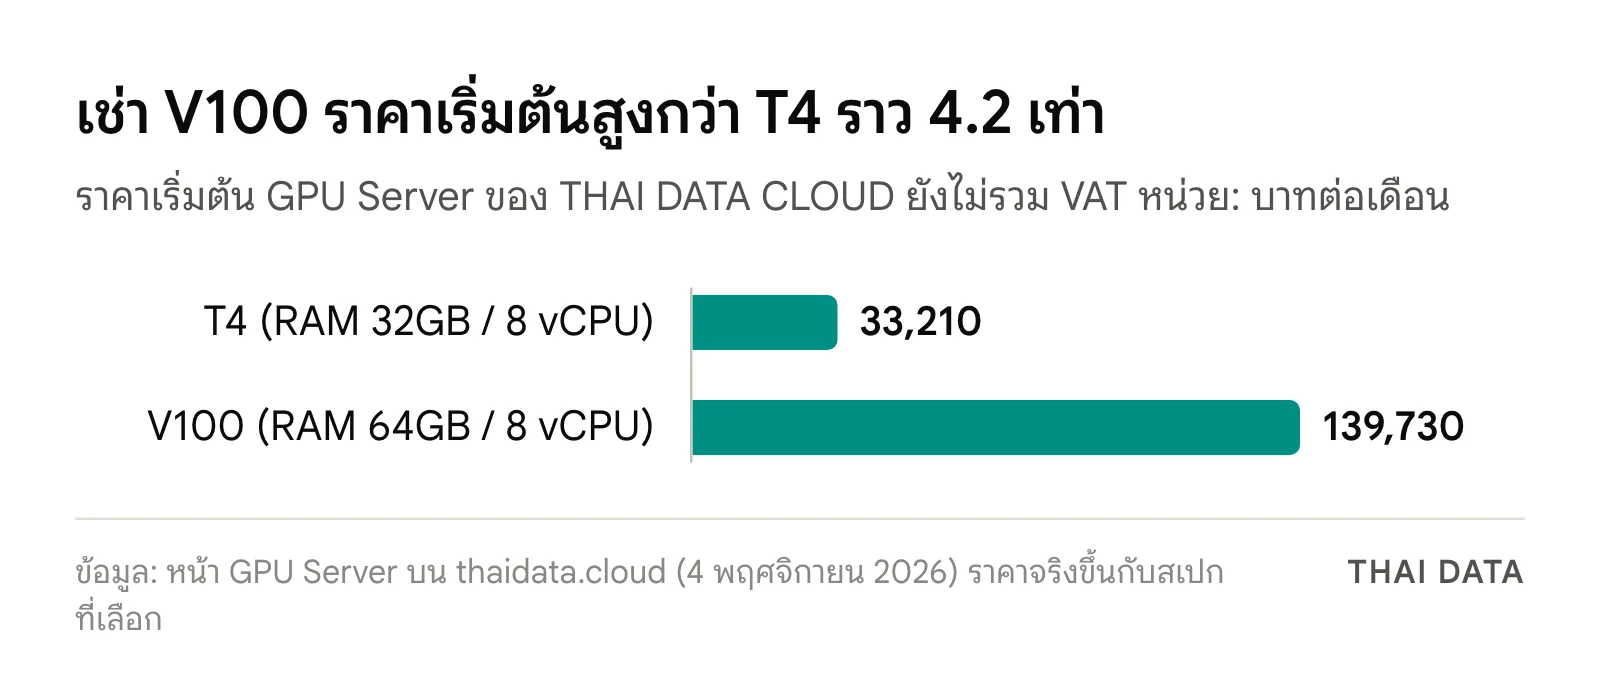
ราคาทั้งสองรุ่นเป็นราคาเริ่มต้นต่อเดือนที่ยังไม่รวมภาษีมูลค่าเพิ่ม สเปกและราคาจริงขึ้นกับการกำหนดค่าที่เลือก ตัวเลข RAM และ vCPU ในตารางเป็นของเซิร์ฟเวอร์ ไม่ใช่หน่วยความจำของ GPU และหน้าเว็บไม่ได้ระบุว่า V100 เป็นแบบ 16 หรือ 32 GB หรือมี GPU กี่ตัวต่อเครื่อง จึงควรถามสองข้อนี้ตอนขอใบเสนอราคา ส่วนต่างราคาของ T4 กับ V100 ราว 4.2 เท่าจึงคุ้มก็ต่อเมื่องานต้องใช้หน่วยความจำ HBM2 หรือ FP64 จริง
สิ่งที่หน้า GPU Server ระบุว่ามาพร้อมบริการ
- เครือข่าย GPU Direct ผ่าน RDMA แบนด์วิดท์ 100 Gbit/s และ Latency 2 µs สำหรับงานที่กระจายหลายเครื่อง
- สตอเรจ NVMe SSD สูงสุด 680,000 IOPS ป้อนข้อมูลให้ GPU ได้ทัน
- ระบบปฏิบัติการ เลือก CentOS, Ubuntu หรือ EulerOS ระบบติดตั้งให้อัตโนมัติ
- ความปลอดภัย เข้ารหัสข้อมูลทั้งขณะจัดเก็บและระหว่างรับส่ง บน Data Center มาตรฐาน ISO/IEC 27001 และ ISO 22301 ระดับ TIA-942 Tier 3+ ในไทย
- การดูแล Uptime SLA 99.9% และทีมวิศวกรคนไทยดูแลตลอด 24 ชั่วโมง ทุกวัน
- ปรับขนาด อัปเกรดหรือดาวน์เกรดผ่าน Cloud Console ได้ตามรอบงาน
เช่า T4 กับ V100 หรือซื้อการ์ดมาตั้งเอง
การซื้อ GPU ระดับ Data Center มาใช้เองต้องจ่ายค่าการ์ด เซิร์ฟเวอร์ ไฟฟ้า ระบบระบายความร้อน และคนดูแลตั้งแต่วันแรก ขณะที่งาน AI จำนวนมากใช้ GPU หนักเป็นช่วง ๆ เช่น ช่วงฝึกโมเดล แล้วใช้น้อยลงตอนให้บริการ
| ประเด็น | ซื้อ GPU มาตั้งเอง | เช่า GPU Server |
|---|---|---|
| เงินลงทุนเริ่มต้น | จ่ายค่าฮาร์ดแวร์ทั้งหมดก่อน | จ่ายรายเดือน |
| เวลาเริ่มใช้งาน | รอสั่งซื้อ ขนส่ง และติดตั้ง | สร้างเครื่องผ่าน Cloud Console ในไม่กี่นาที |
| ปรับขนาด | ต้องซื้อเพิ่ม ลดขนาดไม่ได้ | อัปเกรดหรือดาวน์เกรดได้ |
| ไฟฟ้า ความเย็น และการดูแล | องค์กรรับเอง | รวมอยู่ใน Data Center Tier 3+ |
| ความเสี่ยงตกรุ่น | องค์กรรับเอง | เปลี่ยนรุ่นได้ตามบริการ |
เรื่องตกรุ่นเห็นได้ชัดจากกรณี CUDA 13 ข้างต้น การ์ดที่ซื้อมาแล้วอยู่กับองค์กรไปจนคืนทุน ส่วนการเช่าเปลี่ยนรุ่นได้เมื่อซอฟต์แวร์เดินหน้าต่อ อย่างไรก็ดี หน้าเว็บเองระบุว่าการซื้ออาจคุ้มกว่าถ้าใช้ GPU เต็มกำลังต่อเนื่องหลายปี ทีมช่วยคำนวณเทียบค่าเช่า T4 กับ V100 กับค่าซื้อเครื่องเองให้ตามลักษณะงานจริงได้
เริ่มเช่า GPU Server ใน 4 ขั้นตอน
- เลือกรุ่นและสเปก เลือกระหว่าง T4 กับ V100 จาก Cloud Console หรือให้ทีมขายช่วยประเมินขนาดงาน
- เลือกระบบปฏิบัติการ CentOS, Ubuntu หรือ EulerOS ระบบติดตั้งให้อัตโนมัติ
- ติดตั้งเครื่องมือ AI ติดตั้งไดรเวอร์ CUDA และเฟรมเวิร์ก เช่น TensorFlow หรือ PyTorch ถ้าใช้ V100 ให้เลือก CUDA ชุดก่อนรุ่น 13
- ปรับขนาดตามงาน อัปเกรดหรือดาวน์เกรด GPU เมื่อปริมาณงานเปลี่ยน
ขอใบเสนอราคาหรือปรึกษาเรื่องเลือก T4 กับ V100 ได้ฟรีที่หน้า GPU Server ของ THAI DATA CLOUD ซึ่งทีมจะติดต่อกลับภายใน 1 วันทำการหลังกรอกแบบฟอร์ม หรือโทร 098-894-2499, 082-653-2659 และ LINE @thaidatacloud
ติดตามข่าว Cloud, GPU และโครงสร้างพื้นฐาน AI อื่น ๆ ได้ที่หมวด Cloud
คำถามที่พบบ่อย
T4 กับ V100 ต่างกันอย่างไร?
T4 กับ V100 ต่างกันที่งานที่ออกแบบมา T4 เป็นการ์ด Turing ขนาดเล็ก กินไฟ 70 วัตต์ หน่วยความจำ 16 GB GDDR6 เน้นงาน Inference ส่วน V100 เป็นการ์ด Volta หน่วยความจำ HBM2 16 หรือ 32 GB แบนด์วิดท์ 900 GB/s และคำนวณทศนิยมสองเท่าได้ 7–7.8 TFLOPS จึงเหมาะกับการฝึกโมเดลและงาน HPC
CUDA 13 ใช้กับ V100 ได้ไหม?
NVIDIA ระบุใน release notes ว่าไลบรารี cuFFT และ cuSPARSE ของ CUDA 13.0 ตัดการรองรับ GPU Maxwell, Pascal และ Volta แล้ว V100 เป็น Volta งานบน V100 จึงควรอยู่กับ CUDA ชุดก่อนรุ่น 13 ส่วน T4 เป็น Turing ที่ CUDA 13.4 ซึ่งเป็นรุ่นล่าสุดยังรองรับ
เช่า GPU T4 กับ V100 ราคาเท่าไร?
หน้า GPU Server ของ THAI DATA CLOUD ณ 4 พฤศจิกายน 2026 ระบุ T4 เริ่ม 33,210 บาทต่อเดือน (RAM 32GB / 8 vCPU) และ V100 เริ่ม 139,730 บาทต่อเดือน (RAM 64GB / 8 vCPU) ราคายังไม่รวมภาษีมูลค่าเพิ่ม และราคาจริงขึ้นกับสเปกที่เลือก
งาน Inference ควรเลือก T4 หรือ V100?
ถ้าโมเดลพอดีกับหน่วยความจำ 16 GB เช่น จำแนกภาพ ถอดเสียง หรือวิเคราะห์วิดีโอ T4 คุ้มกว่า เพราะราคาเริ่มต้นราวหนึ่งในสี่ของ V100 และรองรับ INT8 กับ INT4 ส่วนโมเดลที่ใหญ่เกิน 16 GB หรือต้องฝึกโมเดลเองจึงค่อยพิจารณา V100
แหล่งอ้างอิง
- GPU Server เช่า GPU Cloud Server NVIDIA — THAI DATA CLOUD
- CUDA Toolkit 13.4 Update 2 - Release Notes — NVIDIA
- CUDA GPU Compute Capability — NVIDIA Developer
- NVIDIA T4 Tensor Core GPU for AI Inference — NVIDIA
- NVIDIA V100 — NVIDIA
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- ผลิตภัณฑ์และเทคโนโลยี
- Windows111Linux124Ubuntu69PyTorch13LINE56
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ