
Amazon Redshift สร้าง materialized view เป็นตาราง Iceberg ให้ Athena และ Spark อ่านร่วมกัน
AWS ให้ Amazon Redshift สร้างและ refresh materialized view ที่เก็บเป็นตาราง Iceberg ตั้งแต่ 5 ต.ค. 2026 ให้ Athena, Spark และเอนจินอื่นอ่านผลคำนวณชุดเดียวกัน
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- AWS ประกาศเมื่อ 5 ตุลาคม 2026 ให้ Amazon Redshift สร้าง materialized view ด้วยคำสั่ง
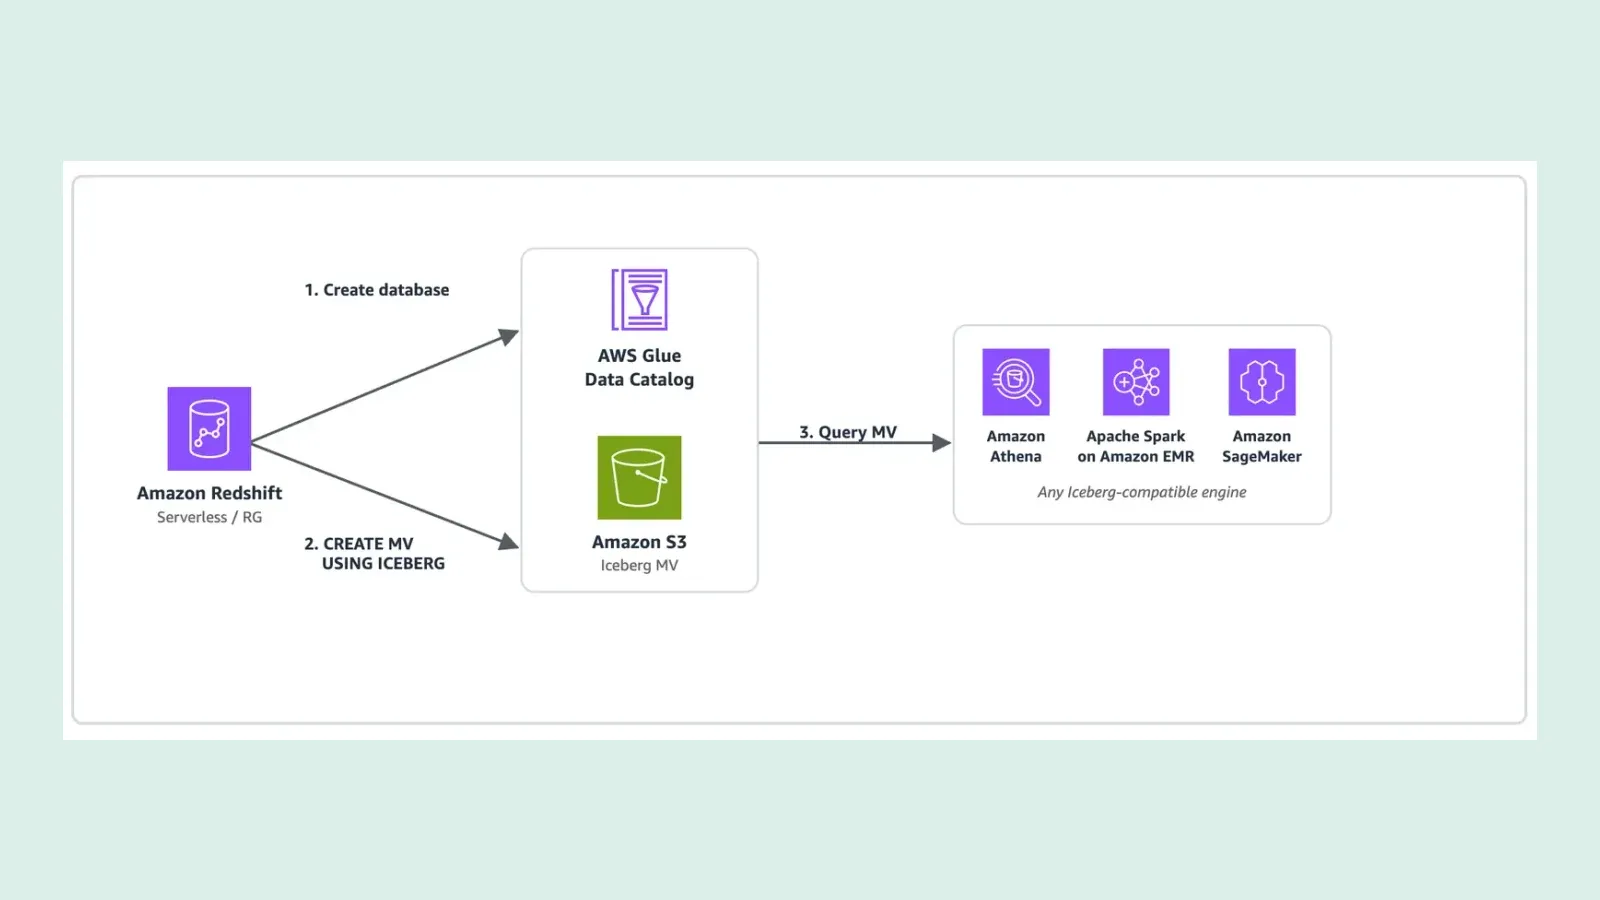
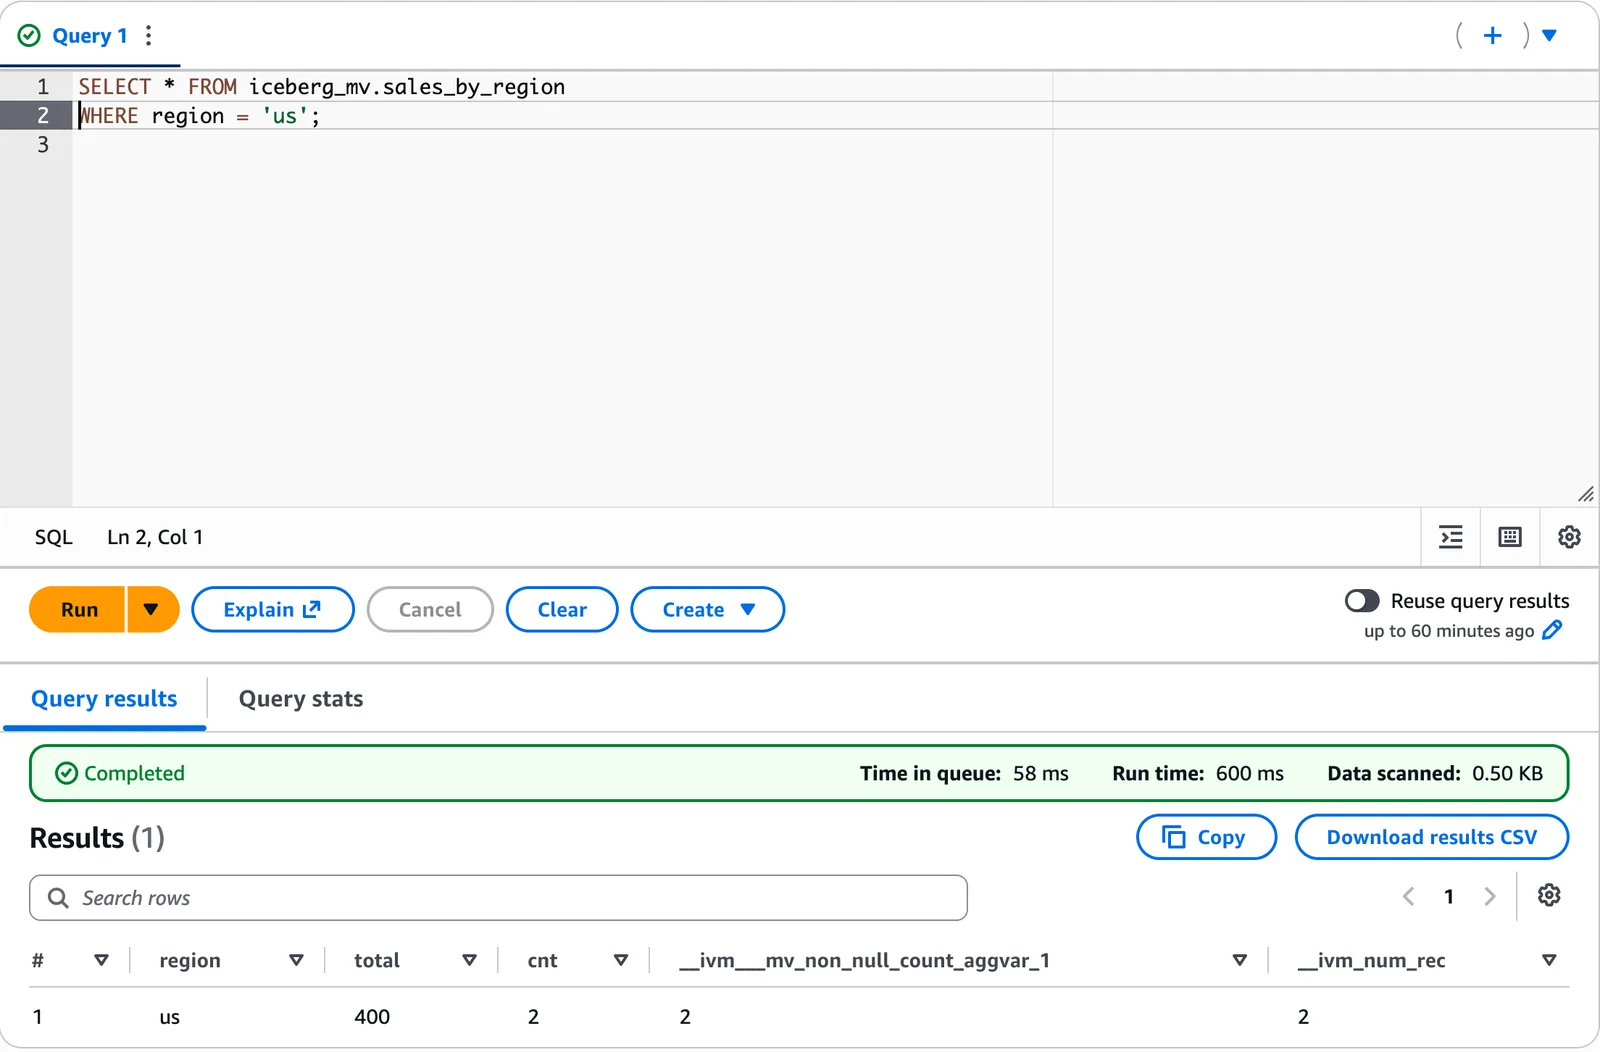
CREATE MATERIALIZED VIEW ... USING ICEBERGผลลัพธ์เก็บเป็นตาราง Iceberg บน Amazon S3 หรือ S3 Table Buckets - ตาราง Iceberg ที่ได้ลงทะเบียนใน AWS Glue Data Catalog ทำให้ Amazon Athena, Apache Spark บน Amazon EMR, Trino และเอนจินอื่นที่รองรับ Iceberg อ่านได้โดยไม่ต้องคัดลอกข้อมูล
- ใช้ได้บน Redshift Serverless และคลัสเตอร์ RG ที่ใช้ซีพียู Graviton เท่านั้น เครื่องแบบ RA3 และ DC2 ไม่รองรับ และต้องสั่ง refresh เอง ยังไม่มี autorefresh
- ในสถานการณ์ตัวอย่างของ AWS ค่า compute ต่อเดือนลดจากราว 7,500 ดอลลาร์ เมื่อ 4 เอนจินคำนวณซ้ำกัน เหลือราว 1,500 ดอลลาร์ เมื่อคำนวณครั้งเดียว
- ยังไม่รองรับการคุมสิทธิ์ระดับแถวและคอลัมน์ (fine-grained access control) บน Iceberg materialized view และตารางต้นทางต้องเป็น Iceberg ใน region และบัญชีเดียวกัน
AWS ประกาศเมื่อวันที่ 5 ตุลาคม 2026 (ตามเวลาสหรัฐฯ) ให้ Amazon Redshift สร้างและ refresh materialized view ที่เก็บผลลัพธ์เป็นตาราง Apache Iceberg บน Amazon S3 หรือ S3 Table Buckets ได้ ผลที่ Redshift คำนวณไว้ครั้งเดียวจึงให้ Amazon Athena, Apache Spark บน Amazon EMR และเอนจินอื่นที่รองรับ Iceberg อ่านต่อได้ทันทีโดยไม่ต้องคัดลอกข้อมูล
ประกาศใน What's New ของ AWS ระบุว่าเอนจินภายนอกอย่าง Trino หรือ Snowflake ก็อ่านผลนี้ได้ และเปิดให้ใช้ในทุก region ที่มี Redshift Serverless กับเครื่อง Graviton แบบ provisioned
Amazon Redshift เพิ่มอะไรให้ materialized view
materialized view คือผลคำนวณของ query ที่เก็บไว้ล่วงหน้า เหมาะกับ join และ aggregation ที่หนักและถูกเรียกซ้ำบ่อย เดิม Amazon Redshift เก็บผลไว้ใน Redshift Managed Storage (RMS) ซึ่งอ่านได้เฉพาะจาก Redshift ความสามารถใหม่เพิ่มคำว่า USING ICEBERG ในคำสั่ง CREATE MATERIALIZED VIEW เดิม
เอกสารของ AWS อธิบายว่าเมื่อสร้าง view แบบนี้ Redshift จะทำสามอย่าง คือรัน query แล้วเขียนผลเป็นไฟล์ Parquet บน S3 ลงทะเบียนตารางพร้อม metadata แบบ Iceberg ใน AWS Glue Data Catalog และเก็บนิยามของ view กับสถานะการ refresh ไว้ใน Glue ทำให้ view ไม่ผูกกับคลัสเตอร์ที่สร้าง คลัสเตอร์หรือ workgroup อื่นที่มีสิทธิ์ IAM ก็ refresh ได้
ความสามารถนี้ใช้ได้เฉพาะบน Redshift Serverless และคลัสเตอร์ provisioned แบบ RG ที่ AWS เปิดตัวในปี 2026 บนซีพียู Graviton ส่วนคลัสเตอร์ RA3 และ DC2 ใช้ไม่ได้ AWS อ้างว่า RG query ตาราง Iceberg ได้เร็วกว่า RA3 สูงสุด 2.4 เท่า ที่ราคาต่อ vCPU ต่ำกว่า 30%
Amazon Redshift refresh ข้อมูลอย่างไร
ทุกครั้งที่สั่ง REFRESH MATERIALIZED VIEW Redshift จะเทียบ snapshot ของตาราง Iceberg ต้นทางกับ snapshot ที่บันทึกไว้ตอน refresh ครั้งก่อน แล้วเลือกคำนวณเฉพาะส่วนที่เปลี่ยน (incremental refresh) หรือคำนวณใหม่ทั้งหมด
- คำนวณเฉพาะส่วนที่เปลี่ยน ได้กับ query ที่ใช้ SUM และ COUNT คู่กับ GROUP BY, query ที่ไม่มี aggregation และ inner join ระหว่างตาราง Iceberg
- คำนวณใหม่ทั้งหมด เมื่อใช้ DISTINCT, outer join, window function, subquery, UNION หรือ INTERSECT, ฟังก์ชันอย่าง MIN, MAX, AVG และ COUNT(DISTINCT) รวมถึงเมื่อ snapshot เดิมหมดอายุ หรือข้อมูลใน view ถูกแก้จากนอก Redshift
- ต้องสั่ง refresh เอง Iceberg materialized view ยังไม่รองรับ autorefresh
- ป้องกันการ refresh ชนกัน ถ้าหลายคลัสเตอร์สั่ง refresh พร้อมกัน Redshift ใช้กลไกอัปเดตแบบมีเงื่อนไขของ Glue ให้สำเร็จได้เพียงรายเดียว
view ที่ Amazon Redshift สร้าง มีเพียง Redshift ที่ refresh หรือลบได้ ส่วน view แบบ Iceberg ที่เอนจินอื่นอย่าง Spark สร้าง Redshift อ่านได้อย่างเดียว
เลือกใช้แบบไหนดี และคุ้มค่าแค่ไหน
AWS ย้ำว่า Iceberg materialized view ไม่ได้มาแทนแบบเดิม แต่ตอบโจทย์ต่างกัน
| ประเด็น | Materialized view แบบเดิม (RMS) | Iceberg materialized view |
|---|---|---|
| ที่เก็บผลลัพธ์ | Redshift Managed Storage | ตาราง Iceberg บน Amazon S3 หรือ S3 Table Buckets |
| ผู้อ่านผล | Amazon Redshift เท่านั้น | Redshift, Athena, Spark, SageMaker และเอนจินที่รองรับ Iceberg |
| เหมาะกับ | แดชบอร์ดที่ต้องตอบในระดับต่ำกว่าวินาที | ผลที่หลายทีมและหลายเอนจินใช้ร่วมกัน |
รูปแบบที่ AWS แนะนำคือสร้างชั้นข้อมูลเป็น Iceberg materialized view ให้ทุกเอนจินใช้ร่วมกัน แล้วโหลดผลที่ต้องการความเร็วสูงสุดเข้า RMS อีกชั้นสำหรับแดชบอร์ด
ด้านต้นทุน บล็อกของ AWS ยกสถานการณ์ตัวอย่าง aggregation ขนาดกลางที่รับข้อมูล 1 TB ได้ผล 100 GB และรันทุกวัน หากให้ Athena, Spark บน EMR, Redshift Serverless และเอนจินภายนอกต่างคนต่างคำนวณ ค่า compute รวมราว 7,500 ดอลลาร์สหรัฐต่อเดือน และตัวเลขที่ได้อาจมี 3–4 ชุดไม่ตรงกัน แต่ถ้าคำนวณครั้งเดียวเป็น Iceberg materialized view ค่า compute เหลือราว 1,500 ดอลลาร์ต่อเดือน AWS ระบุเองว่าเป็นตัวเลขประมาณการและผลจริงขึ้นกับงาน

ข้อจำกัดของ Amazon Redshift ที่ต้องรู้ก่อนใช้
เอกสารของ Amazon Redshift ระบุข้อจำกัดไว้หลายข้อ
- ตารางต้นทางต้องเป็น Iceberg และอยู่ใน region กับบัญชีเดียวกับ view ตารางแบบ Redshift native, Hive, Parquet, Delta Lake และ Hudi ใช้ไม่ได้ ตาราง Iceberg format version 3 ก็ยังใช้เป็นต้นทางไม่ได้
- นิยามของ view ห้ามใช้ UDF ฟังก์ชันที่ค่าเปลี่ยนตามเวลาอย่าง GETDATE และ RANDOM คำสั่ง ORDER BY, LIMIT, OFFSET และชื่อตารางหรือคอลัมน์ที่มีตัวพิมพ์ใหญ่
- ไม่รองรับ fine-grained access control และใช้ตารางที่ถูกกรองด้วย Lake Formation เป็นต้นทางไม่ได้ บล็อกของ AWS ระบุว่าสิทธิ์ผ่าน Lake Formation คุมได้แค่ระดับฐานข้อมูลและตาราง
- ไม่มี query rewrite อัตโนมัติ ไม่มี automated materialized view และไม่รองรับ CASCADE refresh
- ถ้าเก็บบน S3 bucket ทั่วไป Redshift ไม่ทำ compaction ให้ ไฟล์เล็กจะสะสมจากการ refresh จนอ่านช้าลง ส่วน S3 Table Buckets จัดการ compaction ให้อัตโนมัติ
- คำสั่ง DROP MATERIALIZED VIEW ลบเฉพาะรายการใน Glue ไฟล์ข้อมูลบน S3 ยังอยู่ ต้องลบเอง
ทำไมเรื่องนี้สำคัญ
แนวคิด "คำนวณครั้งเดียว ให้ทุกเอนจินใช้" กำลังเป็นทิศทางของ AWS เมื่อ 30 กันยายน 2026 AWS เพิ่งเปิด materialized view แบบ Iceberg ที่ AWS Glue เป็นผู้เขียนแต่เพียงผู้เดียว และในวันเดียวกันก็ให้ Aurora PostgreSQL query ข้อมูล Iceberg และ Parquet ใน data lake ได้โดยตรง ทั้งหมดชี้ไปที่การใช้ Iceberg เป็นรูปแบบกลางแทนการผูกข้อมูลไว้กับเอนจินเดียว
ช่องว่างที่ยังเหลือคือการคุมสิทธิ์ ค่ายอื่นอย่าง Databricks และ Snowflake เพิ่งเปิดให้แคตตาล็อกบังคับใช้นโยบายระดับแถวและคอลัมน์กับเอนจินภายนอก แต่ Iceberg materialized view ของ Redshift ยังไม่รองรับ fine-grained access control องค์กรที่มีข้อมูลอ่อนไหวจึงต้องออกแบบว่าอะไรควรอยู่ใน view ตั้งแต่ต้น
สิ่งที่องค์กรควรทำ
- ตรวจประเภทคลัสเตอร์ ทีมที่ยังใช้ RA3 หรือ DC2 ต้องย้ายงานไป Redshift Serverless หรือ RG ก่อน และตรวจว่า region ที่ใช้อยู่รองรับสองแบบนี้
- เริ่มจาก query ที่หลายทีมรันซ้ำ เช่น ยอดขายรายวันที่ทีมรายงานใช้ Athena และทีม data science ใช้ Spark คำนวณเอง ย้ายมาเป็น view เดียวเพื่อให้ตัวเลขตรงกันทั้งองค์กร
- วางรอบ refresh เอง เพราะไม่มี autorefresh ควรกำหนดรอบให้สัมพันธ์กับรอบโหลดข้อมูล และเขียน query ให้เข้าเงื่อนไข incremental refresh เพื่อลดค่า compute
- อย่าใส่ข้อมูลส่วนบุคคลดิบลงใน view ที่เปิดให้หลายทีม เมื่อยังคุมสิทธิ์ระดับแถวและคอลัมน์ไม่ได้ ควรรวมผลหรือตัดคอลัมน์ที่อยู่ในขอบเขต PDPA ออก แล้วคุมสิทธิ์ระดับตารางด้วย IAM หรือ Lake Formation
- เลือก S3 Table Buckets เมื่อทำได้ เพื่อให้ compaction เกิดขึ้นอัตโนมัติ ถ้าใช้ bucket ทั่วไปต้องวางงานดูแลไฟล์เล็กเอง ติดตามข่าวแพลตฟอร์มข้อมูลเพิ่มเติมได้ที่หมวดข้อมูล
คำถามที่พบบ่อย
Iceberg materialized view ใน Amazon Redshift คืออะไร?
เป็น materialized view ที่ Amazon Redshift คำนวณ join และ aggregation ไว้ล่วงหน้า แล้วเก็บผลเป็นตาราง Apache Iceberg บน Amazon S3 หรือ S3 Table Buckets ซึ่งลงทะเบียนใน AWS Glue Data Catalog เอนจินอื่นอย่าง Athena และ Spark จึงอ่านผลเดียวกันได้โดยไม่ต้องคัดลอก
Amazon Redshift รุ่นไหนสร้าง Iceberg materialized view ได้?
ใช้ได้บน Amazon Redshift Serverless และคลัสเตอร์ provisioned แบบ RG ที่ใช้ซีพียู AWS Graviton เท่านั้น คลัสเตอร์แบบ RA3 และ DC2 ไม่รองรับ AWS ระบุว่าเปิดให้ใช้ในทุก region ที่มี Redshift Serverless และเครื่อง Graviton แบบ provisioned
Iceberg materialized view ต่างจาก materialized view แบบเดิมของ Redshift อย่างไร?
แบบเดิมเก็บผลใน Redshift Managed Storage ซึ่งอ่านจาก Amazon Redshift ได้เร็วที่สุดแต่ใช้ได้เฉพาะ Redshift ส่วนแบบ Iceberg เก็บผลบน Amazon S3 ในรูปแบบเปิดให้หลายเอนจินอ่าน AWS แนะนำให้ใช้ร่วมกัน โดยโหลดผลที่ต้องการความเร็วสูงสุดเข้า Redshift Managed Storage อีกชั้น
Iceberg materialized view มีข้อจำกัดอะไรบ้าง?
ใน Amazon Redshift ตารางต้นทางต้องเป็น Iceberg ใน region และบัญชีเดียวกันและไม่ใช่ Iceberg format version 3 ใช้ UDF หรือ ORDER BY และ LIMIT ไม่ได้ ไม่มี autorefresh ไม่มี query rewrite อัตโนมัติ และไม่รองรับ fine-grained access control
แหล่งอ้างอิง
- Materialize once, query anywhere: Introducing Iceberg materialized views in Amazon Redshift — AWS Big Data Blog
- Amazon Redshift now supports creating and refreshing Apache Iceberg materialized views — Amazon Web Services
- Materialized views stored as Apache Iceberg tables — Amazon Redshift Database Developer Guide
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ