
Amazon S3 Tables Hive to Iceberg: AWS ย้ายตารางแบบจัดการให้ ไม่ต้องสร้างไปป์ไลน์เอง
Amazon S3 Tables Hive to Iceberg: AWS เปิดให้ย้ายตาราง Hive รูปแบบ Parquet ใน Glue เป็น Iceberg ผ่าน API 4 พ.ย. 2026 เสียค่าเฉพาะข้อมูลที่คัดลอก ไม่มีค่าแปลง
โดย กองบรรณาธิการ THAI DATA อ่าน 4 นาที
สรุปประเด็นสำคัญ
- AWS ประกาศเมื่อ 4 พฤศจิกายน 2026 ว่า Amazon S3 Tables ย้ายตาราง Apache Hive เป็น Apache Iceberg แบบจัดการให้ได้ โดยไม่ต้องสร้างไปป์ไลน์หรือจัดสรรคอมพิวต์เอง
- รองรับตาราง Hive รูปแบบ Parquet ที่ลงทะเบียนใน AWS Glue Data Catalog และอยู่ในบัญชีและ Region เดียวกันเท่านั้น ณ วันเปิดตัว
- ซิงก์ได้กี่ครั้งก็ได้โดยไม่หยุดเขียนต้นทาง ยกเว้นช่วง cutover ไม่กี่นาที และตารางปลายทางเป็นแบบอ่านอย่างเดียวจนกว่าจะสั่งจบการย้าย
- ค่าใช้จ่ายคิดเฉพาะ ข้อมูลที่คัดลอก ไม่มีค่าแปลง Hive เป็น Iceberg และวัตถุต้นทางใน S3 Intelligent-Tiering คงชั้นเดิม
- เปิดใช้ใน 10 Region รวมสิงคโปร์ มุมไบ ซิดนีย์ และโตเกียว แต่รายการที่ AWS ระบุไม่มี Region กรุงเทพฯ
AWS ประกาศเมื่อวันที่ 4 พฤศจิกายน 2026 ว่า Amazon S3 Tables ย้ายตาราง Apache Hive ไปเป็น Apache Iceberg แบบจัดการให้ได้ (Amazon S3 Tables Hive to Iceberg migration) โดยไม่ต้องสร้างไปป์ไลน์หรือจัดสรรคอมพิวต์เอง รองรับตาราง Parquet ที่ลงทะเบียนใน AWS Glue Data Catalog และเสียค่าใช้จ่ายเฉพาะข้อมูลที่คัดลอก ไม่มีค่าแปลงเป็น Iceberg
Amazon S3 Tables Hive to Iceberg ทำงานอย่างไร
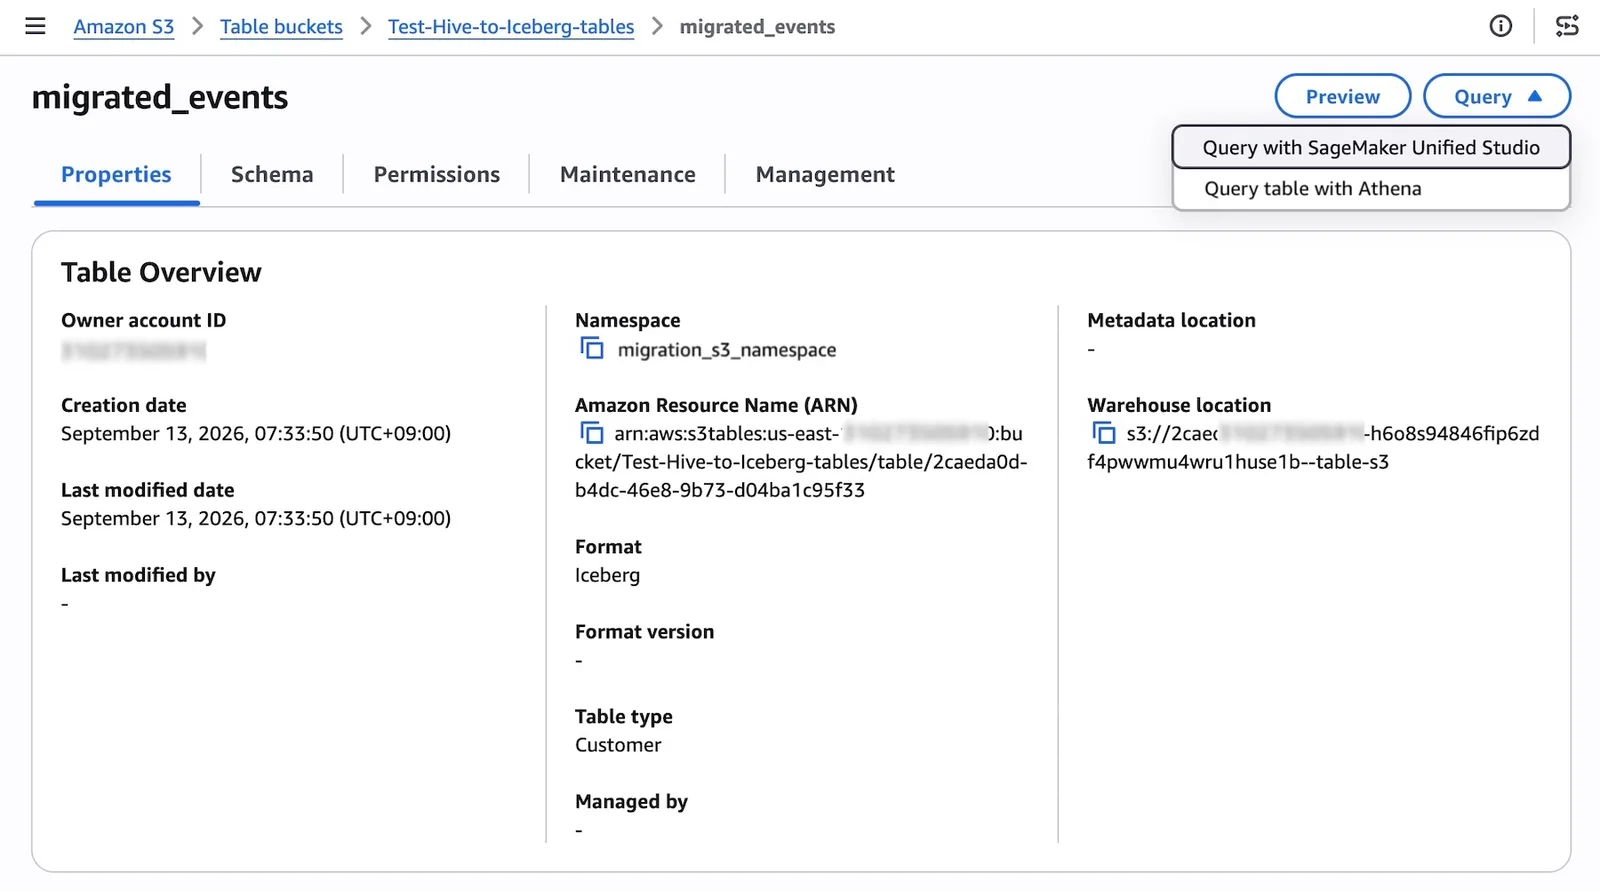
AWS อธิบายว่าก่อนหน้านี้การย้าย Hive to Iceberg อาจใช้เวลาหลายสัปดาห์เพื่อสร้างและดูแลโครงสร้างพื้นฐาน แปลงชนิดข้อมูล และทำระบบย้อนกลับ ตอนนี้ S3 Tables จัดขั้นตอนทั้งหมดให้ ได้แก่ ตรวจสอบข้อมูล เช็กความเข้ากันได้ แปลงชนิดข้อมูล บีบอัดไฟล์ใหม่ และรวมไฟล์ (compaction) โดยก่อนคัดลอกข้อมูลจะระบุวัตถุต้นทางทั้งหมดและสร้างรายงานความเข้ากันได้ให้ก่อน
| ขั้นตอน | สิ่งที่เกิดขึ้นตามประกาศ |
|---|---|
| เริ่ม | เลือก table bucket ปลายทางในคอนโซล S3 แล้วเลือก Create table from migration หรือเรียก start-table-migration |
| ตรวจสอบ | S3 Tables ตรวจตารางต้นทางและออกรายงานความเข้ากันได้ก่อนคัดลอก |
| ซิงก์ | เรียกซิงก์กี่ครั้งก็ได้ แต่ละครั้งคัดลอกเฉพาะส่วนที่เปลี่ยน ไม่ต้องหยุดเขียนต้นทาง |
| ปลายทาง | อ่านอย่างเดียวระหว่างย้าย เมื่อจบการย้ายจึงเป็นอ่านเขียน |
| cutover | ตารางออฟไลน์เฉพาะช่วงไม่กี่นาที |
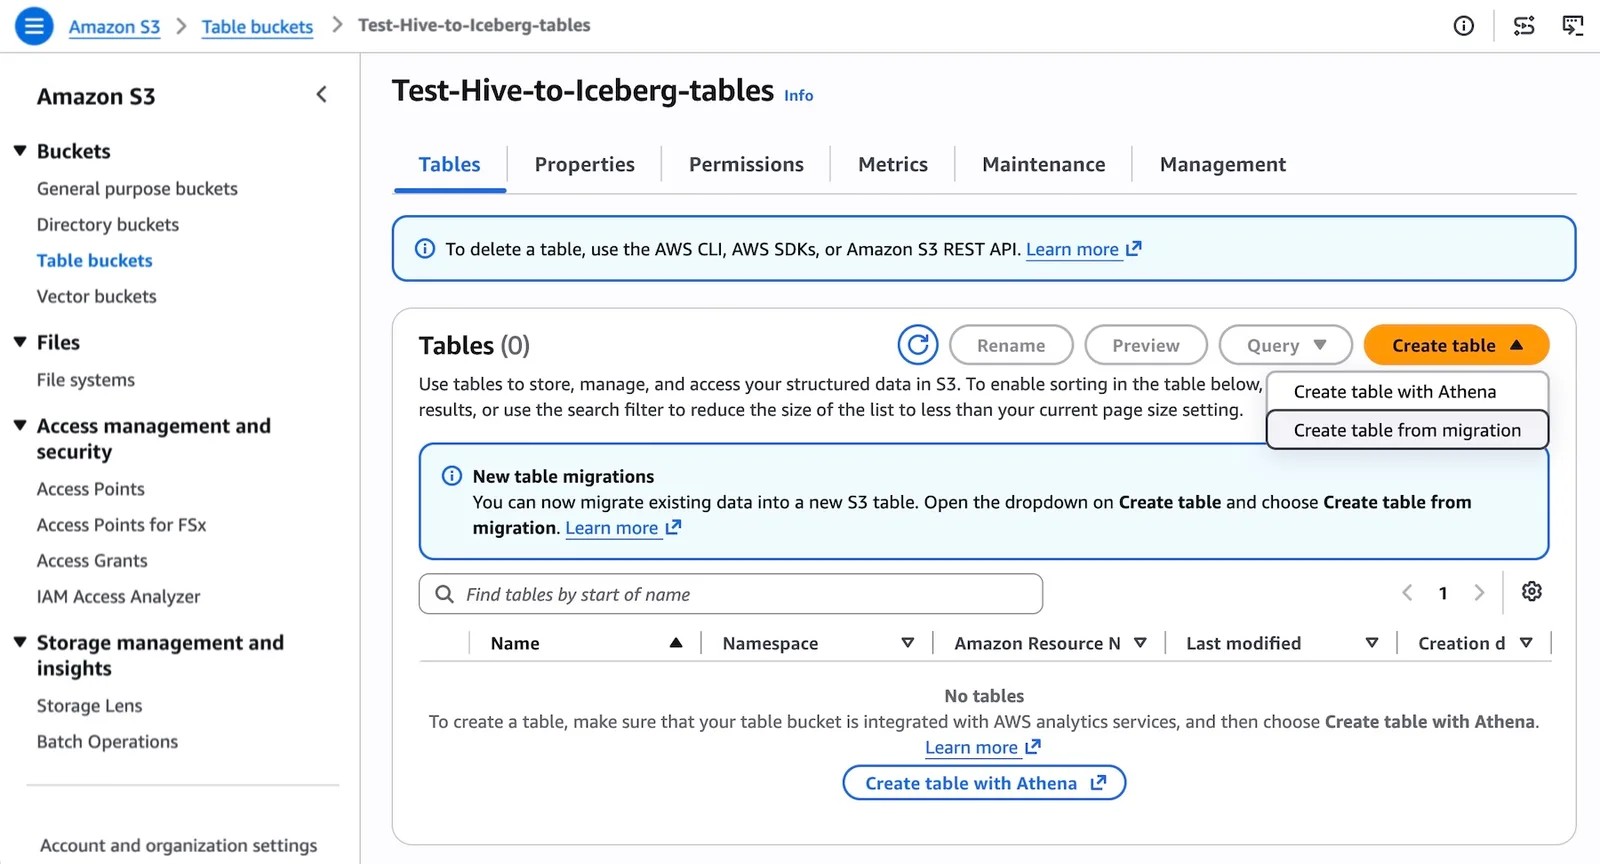
หลังย้ายตารางด้วย Amazon S3 Tables Hive to Iceberg เสร็จ เรียกดูข้อมูลได้ทันทีผ่านการเชื่อมต่อโดยตรงกับ Amazon Athena และ Amazon SageMaker Unified Studio ในคอนโซล หรือใช้เครื่องมืออื่นที่รองรับ Apache Iceberg REST API นอกจากนี้ยังสั่งผ่าน AWS CLI, SDK หรือ Agent Toolkit for AWS ได้ AWS มีสกิลสำหรับเอเจนต์เขียนโค้ดชื่อ migrating-hive-tables-to-s3-tables ที่ตรวจนโยบาย IAM ตรวจแผนการย้าย และสั่งขั้นตอน Start, Sync, Complete
ข้อจำกัดและพื้นที่ให้บริการของ Amazon S3 Tables Hive to Iceberg
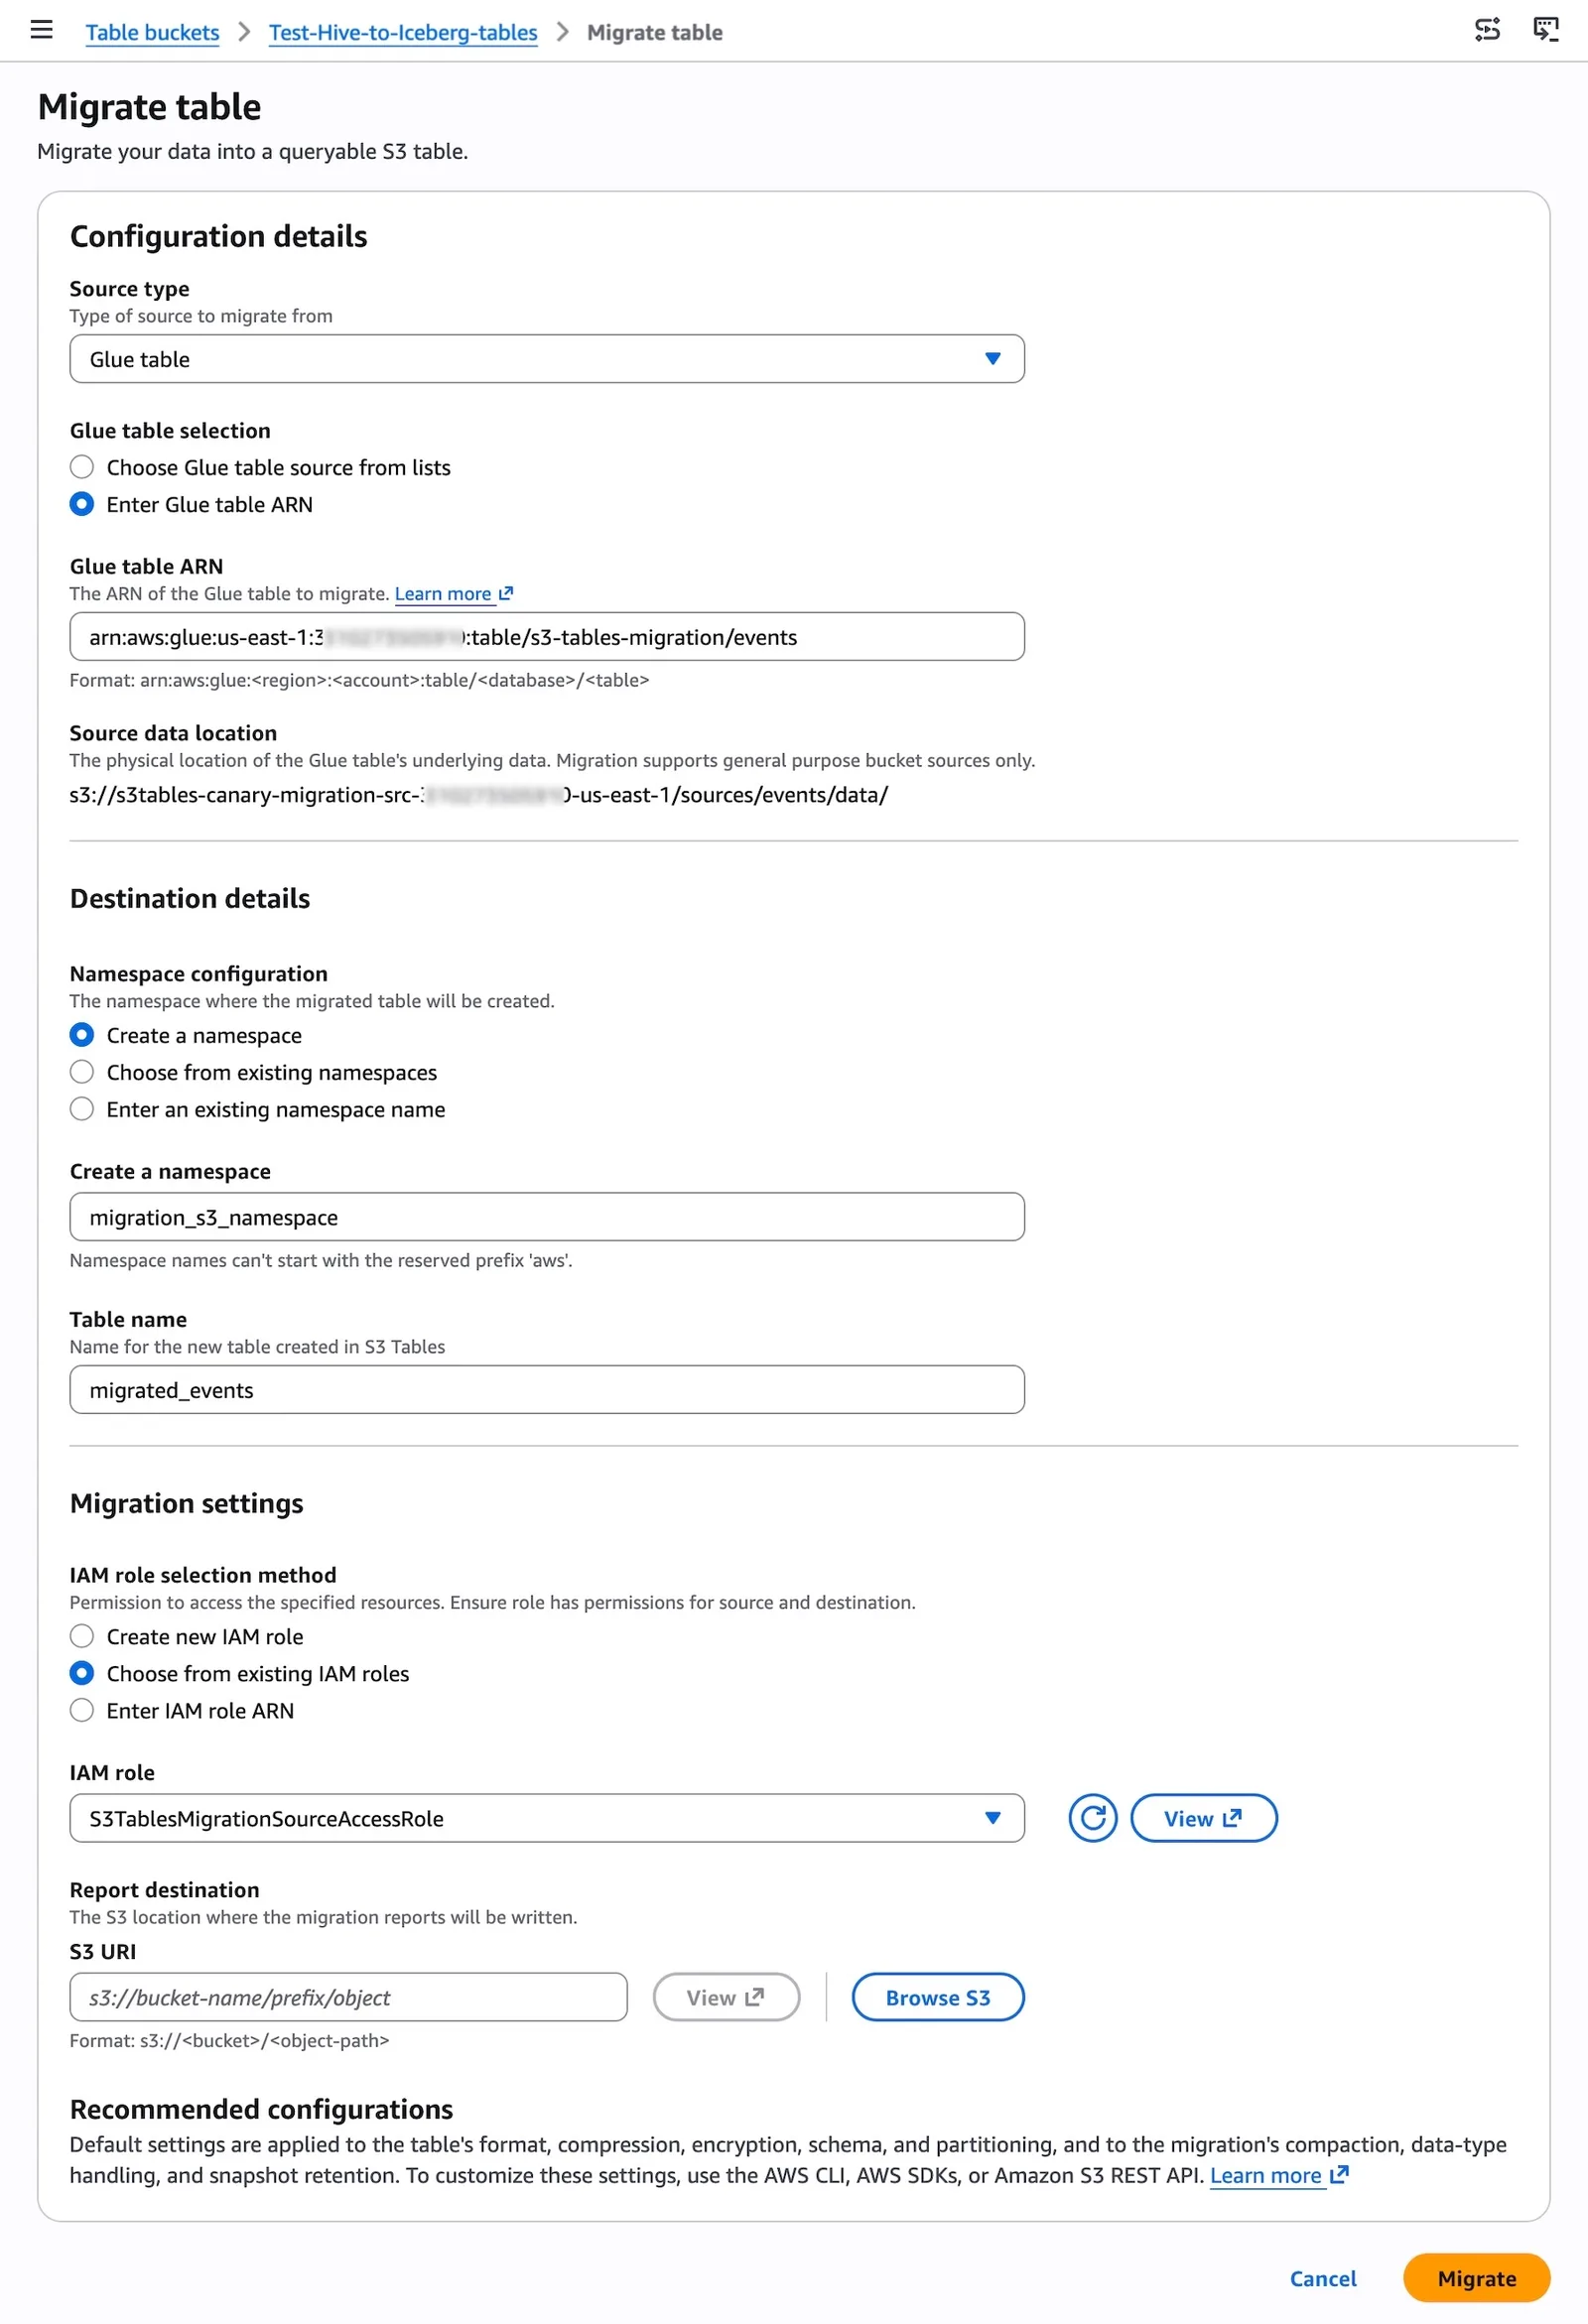
ณ วันเปิดตัว ความสามารถ Hive to Iceberg ของ Amazon S3 Tables รองรับเฉพาะตาราง Hive ที่ลงทะเบียนใน AWS Glue เก็บเป็น Parquet และอยู่ในบัญชีและ Region เดียวกันกับปลายทาง เปิดให้ใช้ใน US East (N. Virginia, Ohio), US West (Oregon), Asia Pacific (Mumbai, Singapore, Sydney, Tokyo) และ Europe (Frankfurt, Ireland, Stockholm) รวม 10 Region รายการนี้ไม่มี Region กรุงเทพฯ
ตารางปลายทางของ Amazon S3 Tables Hive to Iceberg สร้างด้วยค่าเริ่มต้นที่ AWS ปรับไว้เพื่อประสิทธิภาพการค้นและการใช้พื้นที่ และกำหนดเองได้ เช่น รูปแบบการเขียน การบีบอัด การรวมไฟล์ และจำนวนสแนปช็อตที่เก็บไว้ ตัวอย่าง JSON ในประกาศตั้งค่านโยบายให้การย้ายล้มเหลวเมื่อพบฟิลด์ต้นทางที่ไม่ตรงหรือค่าที่เข้ากันไม่ได้ แทนที่จะข้ามไปเงียบ ๆ
ทำไม Amazon S3 Tables Hive to Iceberg จึงสำคัญ
AWS ระบุว่า Iceberg ที่เป็นปลายทางของ Amazon S3 Tables Hive to Iceberg กลายเป็นมาตรฐานเปิดสำหรับชุดข้อมูลวิเคราะห์ขนาดใหญ่ รองรับ schema evolution, hidden partitioning และ time travel และค้นได้จากเอนจินที่รองรับ Iceberg หลายตัว องค์กรที่มี data lake แบบ Hive เดิมจึงมีเส้นทางย้ายที่ลดงานวิศวกรรม แต่ข้อสรุปว่าคุ้มหรือไม่ต้องคำนวณเอง เพราะค่าเก็บข้อมูลใน S3 Tables และค่าคัดลอกคิดแยก ราคาจริงดูที่หน้าราคา Amazon S3 ของ AWS และเราสรุปแนวทางค้น Iceberg จากฐานข้อมูลไว้ในAurora PostgreSQL ค้นข้อมูล Iceberg และ Parquet ใน data lake
สิ่งที่องค์กรไทยควรทำกับ Amazon S3 Tables Hive to Iceberg
- สำรวจว่าตาราง Hive to Iceberg ที่ตั้งใจจะย้ายอยู่ใน Glue เป็น Parquet และบัญชีกับ Region ตรงเงื่อนไขหรือไม่ แล้วลองกับตารางเล็กที่ไม่กระทบงานจริงก่อน
- อ่านรายงานความเข้ากันได้ก่อนคัดลอก และตั้งนโยบายให้ล้มเหลวเมื่อข้อมูลไม่ตรง เพื่อไม่ให้ข้อมูลเพี้ยนโดยไม่รู้ตัว
- วางแผน cutover ในช่วงที่งานอ่านและเขียนน้อย เพราะตารางต้องออฟไลน์ไม่กี่นาที
- ตรวจที่ตั้งข้อมูลเมื่อ Region ที่ใช้ได้ไม่มีในไทย ให้ตรวจข้อกำหนดภายในและ PDPA ก่อนย้ายข้อมูลส่วนบุคคลไปไว้นอกประเทศ
- เทียบค่าใช้จ่ายรวมของการเก็บและค้นข้อมูลกับทางเลือกอื่น ก่อนตัดสินใจย้ายทั้ง data lake
ติดตามข่าวข้อมูลอื่น ๆ ได้ที่หมวดข้อมูล
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
องค์กรที่ต้องเก็บข้อมูลวิเคราะห์ไว้ในประเทศมักเจอข้อจำกัดเรื่อง Region ของผู้ให้บริการต่างประเทศ Private Cloud ของ THAI DATA CLOUD เก็บข้อมูลไว้ในประเทศ รองรับ PDPA ราคาคงที่เป็นบาท มีทีมวิศวกรไทยดูแล 24/7 และ SLA 99.9% (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
คำถามที่พบบ่อย
Amazon S3 Tables Hive to Iceberg คืออะไร?
คือความสามารถใหม่ที่ AWS ประกาศ 4 พฤศจิกายน 2026 ให้ย้ายตาราง Apache Hive ที่เก็บเป็น Parquet ใน S3 และลงทะเบียนใน AWS Glue Data Catalog ไปเป็นตาราง Apache Iceberg แบบจัดการเต็มรูปแบบใน Amazon S3 Tables ผ่านคอนโซลหรือ API
ย้ายตาราง Hive to Iceberg ด้วย S3 Tables ต้องหยุดระบบไหม?
ไม่ต้องหยุดทั้งหมด Amazon S3 Tables Hive to Iceberg ซิงก์ได้ AWS ระบุว่าซิงก์ข้อมูลกี่ครั้งก็ได้โดยไม่หยุดการเขียนต้นทาง ยกเว้นช่วง cutover ไม่กี่นาที ระหว่างย้ายตารางปลายทางเป็นแบบอ่านอย่างเดียว และเมื่อจบการย้ายจะเปลี่ยนเป็นอ่านเขียนได้
การย้าย Hive เป็น Iceberg บน S3 Tables คิดค่าบริการอย่างไร?
ตามประกาศของ AWS ค่า Amazon S3 Tables Hive to Iceberg คิดเฉพาะข้อมูลที่คัดลอก ไม่มีค่าธรรมเนียมการแปลง Hive เป็น Iceberg และวัตถุต้นทางที่อยู่ใน S3 Intelligent-Tiering ยังอยู่ในชั้นการเข้าถึงเดิม ราคาต่อหน่วยดูได้ที่หน้าราคาของ S3
Amazon S3 Tables Hive to Iceberg migration ใช้ได้ที่ Region ไหน?
ใช้ได้ใน US East (N. Virginia, Ohio), US West (Oregon), Asia Pacific (Mumbai, Singapore, Sydney, Tokyo) และ Europe (Frankfurt, Ireland, Stockholm) ตามประกาศ ยังไม่มี Region กรุงเทพฯ ในรายการ จึงต้องตรวจเรื่องที่ตั้งข้อมูลก่อนใช้
แหล่งอ้างอิง
- Amazon S3 Tables now offer managed migration of Apache Hive tables to Apache Iceberg — Amazon Web Services
- AWS What's New: Recent Announcements — Amazon Web Services
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- ประเทศและสถานที่
- สิงคโปร์224โตเกียว47กรุงเทพฯ322
- ผลิตภัณฑ์และเทคโนโลยี
- Apache Iceberg9
- กฎหมายและมาตรฐาน
- PDPA286
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ