
Microsoft Fabric เปิดใช้ Custom SQL Pools ทั่วไป แยกพลังประมวลผลให้งานโหลดข้อมูลกับรายงาน
Microsoft ประกาศ Custom SQL Pools ใน Fabric Data Warehouse พร้อมใช้งานทั่วไป 12 ต.ค. 2026 แบ่งพลังประมวลผลได้สูงสุด 8 พูล กันงาน ETL แย่งทรัพยากรรายงาน
โดย กองบรรณาธิการ THAI DATA อ่าน 4 นาที
สรุปประเด็นสำคัญ
- Microsoft ประกาศเมื่อ 12 ตุลาคม 2026 ว่า Custom SQL Pools ใน Fabric Data Warehouse พร้อมใช้งานทั่วไป (GA) พร้อมการจัดกลุ่มคำสั่งตามประเภท SELECT และ NONSELECT
- เมื่อเลือกแยกตามประเภทคำสั่ง Fabric จะสร้าง 2 พูล ที่ได้สัดส่วนสูงสุดเริ่มต้น 50% เท่ากัน ผู้ดูแลปรับได้ตราบที่รวมกันไม่เกิน 100%
- เอกสารของ Microsoft ระบุว่าสร้างได้สูงสุด 8 พูลต่อ workspace จัดคำขอเข้าพูลจากชื่อแอปแบบตรงตัวหรือ regex ชื่อแอปยาวไม่เกิน 128 ตัวอักษร และทำได้เฉพาะผู้ที่มีบทบาท Administrator ของ workspace
- ทรัพยากรรวมที่ขยายชั่วคราว (burst) ได้ยังเท่าเดิมที่ 24 เท่า ของ capacity การแบ่งพูลจึงเป็นการจัดสรรใหม่ ไม่ใช่การเพิ่มพลังประมวลผล
Microsoft ประกาศเมื่อวันที่ 12 ตุลาคม 2026 ว่า Custom SQL Pools ใน Fabric Data Warehouse พร้อมใช้งานทั่วไป (GA) ผู้ดูแลแบ่งพลังประมวลผลของคลังข้อมูลเป็นพูลแยกได้สูงสุด 8 พูลต่อ workspace และกำหนดเพดานเปอร์เซ็นต์ของแต่ละพูล เพื่อกันไม่ให้งานโหลดข้อมูลหนัก ๆ ไปแย่งทรัพยากรของรายงานที่ผู้บริหารเปิดดู
พร้อมกันนั้น Microsoft เพิ่มการจัดกลุ่มตามประเภทคำสั่ง ซึ่งแยกงานอ่านกับงานเขียนออกจากกันได้ทันทีโดยไม่ต้องรู้ว่าแอปใดเชื่อมต่อเข้ามา ฟีเจอร์นี้ใช้ได้ทั้งกับ Warehouse และ SQL analytics endpoint ใน workspace เดียวกัน
Custom SQL Pools เปลี่ยนอะไรใน Fabric Data Warehouse
โดยปกติ Fabric Data Warehouse จัดการงานเองอัตโนมัติ (autonomous workload management) ด้วยพูลภายในสองชุด ชุดหนึ่งรับงานนำเข้าข้อมูล อีกชุดรับคำสั่ง SELECT Custom SQL Pools ให้ผู้ดูแลเข้ามากำหนดเองได้ทั้งจำนวนพูล เกณฑ์จัดคำขอเข้าพูล และสัดส่วนทรัพยากรสูงสุดของแต่ละพูล
| หัวข้อ | จัดการอัตโนมัติ (ค่าเริ่มต้น) | Custom SQL Pools |
|---|---|---|
| การตั้งค่า | ไม่ต้องตั้ง | หน้าเว็บพอร์ทัล หรือ API |
| ผู้มีสิทธิ์ | ไม่เกี่ยว | Administrator ของ workspace |
| เกณฑ์จัดคำขอ | ประเภทคำสั่ง (SELECT หรืออื่น) | ประเภทคำสั่ง ชื่อแอปแบบตรงตัว หรือ regex ของชื่อแอป |
| จำนวนพูล | 2 พูล | สูงสุด 8 พูลต่อ workspace |
| การขยายชั่วคราว (burst) | สูงสุด 12 เท่าต่อพูล รวม 24 เท่า | ตามเปอร์เซ็นต์ที่ตั้ง รวมยังเป็น 24 เท่า |
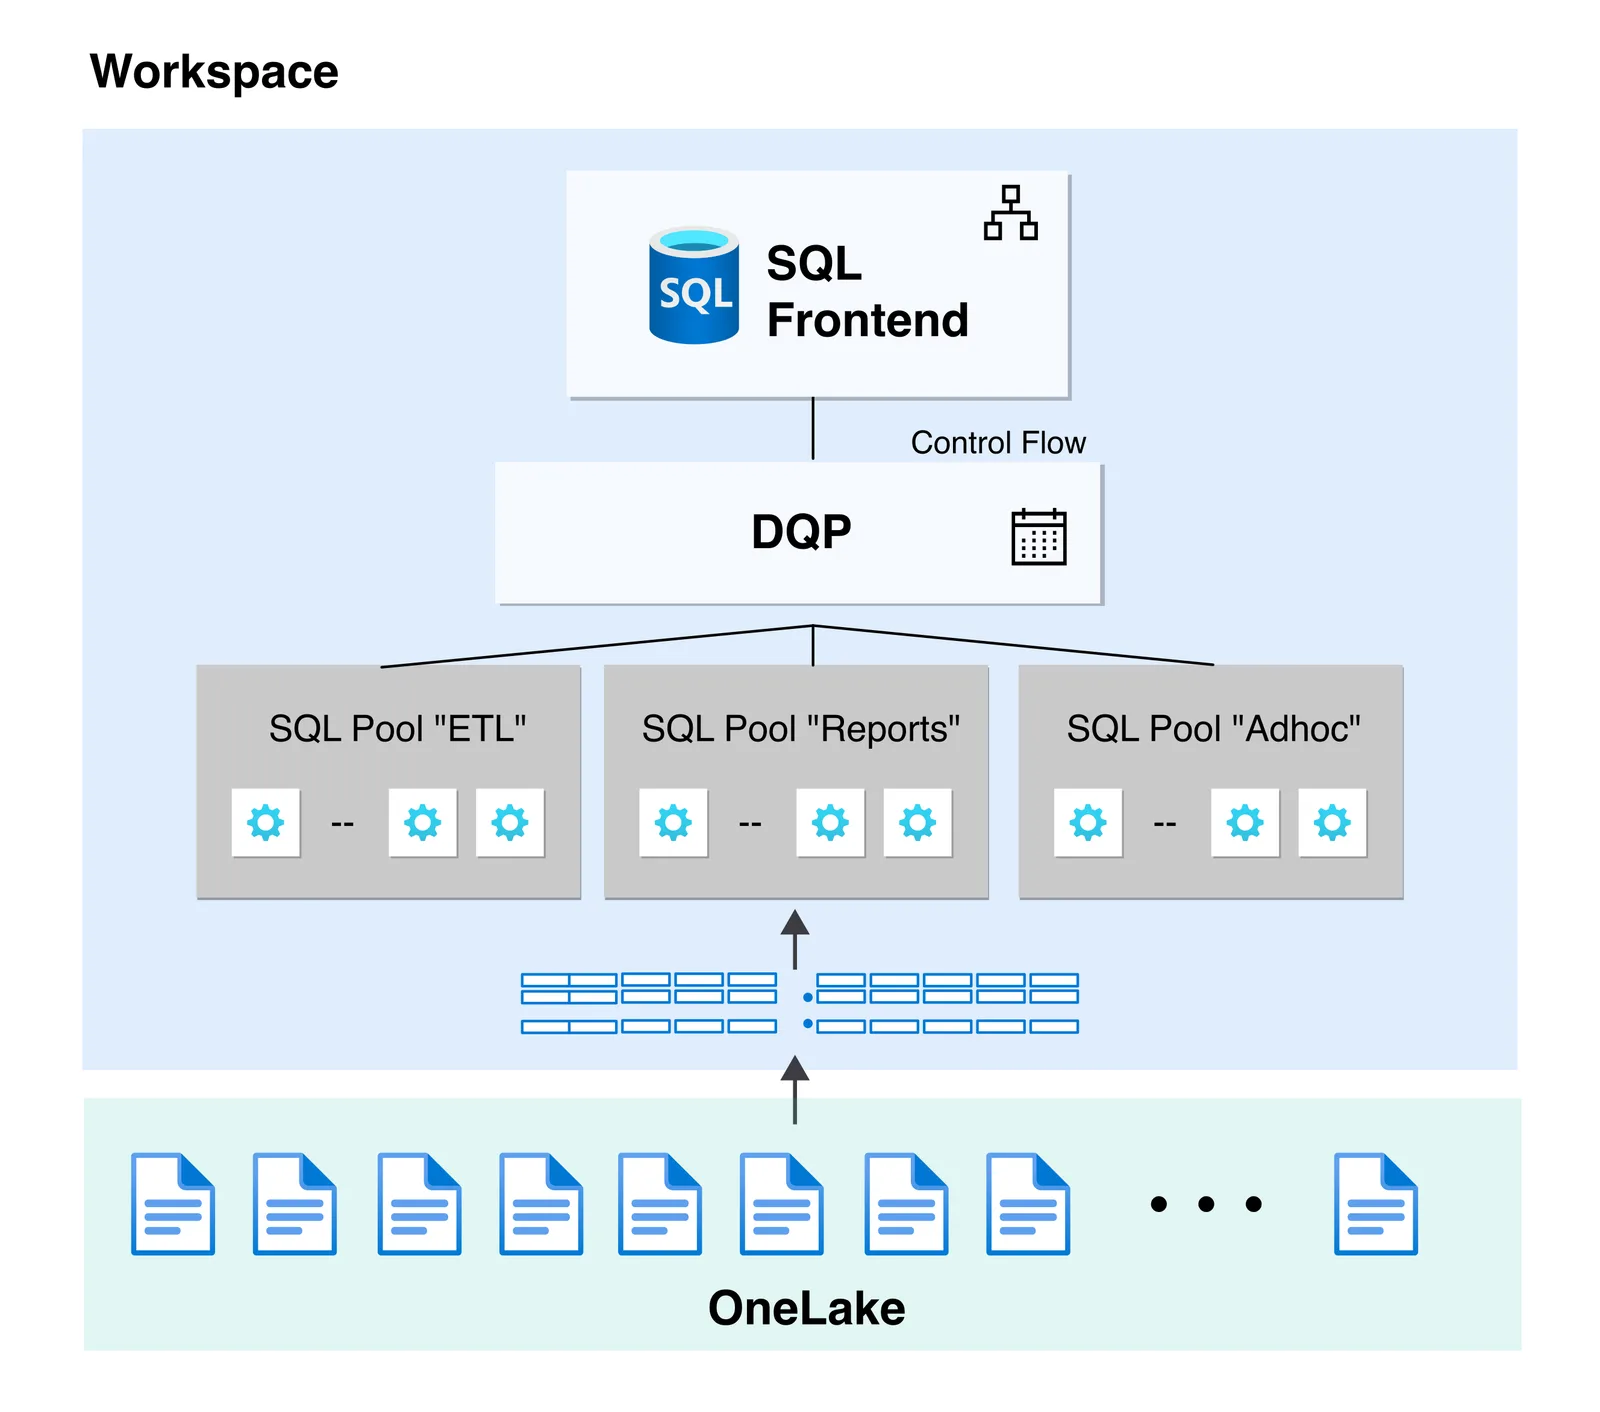
ตัวอย่างในประกาศของ Microsoft คือแยกพูลสำหรับการนำเข้าข้อมูล งานรายงาน และงานวิเคราะห์เฉพาะกิจ แล้วกำหนดว่าแต่ละพูลใช้ทรัพยากรได้ไม่เกินกี่เปอร์เซ็นต์ บล็อกของ Microsoft อธิบายว่า Custom SQL Pools "complement the autonomous workload-management capabilities" โดยเพิ่มการควบคุมสำหรับงานที่ต้องคาดการณ์ได้และงานสำคัญต่อธุรกิจ
แยกงานตามประเภทคำสั่งหรือชื่อแอป
Custom SQL Pools มีวิธีจัดคำขอเข้าพูลสามแบบ และทั้ง workspace ต้องเลือกใช้แบบเดียวกัน
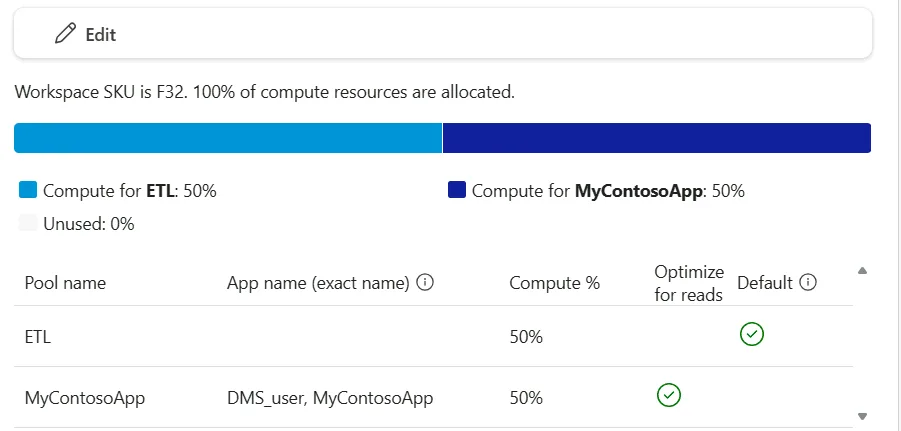
- ตามประเภทคำสั่ง (ใหม่ในรุ่น GA): SELECT สำหรับการอ่าน และ NONSELECT สำหรับการโหลดหรือแก้ข้อมูล Fabric สร้างสองพูลที่มีเพดานเริ่มต้น 50% เท่ากัน ปรับได้ตราบที่รวมกันไม่เกิน 100%
- ตามชื่อแอปแบบตรงตัว: ใช้ค่า Application Name ในสตริงเชื่อมต่อ ใส่ได้หลายชื่อต่อพูล ชื่อยาวไม่เกิน 128 ตัวอักษร และชื่อเดียวกันอยู่ได้พูลเดียว
- ตามชื่อแอปแบบ regex: จับชื่อแอปที่เปลี่ยนไปเรื่อย ๆ ด้วย regular expression ถ้าคำขอตรงกับหลายพูล ระบบจะเลือกพูลแบบสุ่มโดยไม่มีลำดับความสำคัญ
คู่มือตั้งค่าของ Microsoft ให้ค่า regex สำเร็จรูปไว้สำหรับทราฟฟิกที่พบบ่อย เช่นคิวรีจาก Power BI ทั้งแบบ DirectQuery และ Import คิวรีจาก pipeline ของ Fabric และ DMS_user สำหรับคิวรีจาก SQL query editor ในพอร์ทัล ส่วนตัวเลือก "Optimize for reads" ใช้ติดให้พูลที่รับคำสั่ง SELECT เป็นหลัก
ข้อจำกัดของ Custom SQL Pools ที่ผู้ดูแลต้องรู้
เอกสารของ Microsoft ระบุเงื่อนไขที่ควรอ่านก่อนเปิดใช้ในระบบจริง
- workspace ต้องมี warehouse หรือ SQL analytics endpoint อย่างน้อยหนึ่งตัวก่อนเรียก API
- ลบพูลขณะมีคิวรีรันอยู่ คิวรีนั้นจะล้มด้วยข้อความ "Query canceled by user" แต่การปรับขนาดพูลไม่ทำให้คิวรีล้ม
- เปลี่ยนขนาด capacity หรือย้าย workspace ไป capacity อื่น พูลจะปรับตามขนาดใหม่เอง ถ้าลดขนาดจนพูลใดเหลือศูนย์โหนด คิวรีจะขึ้นข้อผิดพลาดว่าพูลไม่มีทรัพยากร และผู้ดูแลต้องตั้งค่าใหม่
- ข้อมูลใน query insights ใช้เวลาราว 10–15 นาทีกว่าจะเห็นว่าคิวรีไปลงพูลไหน ตรวจได้จากคอลัมน์
program_nameและsql_pool_nameในqueryinsights.exec_requests_historyและดูช่วงที่พูลตึงมือจากqueryinsights.sql_pool_insights
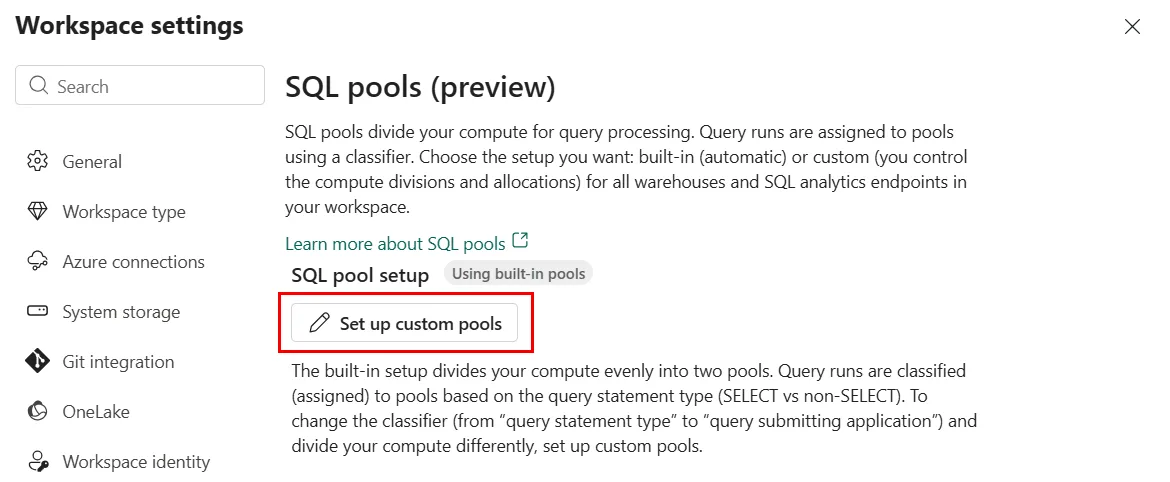
ณ วันที่เขียน หน้าเอกสารของ Microsoft Learn ทั้งสองหน้ายังติดป้ายว่าฟีเจอร์อยู่ในสถานะพรีวิว ขณะที่บล็อก Fabric Updates ระบุสถานะ GA แล้ว ทีมที่ต้องอ้างอิงสถานะในเอกสารภายในควรยึดประกาศ GA และตรวจหน้าเอกสารอีกครั้งเมื่ออัปเดต
ทำไมเรื่องนี้สำคัญ
สถานการณ์ที่ Microsoft ยกเป็นตัวอย่าง คือรายงานขององค์กรทำงานช้าลงเมื่อผู้ใช้ยิงคิวรีเฉพาะกิจจาก SQL query editor และงานนำเข้าหรือแปลงข้อมูลหนัก ๆ ที่ไปกินทรัพยากรของรายงานแบบโต้ตอบ ซึ่งองค์กรที่ใช้ Power BI บน Fabric คุ้นเคยดี เอกสารของ Microsoft สรุปสองกรณีหลักที่ Custom SQL Pools แก้ได้ คือกันงานสำคัญจากการแย่งทรัพยากร และลดการถูกจำกัดความเร็ว (throttling) เมื่อ capacity ถูกใช้หนัก ด้วยการลดเปอร์เซ็นต์รวมที่ warehouse ใช้ได้
เพราะทรัพยากรรวมไม่ได้เพิ่ม การแบ่งพูลคือการตัดสินใจทางธุรกิจว่างานใดสำคัญกว่า ไม่ใช่ทางลัดแทนการขยาย capacity ในวันเดียวกัน Microsoft ยังเปิดตัวแอป Capacity Metrics โฉมใหม่แบบพรีวิว ซึ่งช่วยดูการใช้ทรัพยากรก่อนตัดสินใจแบ่งพูล
สิ่งที่องค์กรไทยควรทำ
- สำรวจก่อนแบ่ง ดึง
program_nameจาก query insights ย้อนหลังเพื่อดูว่าแอปไหนใช้ CPU มากที่สุด แล้วค่อยออกแบบพูลจากข้อมูลจริง - เริ่มจากแยกอ่านกับเขียน องค์กรที่ไม่มีมาตรฐานตั้งชื่อแอปในสตริงเชื่อมต่อ ใช้การแยก SELECT/NONSELECT ของ Custom SQL Pools เป็นขั้นแรกได้ทันที แล้วปรับสัดส่วนจาก 50/50 ตามช่วงเวลาที่รายงานถูกเปิดมาก
- ตั้งชื่อแอปให้เป็นระบบ กำหนด Application Name ในสตริงเชื่อมต่อของ ETL เครื่องมือ BI และแอปภายใน เพื่อให้จัดพูลตามชื่อได้แม่นและตรวจย้อนหลังได้
- วางขั้นตอนเปลี่ยนค่าในช่วงที่ไม่มีงานหนัก เพราะการลบพูลทำให้คิวรีที่รันอยู่ล้ม และการลดขนาด capacity อาจทำให้บางพูลไม่มีทรัพยากรเหลือ
- จำกัดสิทธิ์ผู้ดูแล การตั้งค่าที่มีผลกับทุก warehouse ใน workspace ควรอยู่กับทีมแพลตฟอร์มข้อมูลไม่กี่คน อ่านข่าวแพลตฟอร์มข้อมูลอื่นได้ที่หมวดข้อมูล
คำถามที่พบบ่อย
Custom SQL Pools ใน Microsoft Fabric คืออะไร?
Custom SQL Pools คือความสามารถของ Fabric Data Warehouse และ SQL analytics endpoint ที่ให้ผู้ดูแล workspace แบ่งพลังประมวลผลเบื้องหลังเป็นพูลแยกกัน แล้วกำหนดสัดส่วนสูงสุดที่แต่ละพูลใช้ได้ เช่นแยกงานโหลดข้อมูล งานรายงาน และงานสืบค้นเฉพาะกิจ ไม่ให้งานหนึ่งแย่งทรัพยากรของอีกงาน Microsoft ประกาศให้ใช้งานทั่วไปเมื่อ 12 ตุลาคม 2026
Custom SQL Pools แยกงานได้อย่างไร?
Custom SQL Pools จัดคำขอเข้าพูลได้สองแบบ แบบแรกตามประเภทคำสั่ง คือ SELECT สำหรับการอ่าน และ NONSELECT สำหรับการโหลดหรือแก้ข้อมูล โดยเริ่มที่พูลละ 50% แบบที่สองตามชื่อแอปพลิเคชันในสตริงเชื่อมต่อ ทั้งแบบชื่อตรงตัวและ regular expression ทั้ง workspace ต้องใช้ตัวจัดกลุ่มแบบเดียวกัน
แบ่งพูลแล้วพลังประมวลผลรวมเพิ่มขึ้นหรือไม่?
ไม่เพิ่ม เอกสารของ Microsoft ระบุว่าแบบอัตโนมัติแต่ละพูลขยายชั่วคราวได้ถึง 12 เท่าและรวมสูงสุด 24 เท่าของ capacity ส่วน Custom SQL Pools แบ่งเป็นเปอร์เซ็นต์ของโหนดเบื้องหลัง แต่ทรัพยากรรวมยังอยู่ที่ 24 เท่า จึงเป็นการจัดลำดับความสำคัญ ไม่ใช่การซื้อพลังเพิ่ม
ใครตั้งค่า Custom SQL Pools ได้และตั้งที่ไหน?
ผู้ที่มีบทบาท Administrator ของ workspace เท่านั้นที่เปิด ปิด หรือแก้ Custom SQL Pools ได้ ตั้งค่าที่ Workspace settings ส่วน Data Warehouse หน้า SQL Pools ในพอร์ทัล Fabric หรือผ่าน Fabric REST API การตั้งค่ามีผลกับทุก warehouse และ SQL analytics endpoint ใน workspace นั้น
แหล่งอ้างอิง
- Custom SQL Pools in Fabric Data Warehouse (Generally Available) — Microsoft Fabric Updates Blog
- Custom SQL pools — Microsoft Learn
- Configure custom SQL pools in the Fabric portal — Microsoft Learn
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Microsoft41
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ