
OpenAI Habitat เบื้องหลังฐานข้อมูลรับผู้ใช้ ChatGPT 1 พันล้านคน บน Azure Cosmos DB 500 PB
OpenAI Habitat แพลตฟอร์มเก็บข้อมูลของ ChatGPT รับผู้ใช้กว่า 1,000 ล้านคน ข้อมูลกว่า 500 PB บน Azure Cosmos DB ลดเวลาอ่านค่ากลางจาก 120 เหลือ 10 มิลลิวินาที
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
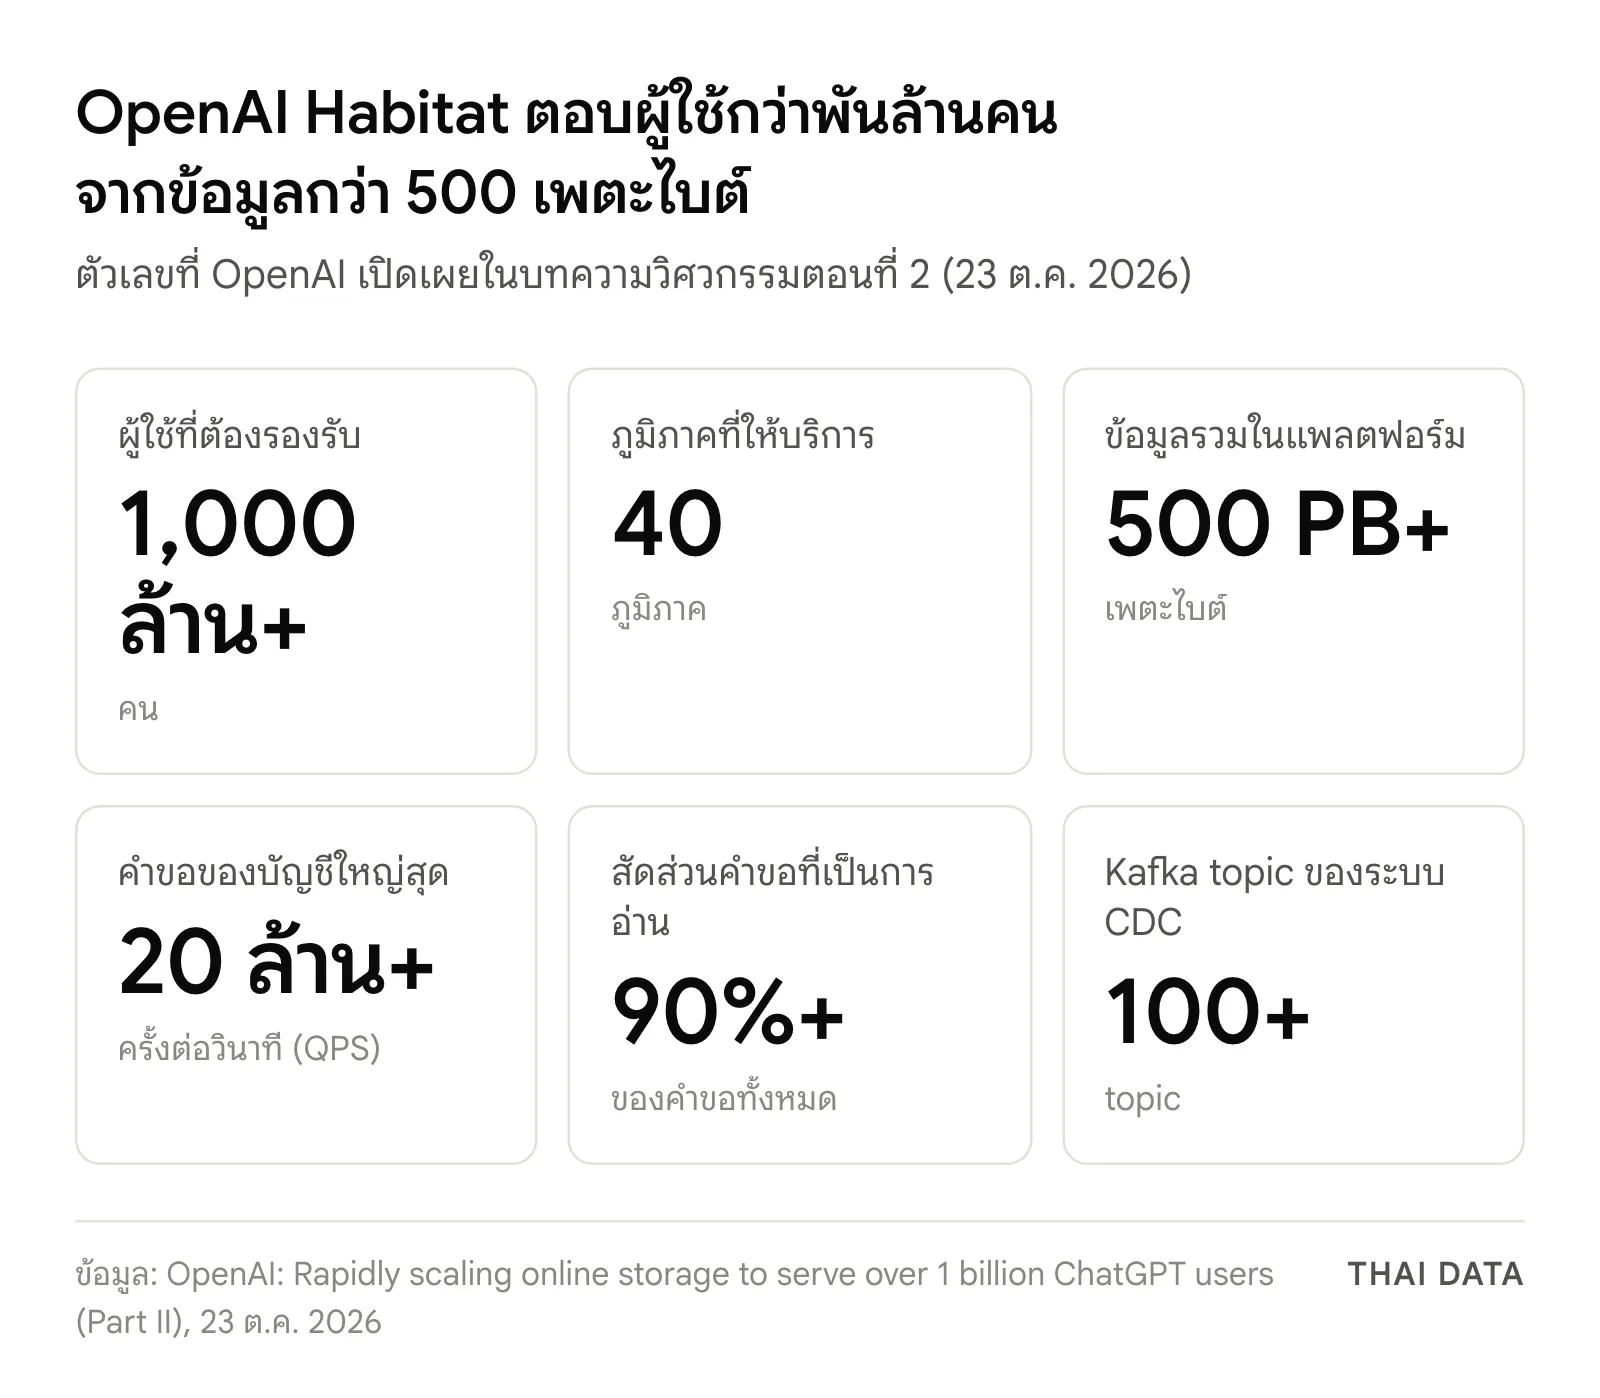
- OpenAI เผยแพร่บทความวิศวกรรมตอนที่ 2 เมื่อ 23 ตุลาคม 2026 อธิบาย OpenAI Habitat แพลตฟอร์มเก็บข้อมูลออนไลน์ที่ตอบผู้ใช้กว่า 1,000 ล้านคน ใน 40 ภูมิภาค และเก็บข้อมูลกว่า 500 เพตะไบต์
- บัญชี Azure Cosmos DB ที่ใหญ่ที่สุดของ OpenAI เก็บข้อมูลหลายสิบเพตะไบต์และรับคำขอกว่า 20 ล้านครั้งต่อวินาที OpenAI ระบุว่าเท่าที่รู้ไม่มีบริษัทอื่นใช้ Cosmos DB ระดับนี้
- หลังวนจากคอนเทนเนอร์รวม ไปแยกคอนเทนเนอร์ต่อทีม แล้วกลับมาใช้คอนเทนเนอร์รวม OpenAI กับทีม Azure เพิ่มการจำกัดคีย์ที่ร้อนที่สุด การจัดลำดับความสำคัญของคำขอ และโหมด serverless แบบใหม่ที่ให้แต่ละ physical partition ขยายถึง 10,000 RU/s
- แคช Valkey ใกล้ผู้ใช้ที่ล้างค่าด้วย change data capture ภายในไม่กี่วินาที ร่วมกับการเขียนบริการใหม่ด้วย Rust ลดเวลาอ่านค่ากลาง (p50) ทั่วโลกจากราว 120 มิลลิวินาที เหลือราว 10 มิลลิวินาที หรือเร็วขึ้น 12 เท่า
- OpenAI กำลังสร้างระบบเก็บข้อมูลออนไลน์ระดับ เอกซะไบต์ของตัวเอง โดยใช้แกน RocksDB Cloud จาก Rockset กับการทำสำเนาแบบ Raft
OpenAI เผยแพร่บทความวิศวกรรมเมื่อ 23 ตุลาคม 2026 เล่าเบื้องหลัง OpenAI Habitat แพลตฟอร์มเก็บข้อมูลออนไลน์ที่ต้องตอบผู้ใช้กว่า 1,000 ล้านคนใน 40 ภูมิภาคภายในระดับมิลลิวินาที บน Azure Cosmos DB ที่เก็บข้อมูลรวมกว่า 500 เพตะไบต์ และลดเวลาอ่านข้อมูลค่ากลางทั่วโลกจากราว 120 เหลือราว 10 มิลลิวินาที
OpenAI Habitat คืออะไร
OpenAI Habitat เป็นชั้นกลางระหว่างผลิตภัณฑ์อย่าง ChatGPT, API และ Codex กับที่เก็บข้อมูลจริง ทำหน้าที่ดูแลแคช สิทธิ์การเข้าถึง ที่ตั้งข้อมูล (data residency) การเข้ารหัส การแยกผู้ใช้หลายราย (multi-tenancy) และการจำกัดคำขอ ฝั่งที่เก็บข้อมูลมีทั้ง Azure Cosmos DB, Nanobase, Valkey สำหรับแคช และ Blob storage ส่วนการเปลี่ยนแปลงของข้อมูลถูกส่งต่อด้วย change data capture (CDC) ไปยัง Databricks, Rockset และ Kafka
บทความตอนแรกเล่าการเปลี่ยน OpenAI Habitat จากไลบรารี Python ฝั่งลูกค้าเป็นบริการกลาง ตอนที่ 2 นี้เล่าการขยาย Azure Cosmos DB ซึ่งต้องทำงานร่วมกับทีม Azure อย่างใกล้ชิด
วนกลับมาที่คอนเทนเนอร์รวม: บทเรียน multi-tenancy
OpenAI เดินทางเป็นวงกลม จากคอนเทนเนอร์ Cosmos DB ใบเดียวที่ทุกผลิตภัณฑ์ใช้ร่วมกัน ไปแยกคอนเทนเนอร์ให้แต่ละบริการ แล้วกลับมาใช้คอนเทนเนอร์รวมเป็นค่าเริ่มต้น
| ช่วง | ทำอย่างไร | ปัญหาที่เจอ |
|---|---|---|
| 1 | คอนเทนเนอร์รวมใบเดียว พึ่งเพดาน 10,000 RU/s ต่อ partition key | ลูกค้าเลือก partition key เอง คีย์อย่าง user_id ชนกันข้ามผลิตภัณฑ์ งานของฟีเจอร์เล็กกระทบการล็อกอินและสมัครสมาชิก |
| 2 | แยกคอนเทนเนอร์ให้บริการและฟีเจอร์ใหญ่ | ทุกทีมต้องวางแผนความจุเอง ลืมขยายก่อนเปิดตัวจนต้องแก้หน้างาน |
| 3 | กลับมาใช้คอนเทนเนอร์รวม พร้อมฟีเจอร์ใหม่จาก Azure | ไม่มีเหตุจากการจัดสรรความจุหรือ noisy neighbor ในหลายเดือนหลังเปลี่ยน |
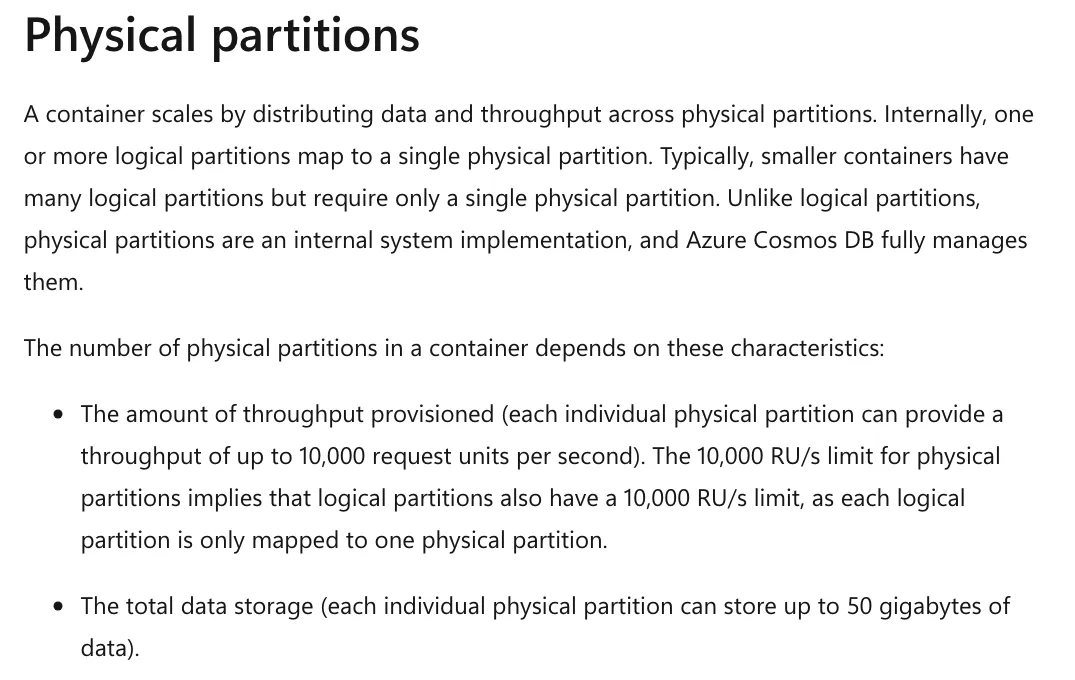
เอกสารของ Microsoft ระบุว่า physical partition หนึ่งรับ throughput ได้สูงสุด 10,000 RU/s และเก็บข้อมูลได้ 50 GB โดย throughput ของคอนเทนเนอร์ถูกแบ่งเท่ากันทุก partition OpenAI พบว่าเพดานนี้ใช้ร่วมกันทุก logical partition บน partition เดียวกัน และเมื่อข้อมูลโตจน partition แยกตัว throughput ต่อ partition ก็ลดลงครึ่งหนึ่ง ทั้งที่จำนวนคำขอไม่เปลี่ยน
Azure Cosmos DB ปรับอะไรให้ OpenAI Habitat
ทีม Azure กับ OpenAI แก้ปัญหาคอนเทนเนอร์รวมด้วย 3 อย่าง คือจำกัดคีย์ที่ร้อนที่สุดก่อนเพื่อไม่ให้คีย์เดียวกินทั้ง partition จัดลำดับความสำคัญของคำขอ (QoS) ให้งาน offline อย่างการนำเข้าข้อมูลจำนวนมากถูกจำกัดก่อนงานของผู้ใช้ และโหมด serverless แบบใหม่ที่ให้แต่ละ physical partition ขยายได้ถึง 10,000 RU/s จากเดิม 5,000 RU/s และแยก partition ตามการใช้ RU ได้ด้วย ไม่ใช่แค่ตามขนาดข้อมูล
OpenAI ระบุว่าบัญชี Cosmos DB ที่ใหญ่ที่สุดเก็บข้อมูลหลายสิบเพตะไบต์และรับคำขอกว่า 20 ล้านครั้งต่อวินาที เมื่อระบบใหญ่ขนาดนี้ บริการ managed ก็ "managed น้อยลง" ปลายปี 2024 ไฟฟ้าดับในภูมิภาคหลักของ Azure ทำให้พบว่าบัญชีใหญ่ต้องใช้เวลาหลายชั่วโมงในการ failover อีกราวหนึ่งเดือนต่อมา การย้ายกลับภูมิภาคเดิมทำให้ระบบล่มอีกครั้งเพราะการเชื่อมต่อพุ่งเข้า gateway พร้อมกัน ตอนนี้สองทีมเฝ้าระบบร่วมกันทุกชั้น ทดสอบบนบัญชีขนาดเท่าระบบจริง และเรียกหากันได้ตรงโดยไม่ผ่านระบบซัพพอร์ต
OpenAI Habitat ลดเวลาอ่านจาก 120 เหลือ 10 มิลลิวินาที
คำขอมากกว่า 90% ของ OpenAI Habitat เป็นการอ่าน OpenAI จึงวางกลยุทธ์เป็นชั้น ได้แก่ วางข้อมูลใกล้ผู้ใช้เมื่อศูนย์ข้อมูลมีความจุพอ ทำสำเนาเฉพาะชุดข้อมูลเล็กที่ต้องเร็วที่สุด เช่น ข้อมูลยืนยันตัวตนที่ใช้ทุกคำขอ ไปยังทั้ง 40 ภูมิภาค และใช้แคชแบบ lookaside บนเซิร์ฟเวอร์ Valkey ใกล้ผู้ใช้สำหรับข้อมูลที่เหลือ
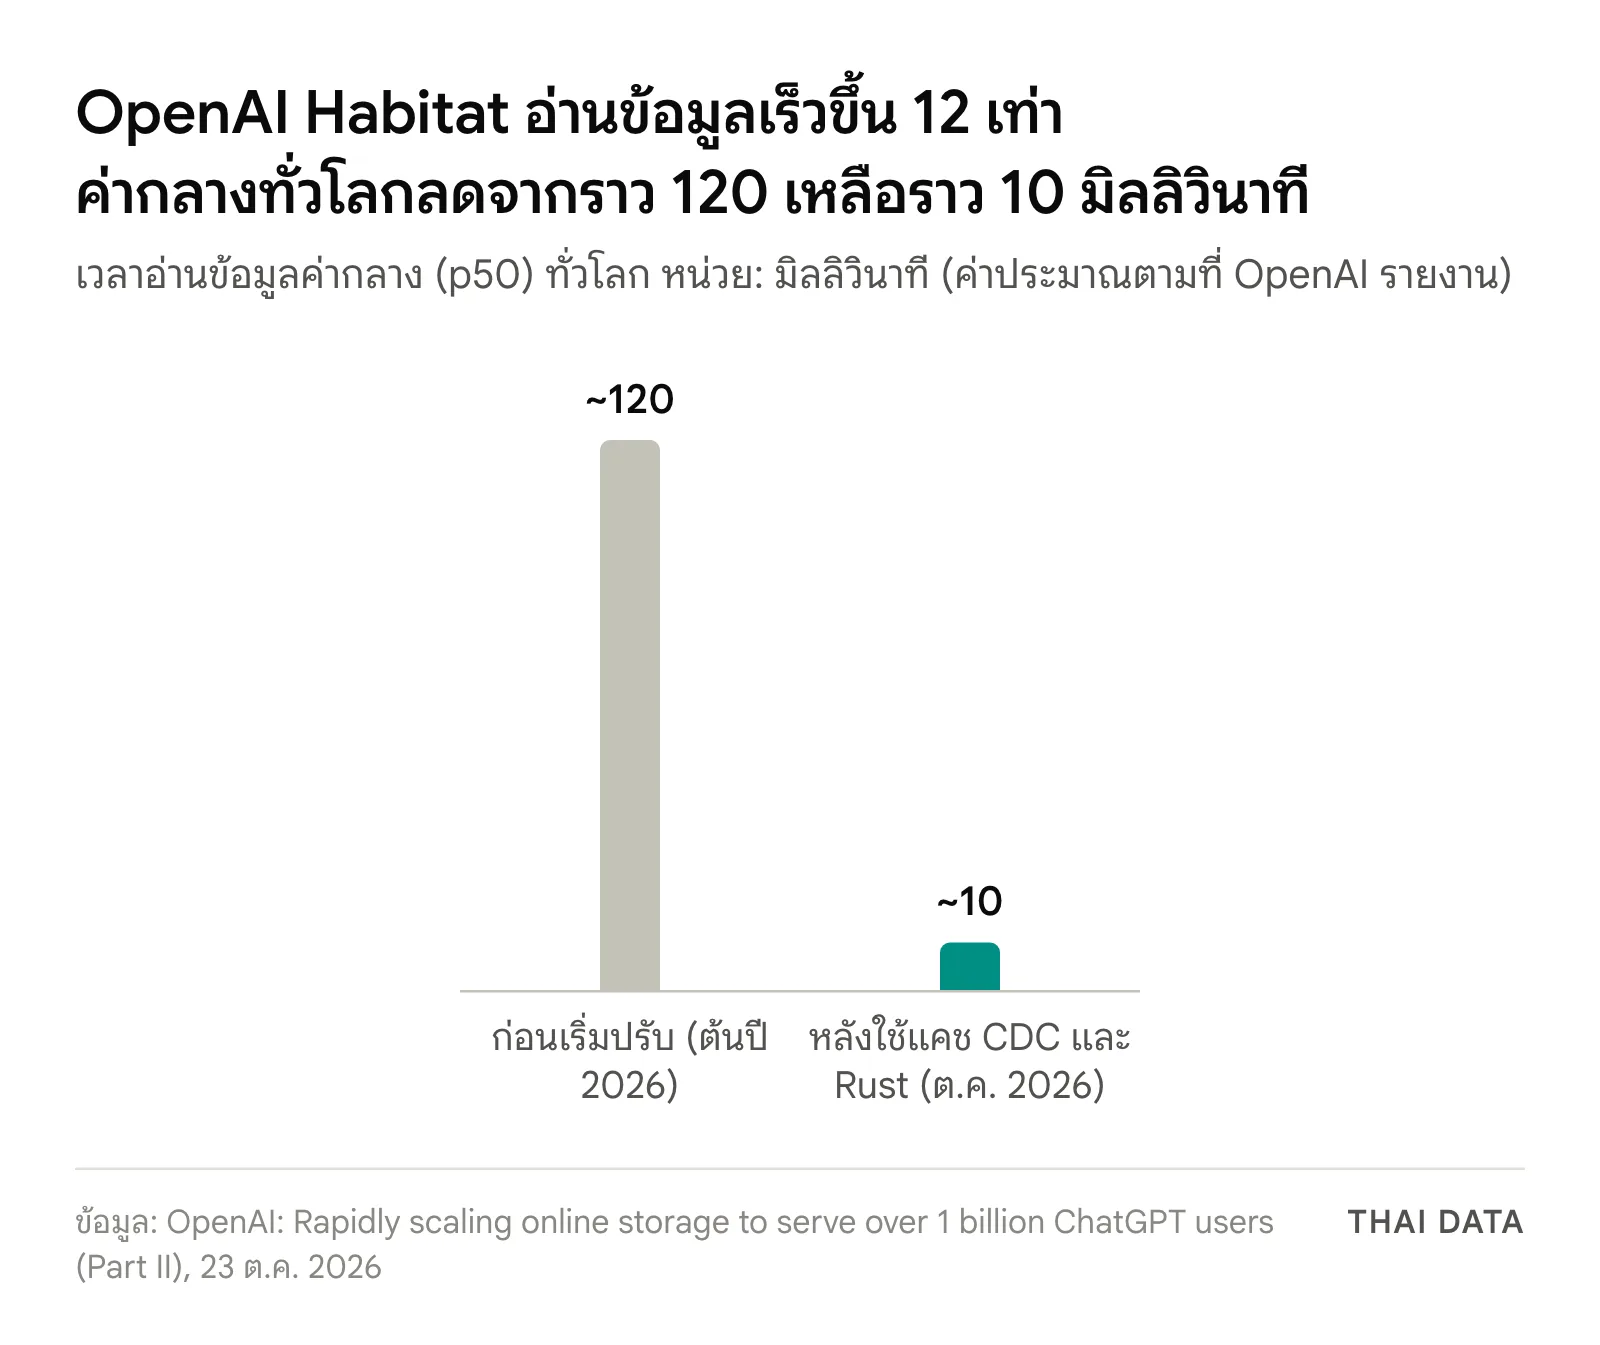
จุดต่างคือการล้างแคช OpenAI ไม่พึ่ง TTL อย่างเดียว แต่ใช้ change feed ของ Cosmos DB ส่งการเปลี่ยนแปลงไปล้างแคชทั่วโลกภายในไม่กี่วินาที แนวทางเดียวกับระบบ TAO ของ Meta ทำให้แคชตอบได้บ่อยแต่ข้อมูลไม่เก่า ร่วมกับการเขียนบริการ OpenAI Habitat ใหม่ด้วย Rust แทน Python ค่ากลาง (p50) ของเวลาอ่านทั่วโลกจึงลดจากราว 120 มิลลิวินาทีเหลือราว 10 มิลลิวินาที เร็วขึ้น 12 เท่านับจากต้นปี 2026 ส่วนระบบ CDC รับการเปลี่ยนแปลงหลายล้านรายการต่อวินาทีจากคอนเทนเนอร์หลายพันชุด ผ่าน Kafka กว่า 100 topic
ทำไมเรื่องนี้สำคัญ
ระบบที่หลายองค์กรคิดว่า "ฝากผู้ให้บริการคลาวด์ดูแลได้" มีขีดจำกัดเมื่อโตถึงจุดหนึ่ง และปัญหาส่วนใหญ่ของ OpenAI Habitat ไม่ได้มาจากขนาดข้อมูลอย่างเดียว แต่มาจากการออกแบบ partition key การแบ่งงานหลายรายบนทรัพยากรร่วม และการทดสอบ failover ที่ไม่เคยทำที่ขนาดจริง ขั้นต่อไป OpenAI กำลังสร้างระบบเก็บข้อมูลระดับเอกซะไบต์ของตัวเอง โดยใช้แกน RocksDB Cloud จาก Rockset กับการทำสำเนาแบบ Raft และใช้ document model เดียวกับ Cosmos DB เพื่อลดพื้นที่ flash ที่ต้องใช้ แลกกับ QPS สูงสุดที่ต่ำลง ใครที่ใช้ Valkey เป็นแคชอยู่แล้วอ่านต่อได้ที่การย้ายจาก Redis ไป Valkey ด้วย Percona Valkey Proxy
สิ่งที่องค์กรควรทำ
- อย่าให้ทีมผลิตภัณฑ์เลือก partition key เองอย่างอิสระ ถ้าหลายระบบใช้คีย์เดียวกันบนคอนเทนเนอร์รวม ต้องมีชั้นกลางที่แยกพื้นที่คีย์ให้
- แยกลำดับความสำคัญของงาน งาน batch การนำเข้าและส่งออกข้อมูลควรถูกจำกัดก่อนงานที่ผู้ใช้รออยู่ ตามแนวทางที่ OpenAI ทำร่วมกับทีม Azure
- ซ้อม failover และ failback ที่ขนาดจริง เหตุของ OpenAI เกิดตอนย้ายกลับ ไม่ใช่ตอนย้ายออก
- ใช้ CDC ล้างแคช แทนการพึ่ง TTL อย่างเดียว สำหรับข้อมูลที่อ่านบ่อยและต้องสด
- เมื่อระบบใหญ่ขึ้น ตกลงช่องทางวิศวกรกับผู้ให้บริการคลาวด์ล่วงหน้า และทดสอบการเปลี่ยนแปลงบนสภาพแวดล้อมขนาดเท่าของจริง
ติดตามข่าวฐานข้อมูลและแพลตฟอร์มข้อมูลได้ที่หมวดข้อมูล
คำถามที่พบบ่อย
OpenAI Habitat คืออะไร?
OpenAI Habitat คือแพลตฟอร์มเก็บข้อมูลออนไลน์ที่ OpenAI สร้างขึ้นให้ ChatGPT, API, Codex และบริการภายในอ่านเขียนข้อมูลได้เร็วและเสถียร ทำหน้าที่เป็นชั้นกลางที่ดูแลแคช สิทธิ์ การเข้ารหัส ที่ตั้งข้อมูล และการจำกัดคำขอ โดยมี Azure Cosmos DB เป็นที่เก็บข้อมูลหลัก รับผู้ใช้กว่า 1,000 ล้านคนใน 40 ภูมิภาค
OpenAI Habitat ลดเวลาตอบลงได้อย่างไร?
OpenAI ใช้สามชั้น คือวางข้อมูลใกล้ผู้ใช้เมื่อมีความจุพอ ทำสำเนาเฉพาะชุดข้อมูลเล็กที่ต้องเร็วมาก เช่น ข้อมูลยืนยันตัวตน ไปทุกภูมิภาค และใช้แคช Valkey ที่ล้างค่าผ่าน change data capture ภายในไม่กี่วินาที พร้อมเขียนบริการใหม่ด้วย Rust ทำให้ค่ากลางเวลาอ่านลดจากราว 120 เหลือราว 10 มิลลิวินาที
ปัญหา noisy neighbor ใน Azure Cosmos DB คืออะไร?
คือเมื่องานหนึ่งใช้ throughput ของ physical partition มากจนงานอื่นที่อยู่บน partition เดียวกันถูกจำกัดตาม เอกสารของ Microsoft ระบุว่า physical partition หนึ่งรับได้สูงสุด 10,000 RU/s และ logical partition ทุกตัวบน partition นั้นใช้เพดานร่วมกัน OpenAI พบว่างานของฟีเจอร์เล็กเคยกระทบการล็อกอินและสมัครสมาชิก
องค์กรไทยเรียนรู้อะไรจาก OpenAI Habitat ได้บ้าง?
ออกแบบ partition key ให้กระจายโหลด แยกลำดับความสำคัญของงานผู้ใช้กับงาน batch ทดสอบการ failover และ failback ที่ขนาดเท่าระบบจริง ใช้ change data capture ล้างแคชแทนการพึ่ง TTL อย่างเดียว และตกลงช่องทางวิศวกรกับผู้ให้บริการคลาวด์เมื่อระบบใหญ่ถึงระดับที่บริการ managed เริ่มไม่พอ
แหล่งอ้างอิง
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- OpenAI67Microsoft131Databricks15Meta36
- ผลิตภัณฑ์และเทคโนโลยี
- ChatGPT22Azure Cosmos DB2Microsoft Azure48Valkey4Rust15Python27
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ