
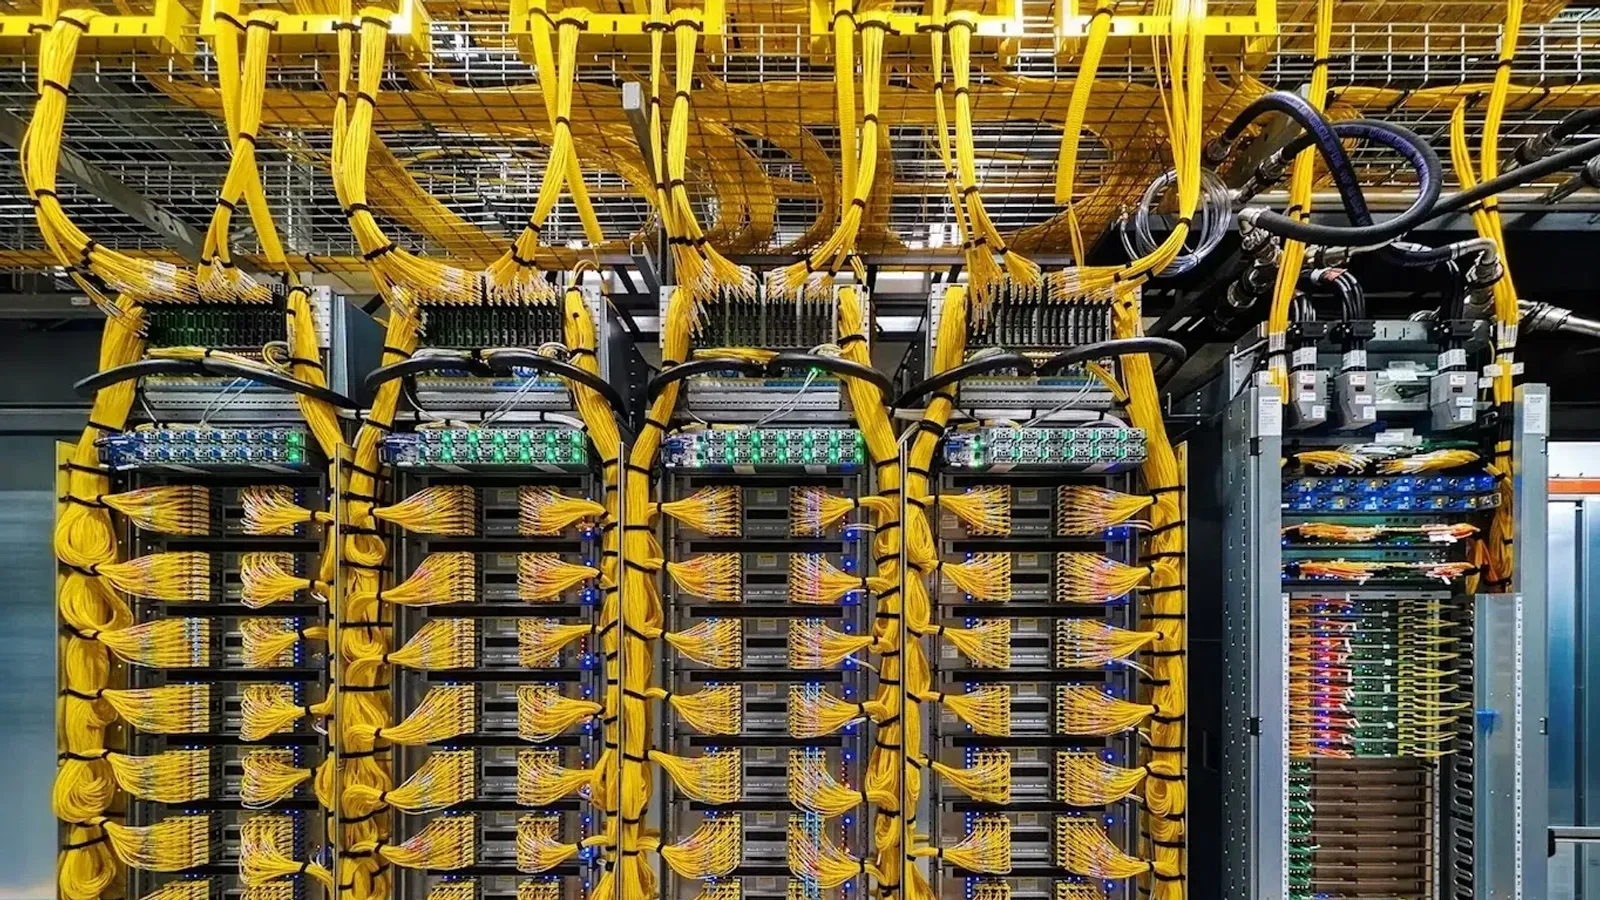
MLPerf Training v6.1 ที่ประกาศ 16 พ.ย. 2026 เป็นครั้งแรกของ Vera Rubin NVL72 ที่ NVIDIA ระบุว่าเร็วกว่า GB300 NVL72 สูงสุด 2 เท่าต่อ GPU
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- NVIDIA เผยผล MLPerf Training v6.1 เมื่อ 16 พฤศจิกายน 2026 เป็นครั้งแรกที่ Vera Rubin NVL72 เข้าทดสอบ และบอกว่าตนเป็นแพลตฟอร์มเดียวที่ส่งผลครบ 7 เกณฑ์วัด
- NVIDIA ระบุว่า Vera Rubin NVL72 เร็วกว่า GB300 NVL72 ต่อ GPU 1.4 ถึง 2 เท่า โดยสูงสุดที่ DeepSeek-V3 671B ใช้ 4.14 นาที เทียบกับ 8.03 นาทีที่ 1,024 GPU เท่ากัน
- ผลเร็วที่สุดแบบสัมบูรณ์ของรอบเป็นของ GB300 NVL72 10,240 GPU ที่ฝึก DeepSeek-V3 ได้ใน 1.38 นาที
- ใน MLPerf Endpoints v1.0 NVIDIA ระบุว่า Vera Rubin ให้ throughput ต่อกิโลวัตต์มากกว่า GB300 10 เท่า บนโมเดล Kimi K3 แต่ผลฝั่ง Vera Rubin ยังรอ MLCommons ตรวจสอบ
- ตัวเลขทั้งหมดในข่าวนี้มาจากบล็อกของ NVIDIA ซึ่งเป็นผู้ส่งผล ไม่ใช่รายงานของ MLCommons ที่เราเปิดอ่านไม่ได้
MLPerf Training v6.1 คือรอบวัดความเร็วฝึกโมเดล AI ที่ NVIDIA เผยผลเมื่อ 16 พฤศจิกายน 2026 และเป็นครั้งแรกที่ระบบ Vera Rubin NVL72 เข้าทดสอบ NVIDIA ระบุว่า Vera Rubin NVL72 เร็วกว่า GB300 NVL72 ต่อ GPU ตั้งแต่ 1.4 ถึง 2 เท่า และเป็นแพลตฟอร์มเดียวที่ส่งผลครบทั้ง 7 เกณฑ์วัดของรอบนี้ ตัวเลขทั้งหมดในข่าวมาจากบล็อกของ NVIDIA เอง เพราะหน้าผลของ MLCommons เปิดอ่านจากเครื่องของเราไม่ได้
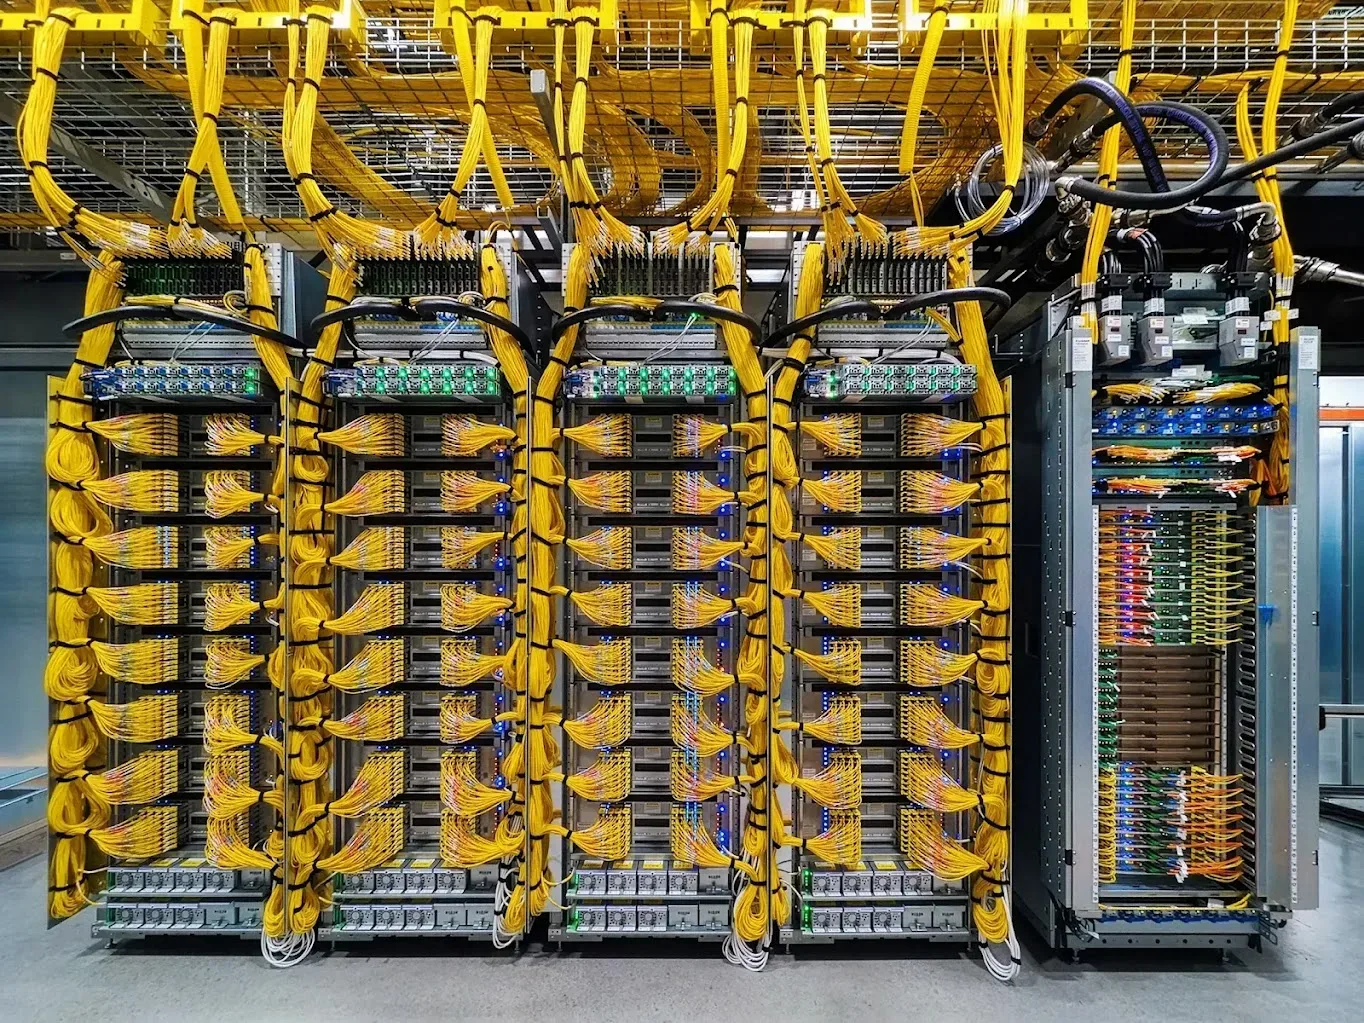
MLPerf Training v6.1 Vera Rubin เร็วกว่า GB300 เท่าไรต่อเกณฑ์วัด
MLPerf Training วัดว่าระบบใช้เวลานานแค่ไหนในการฝึกโมเดลให้ถึงระดับความแม่นยำที่กำหนด MLPerf Training v6.1 ครอบคลุมโมเดลภาษา การสร้างภาพ ระบบแนะนำสินค้า และ reinforcement learning ตามบล็อกของ NVIDIA บล็อกเทคนิคของ NVIDIA เทียบ Vera Rubin NVL72 กับ GB300 NVL72 ที่จำนวน GPU เท่ากัน ในหมวด closed division ผลคือเร็วกว่าต่อ GPU ในทุกเกณฑ์วัด
| เกณฑ์วัด (ชนิดโมเดล) | จำนวน GPU | Vera Rubin NVL72 เทียบ GB300 NVL72 |
|---|---|---|
| DeepSeek-V3 671B (MoE) | 1,024 | 2 เท่า |
| Llama 3.1 8B (dense) | 72 | 1.6 เท่า |
| gpt-oss 20B (MoE) | 64 | 1.6 เท่า |
| Llama 2 70B LoRA (dense) | 72 | 1.5 เท่า |
| FLUX.1 (diffusion) | 72 | 1.5 เท่า |
| Qwen3.5 397B GRPO (RL) | 64 | 1.4 เท่า |
| DLRMv4 (recommender) | 128 | 1.4 เท่า |
NVIDIA ชี้ว่าโมเดลที่ใหญ่และต้องสื่อสารระหว่างกันมากที่สุดได้ประโยชน์สูงสุด บน DeepSeek-V3 671B Vera Rubin NVL72 ฝึกเสร็จใน 4.14 นาทีด้วย 1,024 GPU บน 16 แร็ก ขณะที่ GB300 NVL72 ใช้ 8.03 นาทีที่การตั้งค่าเดียวกัน บริษัทระบุว่าที่ขนาดนี้ Vera Rubin ขยายจาก 256 เป็น 1,024 GPU ได้ประสิทธิภาพราว 97 เปอร์เซ็นต์ ทำให้เวลาฝึกลดจาก 16 นาทีเหลือราว 4 นาที
ผลเร็วที่สุดของรอบนี้ยังเป็นของ GB300
ผลเร็วที่สุดแบบสัมบูรณ์ในรอบนี้ไม่ใช่ของ Vera Rubin NVIDIA เขียนเองว่า GB300 NVL72 จำนวน 10,240 GPU ฝึก DeepSeek-V3 ได้ใน 1.38 นาที เป็นงานเดียวที่กระจายบน 160 แร็ก โดยแต่ละแร็กเป็นโดเมน NVLink ของตัวเอง บล็อกบอกว่า Microsoft Azure ส่งผลที่ขนาด 10,240 GPU เท่ากันด้วยระบบ GB200 ผู้ส่งผลร่วมกับ NVIDIA ในรอบ Training มี 20 องค์กร เช่น ASUS, Cisco, CoreWeave, Dell Technologies, Google Cloud, HPE, Oracle และ Supermicro
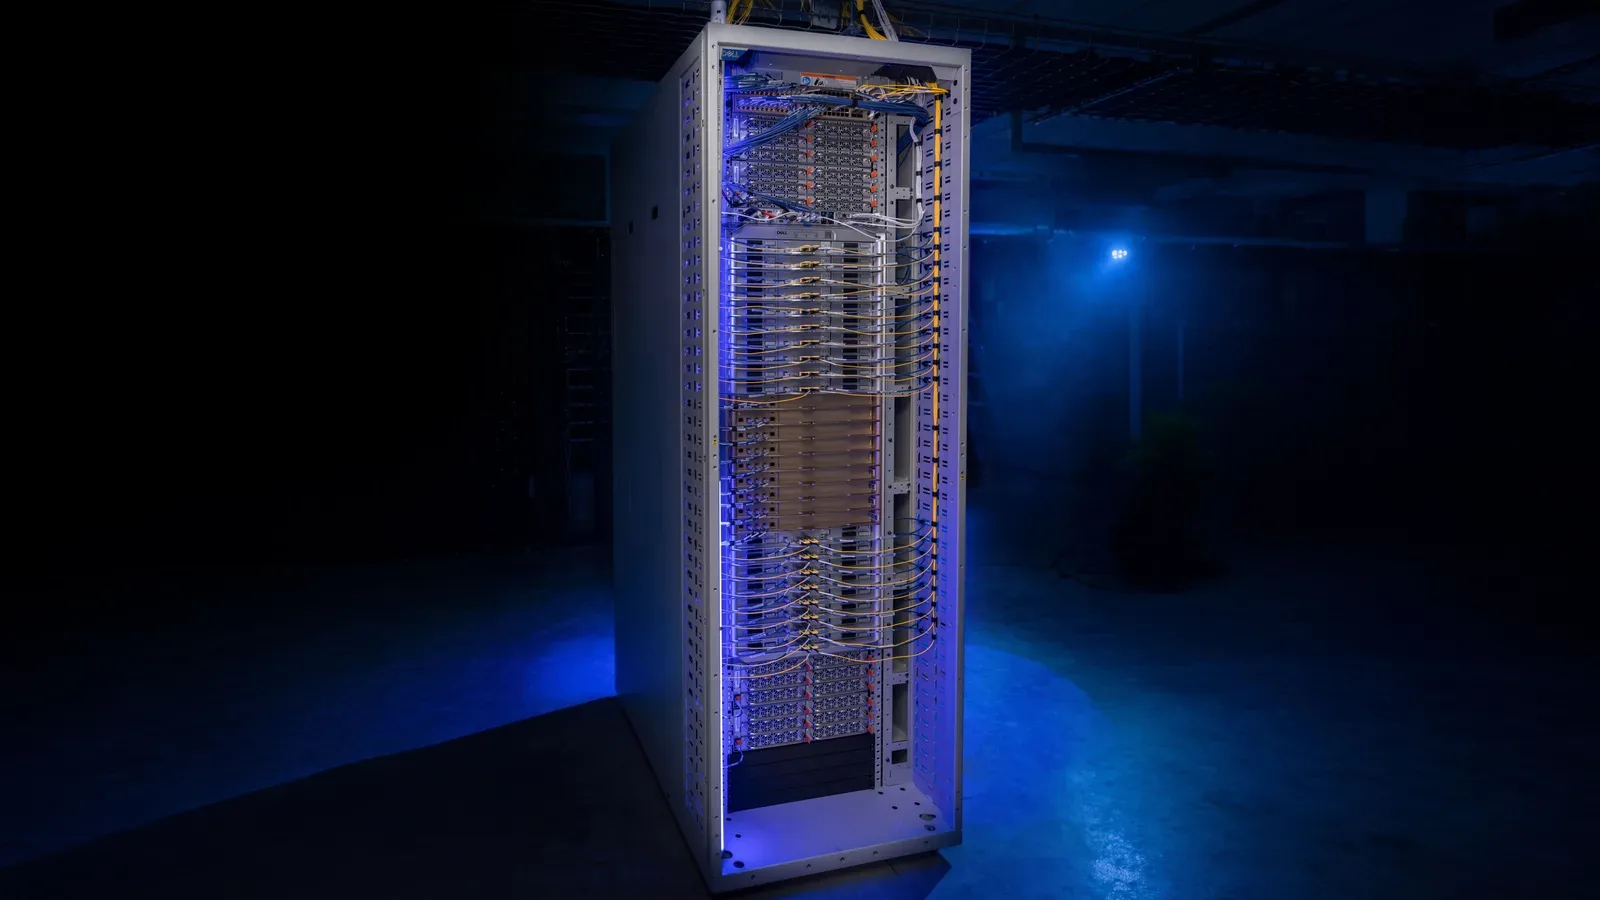
รอบนี้เพิ่มเกณฑ์วัดแรกของการฝึกหลังเทรน (post-training) ด้วย reinforcement learning คือ Qwen3.5 397B GRPO ซึ่งสะท้อนว่าการปรับโมเดลให้ทำงานแบบเอเจนต์เป็นงานหนักไม่แพ้การเทรนตั้งต้น NVIDIA รายงานว่า Vera Rubin NVL72 ใช้ 10.44 นาทีที่ 1,024 GPU เทียบกับ 13.78 นาทีของ GB300 NVL72 ที่ขนาดเดียวกัน และเสริมว่าซีพียู Vera ในแร็กเดียวรองรับสภาพแวดล้อมจำลอง RL พร้อมกันได้เกิน 22,500 รายการด้วยซีพียู 256 ตัว
MLPerf Endpoints: ตัวเลข 10 เท่าที่ยังรอการตรวจสอบ
NVIDIA ส่งผลเข้า MLPerf Endpoints v1.0 เป็นครั้งแรกเช่นกัน เกณฑ์วัดนี้ทดสอบงานเขียนโค้ดและงานธุรกิจแบบเอเจนต์ผ่าน API และตรวจว่าเอเจนต์ยังทำงานได้ถูกต้องหรือไม่ NVIDIA ระบุว่า Vera Rubin NVL72 ให้ throughput ต่อกิโลวัตต์ของกำลังไฟที่จัดสรรมากกว่า GB300 NVL72 ราว 10 เท่าบนโมเดล Kimi K3 ที่ความเร็วตอบสนองขั้นต่ำ 50 โทเค็นต่อวินาทีต่อผู้ใช้
| โมเดลใน MLPerf Endpoints v1.0 | throughput ต่อ kW (เท่า) | ความเร็วตอบสนอง (เท่า) |
|---|---|---|
| Kimi K3 | 10 | 3 |
| DeepSeek-V4.1-Flash | 9 | 5 |
| Qwen3.6-35B-A3B | 5 | 3 |
ตัวเลขนี้ต้องอ่านพร้อมเงื่อนไขที่ NVIDIA เขียนไว้ในเชิงอรรถ ผลของ Vera Rubin ยังเป็นผลเบื้องต้นที่รอ MLCommons ตรวจสอบและอาจเปลี่ยนได้ ส่วนผลของ GB300 ผ่านการตรวจสอบแล้ว นอกจากนี้ระบบที่เทียบกันมีขนาดต่างกัน ตัวอย่าง Kimi K3 ฝั่ง Vera Rubin ใช้ 32 ตัวเร่ง ที่ 1,024 คำขอพร้อมกัน ได้ 41,414.2 โทเค็นต่อวินาทีที่กำลังไฟ 100.89 กิโลวัตต์ ราว 410 โทเค็นต่อวินาทีต่อกิโลวัตต์ ฝั่ง GB300 ใช้ 48 ตัวเร่งที่ 48 คำขอพร้อมกัน ได้ 2,210.4 โทเค็นต่อวินาทีที่ 60 กิโลวัตต์ ราว 37 โทเค็นต่อวินาทีต่อกิโลวัตต์ (คำนวณจากตัวเลขในเชิงอรรถ) ผู้อ่านจึงไม่ควรตีความ 10 เท่าเป็นความเร็วของชิปเดี่ยว
Rubin HPC ในสัปดาห์เดียวกัน
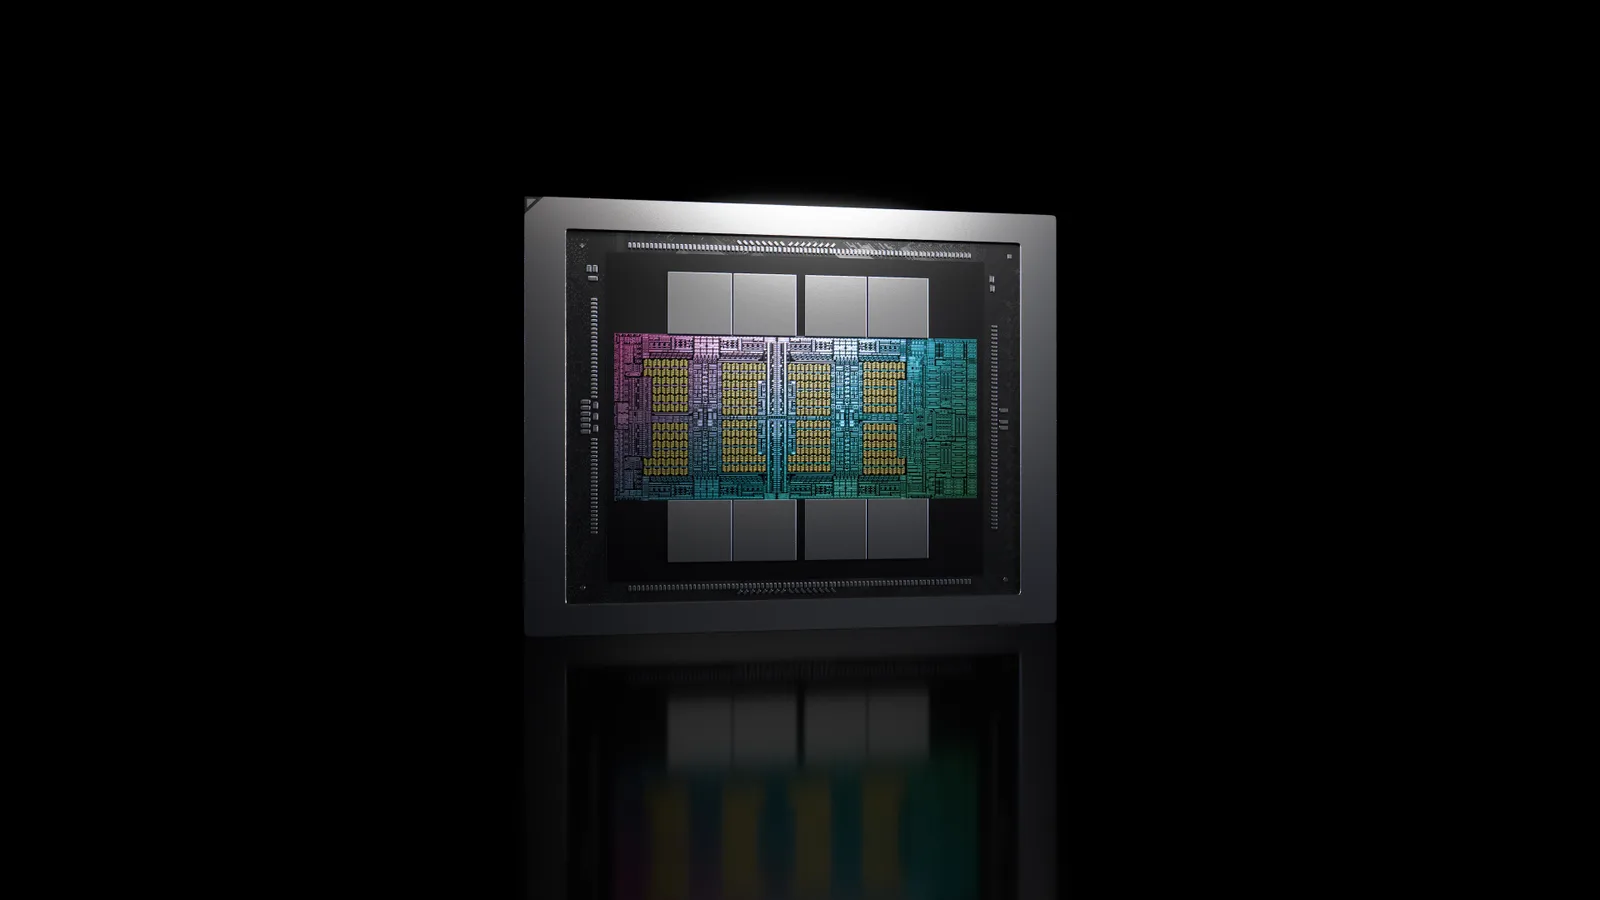
NVIDIA ประกาศ Rubin HPC ที่งาน SC26 เมื่อ 16 พฤศจิกายน เป็น GPU ใหม่ในแพลตฟอร์ม Vera Rubin สำหรับงานจำลองทางวิทยาศาสตร์ วิศวกรรม และการวิเคราะห์ข้อมูล บริษัทระบุว่ามี CUDA core เกิน 50,000 ตัวใน GPU เดียว มีความสามารถเร่งข้อมูลแบบเบาบาง และใช้ NVLink รุ่นที่เจ็ด คาดว่าจะพร้อมใช้ในปี 2028 ตามบล็อกของ NVIDIA ซึ่งยังไม่มีผลทดสอบอิสระของชิปนี้ และไม่เกี่ยวกับตัวเลขของ MLPerf Training v6.1 ข้างต้น ภาพข้างบนเป็นภาพประชาสัมพันธ์ ไม่ใช่ภาพถ่ายชิปจริงจากสายการผลิต
MLPerf Training v6.1 บอกอะไรองค์กรไทย
NVIDIA เองยังเขียนว่าหลังปิดรับผลของ v6.1 บริษัทรันเกณฑ์วัดบางข้อซ้ำบนฮาร์ดแวร์เดิมด้วยซอฟต์แวร์รุ่นใหม่กว่า แต่เป็นผลที่ไม่ได้ผ่าน MLCommons จึงไม่นับรวมในข่าวนี้
องค์กรไทยส่วนใหญ่ไม่ได้ซื้อแร็ก 72 GPU และไม่ได้ฝึกโมเดลระดับ 671 พันล้านพารามิเตอร์เอง แต่ผล MLPerf Training v6.1 มีสามเรื่องที่ใช้ตัดสินใจได้
- อ่านตัวเลขให้ตรงงานของตัวเอง ผลของ NVIDIA เทียบที่ GPU เท่ากันและเป็นงานที่ฝึกโมเดลใหญ่ งานปรับโมเดลขนาดเล็กหรืองานอนุมาน (inference) ให้ผลต่างกัน
- ถามเรื่องกำลังไฟ ตัวเลข throughput ต่อกิโลวัตต์ชี้ว่าต้นทุนหลักของระบบ AI คือไฟและความเย็นในห้องเครื่อง ไม่ใช่แค่ราคาการ์ด ข่าวเรื่องการแก้สเปก Vera Rubin HBM4 และตู้คอนเทนเนอร์ DSX POD ช่วยให้เห็นภาพการส่งมอบ
- รอผลที่ MLCommons ตรวจสอบ ผล Vera Rubin ฝั่ง Endpoints ยังเป็นผลเบื้องต้น ถ้าจะตั้งงบซื้อหรือเช่าควรรอผลที่ยืนยันแล้วและราคาจริงจากผู้ให้บริการ
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
ผลทดสอบแสดงว่าการเปลี่ยนรุ่น GPU แต่ละครั้งเปลี่ยนความเร็วและกำลังไฟมาก องค์กรไทยจึงควรวัดงานของตัวเองก่อนลงทุนซื้อการ์ด GPU Server ของ THAI DATA CLOUD ให้เช่าเครื่องประมวลผลด้วย NVIDIA Tesla T4 และ V100 บนคลาวด์ ใช้ทดลองงาน AI และ Deep Learning ได้โดยไม่ต้องซื้อการ์ดเอง (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
ติดตามข่าวชิปและเซิร์ฟเวอร์ AI ได้ที่หมวดฮาร์ดแวร์
คำถามที่พบบ่อย
MLPerf Training v6.1 คืออะไร ประกาศเมื่อไร?
MLPerf Training v6.1 คือรอบล่าสุดของการวัดว่าระบบใช้เวลาฝึกโมเดล AI ให้ถึงระดับความแม่นยำที่กำหนดนานแค่ไหน NVIDIA เผยผลของตนเมื่อ 16 พฤศจิกายน 2026 ซึ่งเป็นครั้งแรกที่ Vera Rubin NVL72 เข้าทดสอบ
Vera Rubin NVL72 เร็วกว่า GB300 NVL72 เท่าไรใน MLPerf Training v6.1?
NVIDIA ระบุว่าเร็วกว่าต่อ GPU 1.4 ถึง 2 เท่าบน 7 เกณฑ์วัด สูงสุด 2 เท่าที่ DeepSeek-V3 671B ซึ่ง Vera Rubin ใช้ 4.14 นาทีที่ 1,024 GPU ส่วน GB300 ใช้ 8.03 นาทีที่จำนวน GPU เท่ากัน
ผล MLPerf Training v6.1 ของ Vera Rubin ผ่านการตรวจสอบแล้วหรือยัง?
ผลของ MLPerf Training v6.1 ที่ NVIDIA อ้างถึงดึงจากเว็บ MLCommons เมื่อ 16 พ.ย. 2026 ส่วนผล MLPerf Endpoints v1.0 ของ Vera Rubin NVIDIA ระบุว่ายังเป็นผลเบื้องต้นที่รอ MLCommons ตรวจสอบ และอาจเปลี่ยนได้
ผลเร็วที่สุดของ MLPerf Training v6.1 เป็นของระบบไหน?
ตามบล็อกของ NVIDIA ผลเร็วที่สุดแบบสัมบูรณ์ของรอบนี้คือ GB300 NVL72 จำนวน 10,240 GPU ที่ฝึก DeepSeek-V3 671B ได้ใน 1.38 นาที เป็นงานเดียวที่กระจายบน 160 แร็ก
องค์กรไทยซื้อ Vera Rubin NVL72 ได้เมื่อไร?
บล็อกของ NVIDIA ที่เราเปิดอ่านไม่ได้ระบุวันวางขายหรือราคา ข่าวก่อนหน้าของเราสรุปสเปกที่ NVIDIA ปรับก่อนส่งมอบ องค์กรควรสอบถามผู้ผลิตเซิร์ฟเวอร์และผู้ให้บริการคลาวด์โดยตรง
แหล่งอ้างอิง
- NVIDIA Sweeps MLPerf Training and Endpoints as Vera Rubin Debuts With Leading Performance — NVIDIA Blog
- NVIDIA Vera Rubin NVL72 Achieves up to 2x Blackwell Ultra Performance in MLPerf Training v6.1 — NVIDIA Technical Blog
- NVIDIA Vera Rubin NVL72 Leads Agentic Inference Performance on MLPerf Endpoints v1.0 — NVIDIA Technical Blog
- NVIDIA Announces Rubin HPC — A New GPU to Accelerate Agents for Science, Engineering and Analytics — NVIDIA Blog
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ