
JetBrains เปิด Junie Local RTX Spark ตั้งแต่วันแรก AI เขียนโค้ดฟรีที่โค้ดไม่ออกนอกเครื่อง
JetBrains เปิด Junie Local RTX Spark ตั้งแต่ 16 ต.ค. 2026 และรองรับ Windows แบบ stable บนการ์ด RTX 24 GB เป็น AI เขียนโค้ดฟรีที่โค้ดไม่ออกนอกเครื่อง
โดย กองบรรณาธิการ THAI DATA อ่าน 4 นาที
สรุปประเด็นสำคัญ
- JetBrains ประกาศเมื่อ 16 ตุลาคม 2026 ว่า Junie Local เอเจนต์เขียนโค้ดที่รันโมเดลในเครื่อง รองรับ NVIDIA RTX Spark ตั้งแต่วันวางขาย และการรองรับ Windows ขยับจาก experimental เป็น stable
- การทดสอบของ JetBrains บน RTX Spark ได้ความเร็วสร้างข้อความสูงสุด 55 token ต่อวินาที โดยใช้ FP8 บน Tensor Core ของ Blackwell และ speculative decoding
- เครื่องที่ใช้ได้ต้องมีหน่วยความจำให้ GPU อย่างน้อย 24 GB ไดรเวอร์ NVIDIA 581 ขึ้นไป และพื้นที่ดิสก์ราว 20 GB สำหรับโมเดล ใช้ได้กับการ์ดตระกูล Ampere ขึ้นไป เช่น RTX 3090, 4090 และ 5090
- Junie Local ใช้ฟรี ไม่ต้องลงทะเบียน ไม่มีค่า token หรือโควตา เลือกโมเดลได้ 2 ตัว คือ Qwen3.6-27B และ Qwen3.8-3.6-27B-blend ที่ JetBrains รวมขึ้นเอง
JetBrains ประกาศเมื่อ 16 ตุลาคม 2026 ว่า Junie Local รองรับเครื่อง NVIDIA RTX Spark ตั้งแต่วันวางขาย ทำให้ Junie Local RTX Spark เป็นเอเจนต์เขียนโค้ดที่รันโมเดลบนเครื่องได้เต็มรูปแบบ พร้อมขยับการรองรับ Windows จาก experimental เป็น stable บนการ์ด NVIDIA RTX ที่มีหน่วยความจำ 24 GB ขึ้นไป และใช้ได้ฟรี
ผู้ใช้ติดตั้ง Junie แล้วพิมพ์ /local ก็ได้เอเจนต์ที่อ่านโค้ด แก้ไฟล์ และรันเทสต์บนเครื่องของตัวเอง JetBrains ระบุว่าไม่มีค่า token ไม่มีโควตา และโค้ดไม่ออกนอกเครื่อง บริษัทขอบคุณ NVIDIA ที่ให้ทดลองใช้เครื่องก่อนวางขาย
Junie Local RTX Spark ทำความเร็วได้เท่าไร
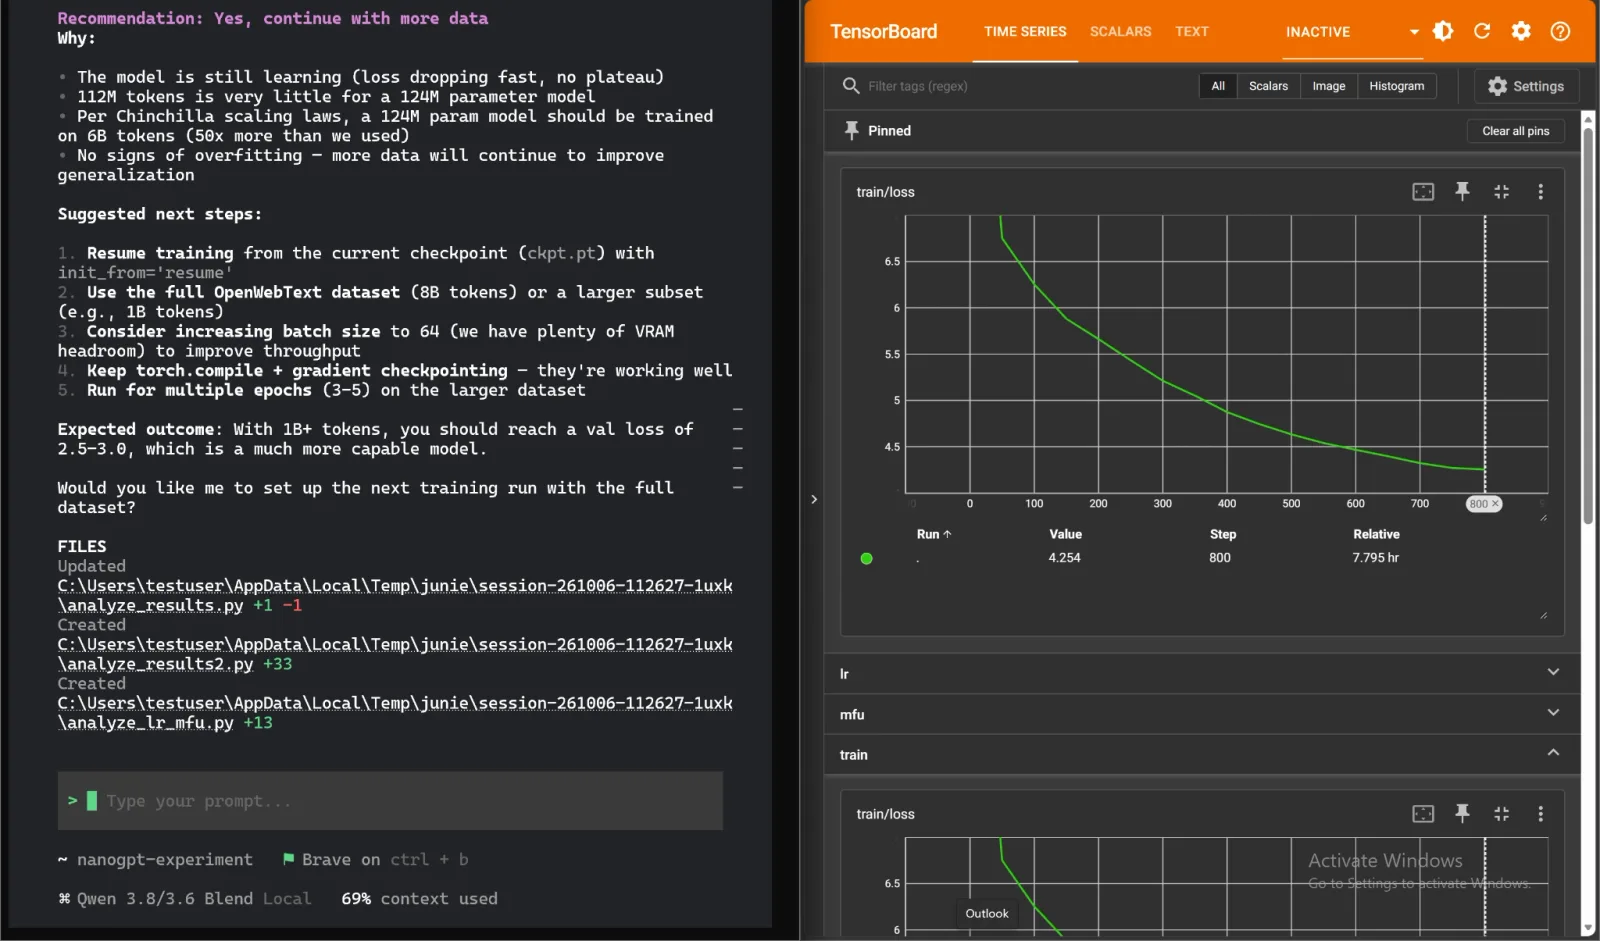
RTX Spark เป็นแพลตฟอร์มของ NVIDIA ที่จับคู่ GPU RTX สถาปัตยกรรม Blackwell กับ CPU Grace สำหรับรันโมเดล AI ขนาดใหญ่ในเครื่องบางเบา (อ่านข่าว RTX Spark วางขาย) ในการทดสอบของ JetBrains Junie Local RTX Spark สร้างข้อความได้สูงสุด 55 token ต่อวินาที บริษัทเรียกตัวเลขนี้ว่าค่าเริ่มต้นของแพลตฟอร์ม และกำลังพัฒนาการ inference ให้เร็วขึ้นอีก
- ขนาด context ตามหน่วยความจำ Junie Local เลือก context window ให้ใหญ่ที่สุดเท่าที่หน่วยความจำ GPU ของเครื่องรองรับ เครื่องที่มีหน่วยความจำมากจึงเก็บโค้ด ผลลัพธ์ของเครื่องมือ และประวัติการสนทนาได้มากขึ้น
- FP8 บน Tensor Core ใช้ Tensor Core ของ Blackwell ประมวลผลแบบ FP8 เพื่ออ่าน context ได้เร็วขึ้น
- speculative decoding ร่าง token ล่วงหน้าหลายตัวแล้วตรวจพร้อมกัน เพื่อเร่งการสร้างข้อความ
เครื่องที่ใช้ Junie Local RTX Spark และพีซี Windows ได้
ตอนเปิดตัวในเดือนสิงหาคม Junie Local ต้องใช้ Mac ชิป M5 ที่มีหน่วยความจำ 64 GB เดือนกันยายน JetBrains เพิ่มการรองรับ Windows แบบ experimental สำหรับการ์ด RTX ที่มี VRAM 24 GB และรอบนี้เปลี่ยนเป็น stable พร้อมเขียนตัวติดตั้งและ engine ในเครื่องใหม่
| เครื่อง | สิ่งที่ต้องมี |
|---|---|
| NVIDIA RTX Spark | Windows 11 on Arm และหน่วยความจำที่ GPU ใช้ได้อย่างน้อย 24 GB |
| พีซี Windows ที่มีการ์ด NVIDIA RTX | Windows 11 x64 และการ์ด RTX ที่มี VRAM อย่างน้อย 24 GB ตระกูล Ampere ขึ้นไป เช่น RTX 3090, 4090 หรือ 5090 ที่มี 32 GB |
| ทุกเครื่อง | ไดรเวอร์ NVIDIA 581 ขึ้นไป และพื้นที่ดิสก์ว่างราว 20 GB สำหรับโมเดล |
ตัวติดตั้งตรวจเครื่อง GPU และไดรเวอร์ให้เอง แล้วติดตั้ง engine สำหรับ inference โมเดล และการเชื่อมกับ Junie ผู้ใช้เลือกโมเดลได้ 2 ตัว คือ Qwen3.6-27B และ Qwen3.8-3.6-27B-blend ซึ่ง JetBrains สร้างโดยรวมน้ำหนักของสองโมเดลในสัดส่วนเท่ากัน และจะเพิ่มโมเดลอื่นในอนาคต
โมเดลรวมที่คิดน้อยลงแต่ทำงานได้มากขึ้น
บล็อกของ JetBrains เมื่อ 18 กันยายนอธิบายว่า Qwen3.8 ทำงานสำเร็จมากกว่า Qwen3.6 แต่ต้องเปิดโหมด reasoning ทำให้ใช้เวลาราว 4 เท่า จึงรวมสองโมเดลเป็น Qwen3.8-3.6-27B-blend ในชุดทดสอบเขียนโค้ด 100 งานของบริษัท โมเดลรวมทำสำเร็จ 37 งาน เทียบกับ 34 งานของ Qwen3.6 และ 39 งานของ Qwen3.8 แต่สร้าง token ออกมาน้อยกว่า Qwen3.8 ถึง 71%
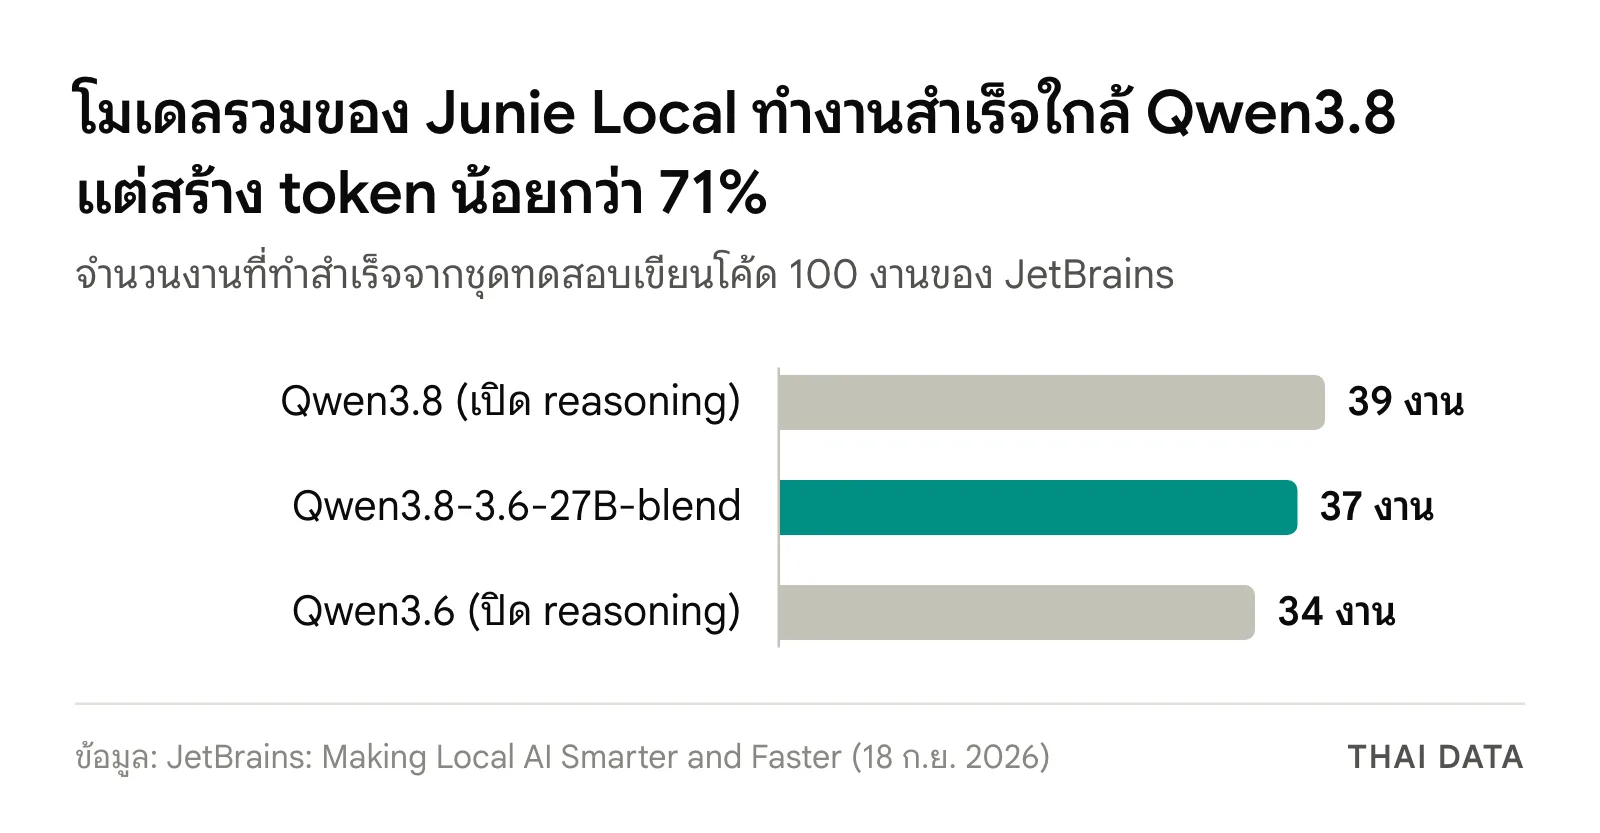
เมื่อเทียบเฉพาะ 30 งานที่ทั้งสองโมเดลทำสำเร็จ โมเดลรวมใช้ token ราว 279,000 ตัว เทียบกับราว 935,000 ตัวของ Qwen3.8 หรือน้อยกว่าราว 70% และใช้น้อยกว่าใน 29 จาก 30 งาน JetBrains สร้างโมเดลนี้ด้วยการรวมน้ำหนักเฉย ๆ โดยไม่ได้เทรนเพิ่ม และยังทดลองวิธีอื่น เช่น distillation และ reinforcement learning ต่อ
ติดตั้งและสิ่งที่ JetBrains จะทำต่อ
การติดตั้งบน Windows ทำผ่านคำสั่ง PowerShell บรรทัดเดียวตามที่บล็อกของ JetBrains ให้ไว้ จากนั้นเปิด Junie พิมพ์ /model แล้วเลือกโมเดล ระบบจะดาวน์โหลดสิ่งที่ต้องใช้ เปิด engine ในเครื่อง และย้ายการทำงานไปใช้โมเดลในเครื่องให้เอง JetBrains บอกว่าจะเพิ่มตัวเลือกโมเดลในเครื่อง ลดเวลาและหน่วยความจำที่ใช้ต่องาน และสำหรับ RTX Spark จะลองรูปแบบโมเดลที่ประหยัดกว่าเดิมและปรับ speculative decoding ให้ใช้กำลังของ GPU ได้เต็มขึ้น
ทำไมเรื่องนี้สำคัญ
องค์กรจำนวนมากยังไม่ให้นักพัฒนาใช้ AI เขียนโค้ดผ่านคลาวด์ เพราะต้องส่งซอร์สโค้ดออกไปยังผู้ให้บริการภายนอก Junie Local RTX Spark และการรองรับการ์ด RTX 24 GB ทำให้มีทางเลือกที่โค้ดอยู่ในเครื่องทั้งหมด และไม่มีค่า token ที่ผันแปรตามการใช้งาน แลกกับความเร็วและความสามารถที่ยังต่ำกว่าโมเดลขนาดใหญ่บนคลาวด์ และต้นทุนฮาร์ดแวร์ที่ต้องมี GPU หน่วยความจำสูง
สิ่งที่องค์กรควรทำ
- ทดลอง Junie Local RTX Spark หรือบนเวิร์กสเตชันเดิมกับโปรเจกต์ที่ห้ามส่งโค้ดออกนอกองค์กร เช่น ระบบที่มีข้อมูลส่วนบุคคลหรือโค้ดที่เป็นความลับทางการค้า แล้ววัดว่าคุณภาพพอใช้งานหรือไม่
- สำรวจเครื่องที่มีอยู่ เวิร์กสเตชันที่มีการ์ด RTX 3090, 4090 หรือ 5090 ใช้ Junie Local ได้โดยไม่ต้องซื้อเครื่องใหม่ ถ้าอัปเดตไดรเวอร์เป็น 581 ขึ้นไป
- กำหนดนโยบายการใช้ AI เขียนโค้ดในเครื่อง ให้ชัดว่าใช้กับโค้ดชุดใดได้ และใครต้องตรวจโค้ดที่ AI สร้างก่อน merge
- เทียบต้นทุนรวม ระหว่างค่าฮาร์ดแวร์ GPU กับค่าบริการ AI เขียนโค้ดบนคลาวด์รายเดือนของทีม ก่อนตัดสินใจขยายผล
ติดตามข่าวเครื่องมือนักพัฒนา โอเพนซอร์ส และ DevOps เพิ่มเติมได้ที่หมวดซอฟต์แวร์
คำถามที่พบบ่อย
Junie Local RTX Spark คืออะไร?
Junie Local RTX Spark คือการที่ JetBrains ทำให้ Junie Local เอเจนต์เขียนโค้ดที่รันโมเดลในเครื่อง ใช้งานบนเครื่อง NVIDIA RTX Spark ได้ตั้งแต่ 16 ตุลาคม 2026 Junie Local อ่านโค้ด แก้ไฟล์ และรันเทสต์ได้เอง โดยโค้ดไม่ออกนอกเครื่องและไม่มีค่า token
Junie Local ต้องใช้เครื่องสเปกเท่าไร?
Junie Local RTX Spark และรุ่นสำหรับพีซีทั่วไปต้องใช้ Windows 11 กับหน่วยความจำที่ GPU ใช้ได้อย่างน้อย 24 GB ทั้งบนเครื่อง RTX Spark ที่เป็น Windows on Arm และบนพีซี x64 ที่มีการ์ด NVIDIA RTX ตระกูล Ampere ขึ้นไป เช่น RTX 3090 หรือ 4090 ต้องใช้ไดรเวอร์ 581 ขึ้นไปและพื้นที่ดิสก์ราว 20 GB
Junie Local RTX Spark ทำงานเร็วแค่ไหน?
JetBrains รายงานว่า Junie Local RTX Spark สร้างข้อความได้สูงสุด 55 token ต่อวินาทีในการทดสอบของบริษัท และบอกว่าเป็นตัวเลขเริ่มต้น เพราะกำลังพัฒนาการ inference เพิ่ม ส่วนขนาด context ระบบจะเลือกให้ใหญ่ที่สุดเท่าที่หน่วยความจำ GPU รองรับ
Junie Local มีค่าใช้จ่ายหรือไม่?
ไม่มี JetBrains ระบุว่า Junie Local ทั้งแบบ Junie Local RTX Spark และบนพีซีที่มีการ์ด RTX ใช้ฟรี ไม่ต้องลงทะเบียน ไม่ต้องสมัครสมาชิก ไม่ใช้เครดิตและไม่ต้องใช้บัตร ค่าใช้จ่ายที่องค์กรต้องคิดคือฮาร์ดแวร์ที่มี GPU หน่วยความจำ 24 GB ขึ้นไป
แหล่งอ้างอิง
- Junie Local Comes to the NVIDIA RTX Spark — JetBrains
- Making Local AI Smarter and Faster — JetBrains
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- NVIDIA35
- ผลิตภัณฑ์และเทคโนโลยี
- RTX Spark6Windows34Blackwell9Windows 1113Windows on Arm3
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ