
DeepSeek DeepInfer เปิดซอร์ส เอนจินที่คลัสเตอร์เดียวรับงานวันละ 155 ล้านล้านโทเคน
DeepSeek DeepInfer เฟรมเวิร์กอนุมานที่รัน DeepSeek V4.1 Flash เปิดซอร์สแบบ Apache 2.0 เมื่อ 20 ต.ค. 2026 รองรับ GPU NVIDIA SM100 และ Huawei Ascend 950
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- DeepSeek เปิดซอร์ส DeepSeek DeepInfer บน GitHub เมื่อ 20 ตุลาคม 2026 ภายใต้สัญญาอนุญาต Apache 2.0 เป็นเฟรมเวิร์กอนุมาน (inference) ตัวเดียวกับที่ให้บริการ DeepSeek V4.1 Flash
- เอกสารของ DeepSeek ระบุว่าคลัสเตอร์เดียวที่ใช้ DeepSeek DeepInfer รับงานวันละ 155 ล้านล้านโทเคน และสร้างรายได้รวม 38 ดอลลาร์สหรัฐต่อ GPU-ชั่วโมง เมื่อคิดที่ราคาช่วงต่ำ (valley pricing)
- รุ่นที่เปิดรองรับเฉพาะ DeepSeek-V4.1-Flash บน GPU NVIDIA SM100 และ NPU Huawei Ascend 950 และทำได้เฉพาะการอนุมานแบบ offline
- ส่วนที่ยังไม่เปิดคือระบบ KV cache การแยก prefill/decode และตัวกระจายโหลด ส่วนหน่วยติดตั้งเล็กที่สุดที่ยังมีประสิทธิภาพตามเอกสารของ DeepSeek คือ GPU 64 ตัวสำหรับ prefill และ 64 ตัวสำหรับ decode
- DeepSeek เผยแพร่ deepseek-recipe ไลบรารี Rust สำหรับแปลงคำขอ API กับโทเคนคู่กัน เพื่อให้ผู้ที่ติดตั้งเองได้พฤติกรรม API ตรงกับบริการทางการ
DeepSeek เปิดซอร์ส DeepSeek DeepInfer เฟรมเวิร์กอนุมานที่บริษัทใช้ให้บริการโมเดล DeepSeek V4.1 Flash บน GitHub เมื่อวันที่ 20 ตุลาคม 2026 ภายใต้สัญญาอนุญาต Apache 2.0 เอกสารประกอบระบุว่าคลัสเตอร์เดียวที่ใช้ระบบนี้รับงานวันละ 155 ล้านล้านโทเคน ผู้ให้บริการรายอื่นจึงนำเอนจินที่ DeepSeek ใช้จริงไปรันโมเดลเองได้ แม้บางส่วนของระบบยังไม่เปิด
DeepSeek เคยเปิดซอร์สภาษา TileLang และไลบรารี kernel สำหรับงานอนุมานหลายตัวมาก่อน เช่น FlashMLA, DeepGEMM และ DeepEP ครั้งนี้เป็นการเปิดตัวเอนจินที่ประกอบชิ้นส่วนเหล่านั้นเข้าด้วยกัน README บอกว่า DeepSeek DeepInfer สร้างบน vLLM เป็นหลัก และได้แนวคิดเพิ่มจาก SGLang กับ TensorRT-LLM ณ ค่ำวันที่ 20 ตุลาคม โปรเจกต์มีผู้กดดาวบน GitHub ราว 7,000 ครั้ง
DeepSeek DeepInfer มีความสามารถอะไรบ้าง
รุ่นที่เปิดรองรับโมเดลเดียวคือ DeepSeek-V4.1-Flash โดยค่าเริ่มต้นใช้ checkpoint รุ่น DeepSeek-V4.1-Flash-1017 ตัวเดียวกับที่อยู่ในข่าว DeepSeek Search API และ V4.1 Flash รุ่น 1017 ความสามารถหลักตาม README มีดังนี้
- kernel ที่ปรับแต่งแล้ว ทั้ง FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect และ kernel ที่เขียนด้วย TileLang
- การกระจายงาน แบบ data parallel ในส่วน attention และ expert parallel พร้อมตัวถ่วงโหลด (EPLB) ในส่วน MoE
- DSpark speculative decoding ที่ใช้ค่าความมั่นใจเลือกว่าจะตรวจโทเคนร่างตัวไหน
- SWA bounded replay คำนวณซ้ำเฉพาะช่วงท้ายของข้อความ เพื่อลดงาน prefill
- ผลลัพธ์ที่ทำซ้ำได้ (batch-invariant และ deterministic sampling) ใช้ได้เฉพาะฝั่ง NVIDIA
- Structured outputs บังคับให้คำตอบตรงตาม regex, JSON schema หรือ EBNF
| รายการ | ข้อกำหนดตาม README |
|---|---|
| ฮาร์ดแวร์ | GPU NVIDIA SM100, NPU Huawei Ascend 950 |
| ระบบปฏิบัติการและภาษา | Linux, GCC 13 ขึ้นไป, Python 3.12 |
| ไดรเวอร์ | CUDA 13 (NVIDIA), CANN 9.2 (Ascend) |
| การทดสอบความเร็ว | prefill บน GPU 4 ตัว, decode บน GPU 64 ตัว |
| สัญญาอนุญาต | Apache 2.0 |
ส่วนที่ DeepSeek ยังไม่เปิด
DeepSeek DeepInfer รุ่นนี้ทำได้เฉพาะการอนุมานแบบ offline เท่านั้น ส่วนที่ README ระบุว่าจำเป็นต่อบริการเต็มรูปแบบแต่ยังไม่รวมไว้มี 3 ส่วน คือระบบ KV cache การแยกงาน Vision Encoder/Prefill/Decode ออกจากกัน (บริษัทบอกว่าเอนจินมีความสามารถที่ต้องใช้เกือบครบแล้ว) และการกระจายโหลดระหว่างชุด data parallel ทั้งฝั่ง prefill และ decode
เอกสารถาม-ตอบอธิบายว่าส่วนจัดการ KV cache กับตัวกระจายโหลดผูกกับโครงสร้างพื้นฐานภายในของบริษัทอย่างแน่น จึงยังเปิดโค้ดไม่ได้ทั้งหมด แต่เล่าการออกแบบไว้ในบล็อกบน Zhihu แทน DeepSeek ยังบอกว่าโค้ดอนุมานของโมเดลรุ่นต่อไปและงานปรับความเร็วหลังจากนี้จะเปิดผ่าน DeepSeek DeepInfer ต่อไป
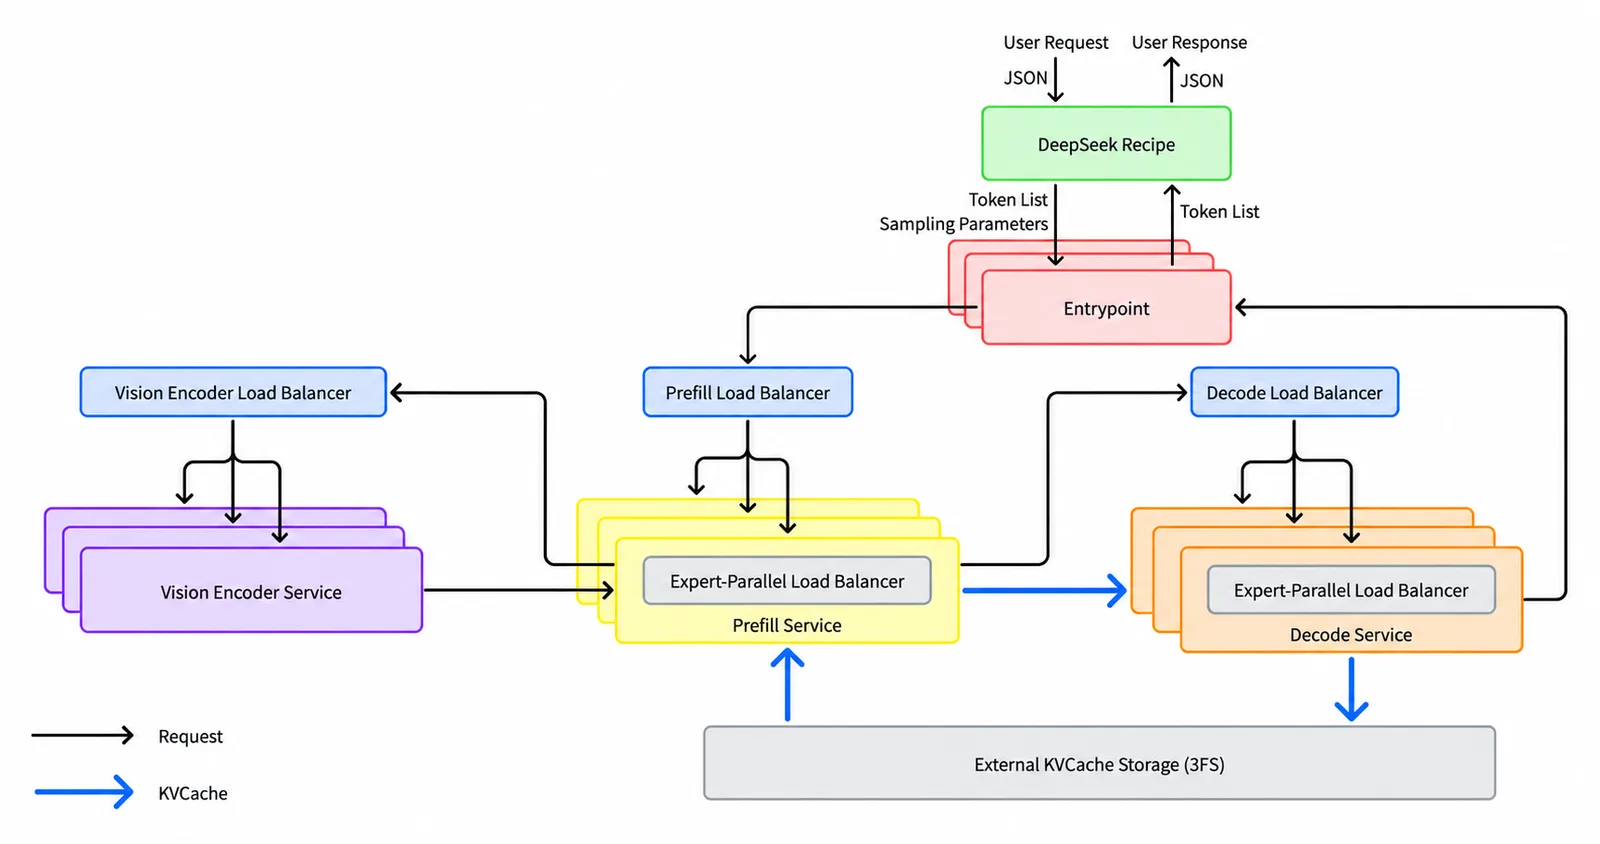
ในภาพนี้ ส่วนที่ DeepSeek DeepInfer รุ่นเปิดซอร์สทำได้คือเอนจินภายในบริการ Prefill และ Decode ส่วนกล่องตัวกระจายโหลดและที่เก็บ KV cache ภายนอกคือส่วนที่ผู้ใช้ต้องสร้างเอง
ตัวเลขจากระบบจริงที่รันด้วย DeepSeek DeepInfer
เอกสาร DeepSeek V4.1 Flash Inference Deployment Q&A ที่มากับโค้ดชุดนี้เปิดตัวเลขจากระบบที่ให้บริการจริงไว้หลายรายการ
| ประเด็น | ตัวเลขที่ DeepSeek ระบุ |
|---|---|
| ปริมาณงานของคลัสเตอร์เดียว | 155 ล้านล้านโทเคนต่อวัน |
| รายได้รวมต่อ GPU | 38 ดอลลาร์สหรัฐต่อ GPU-ชั่วโมง (คิดที่ราคาช่วงต่ำ) |
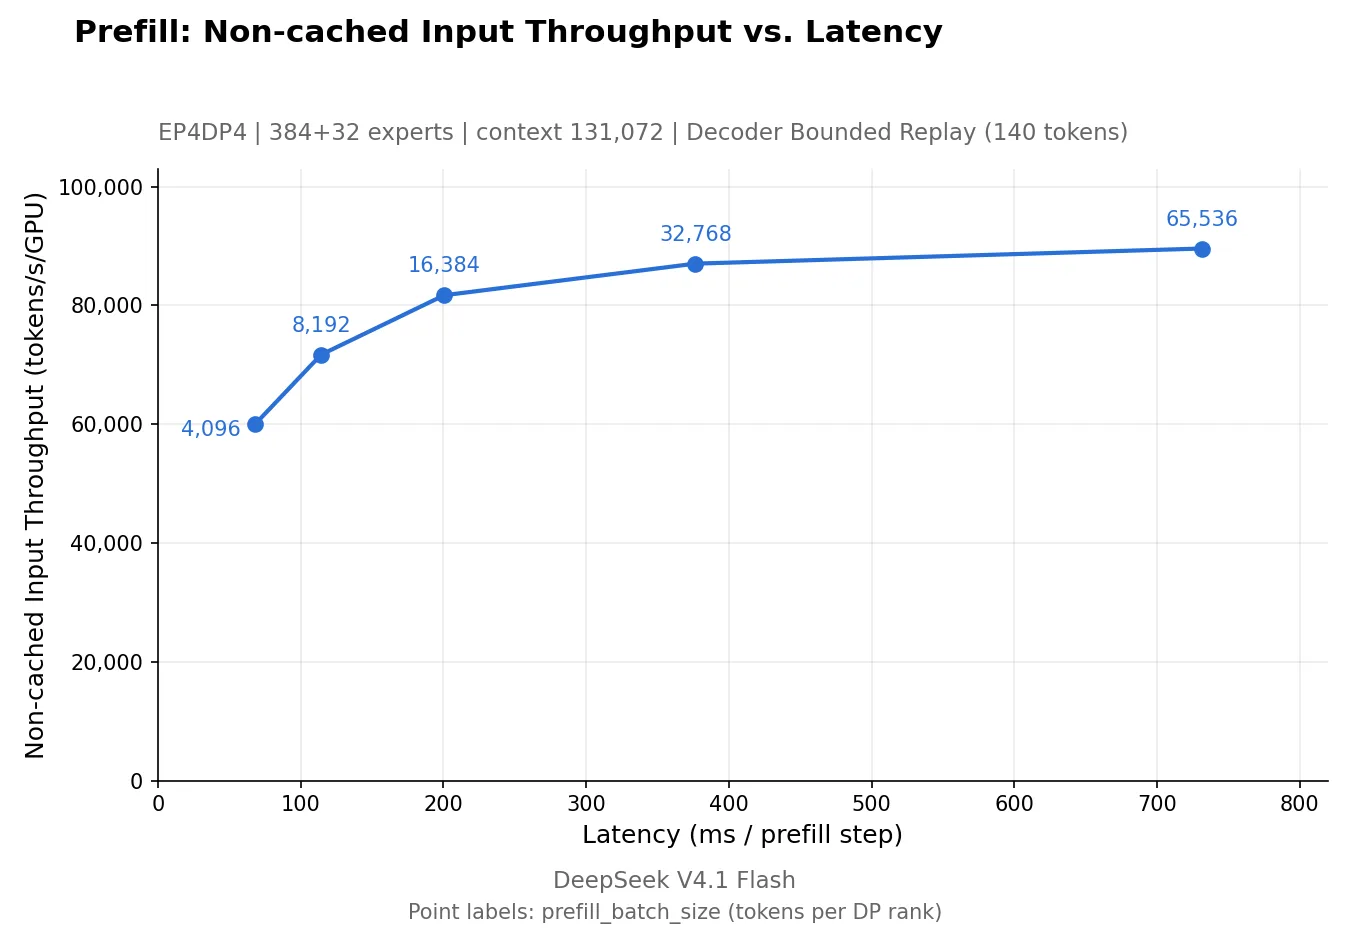
| การกระจายงานฝั่ง prefill | EP2–8 / DP2–8 |
| การกระจายงานฝั่ง decode | EP64–128 / DP64–128 (Wide-EP) |
| ที่เก็บ KV cache | SSD ราว 100 PiB บนระบบไฟล์ 3FS |
| อายุ KV cache | 3 วันสำหรับงานเอเจนต์, 7 วันสำหรับแชตบอต |
| การกระจายโหลดเทียบกับกรณีสมดุลสมบูรณ์ | ราว 80% |
| ผลของ DSpark เทียบกับการตรวจโทเคนร่างคงที่ 5 ตัว | ปริมาณงานเพิ่ม 4–7% ที่จุดใช้งานจริง |
DeepSeek ตั้งเป้าตั้งแต่ต้นว่าระบบต้องรันบนชิปจากหลายผู้ผลิต ใช้เครื่อง 8 GPU ทั่วไปสำหรับ prefill และกลุ่ม 64–128 GPU สำหรับ decode และเก็บ KV cache ไว้นานกว่า 72 ชั่วโมง เพื่อลดการคำนวณ prefill ซ้ำเมื่อผู้ใช้ส่งบริบทเดิมกลับมา บริษัทยังแนะนำเซิร์ฟเวอร์เก็บ KV cache ที่ใช้ SSD ขนาด 30.73 TB จำนวน 20 ลูกต่อเครื่อง
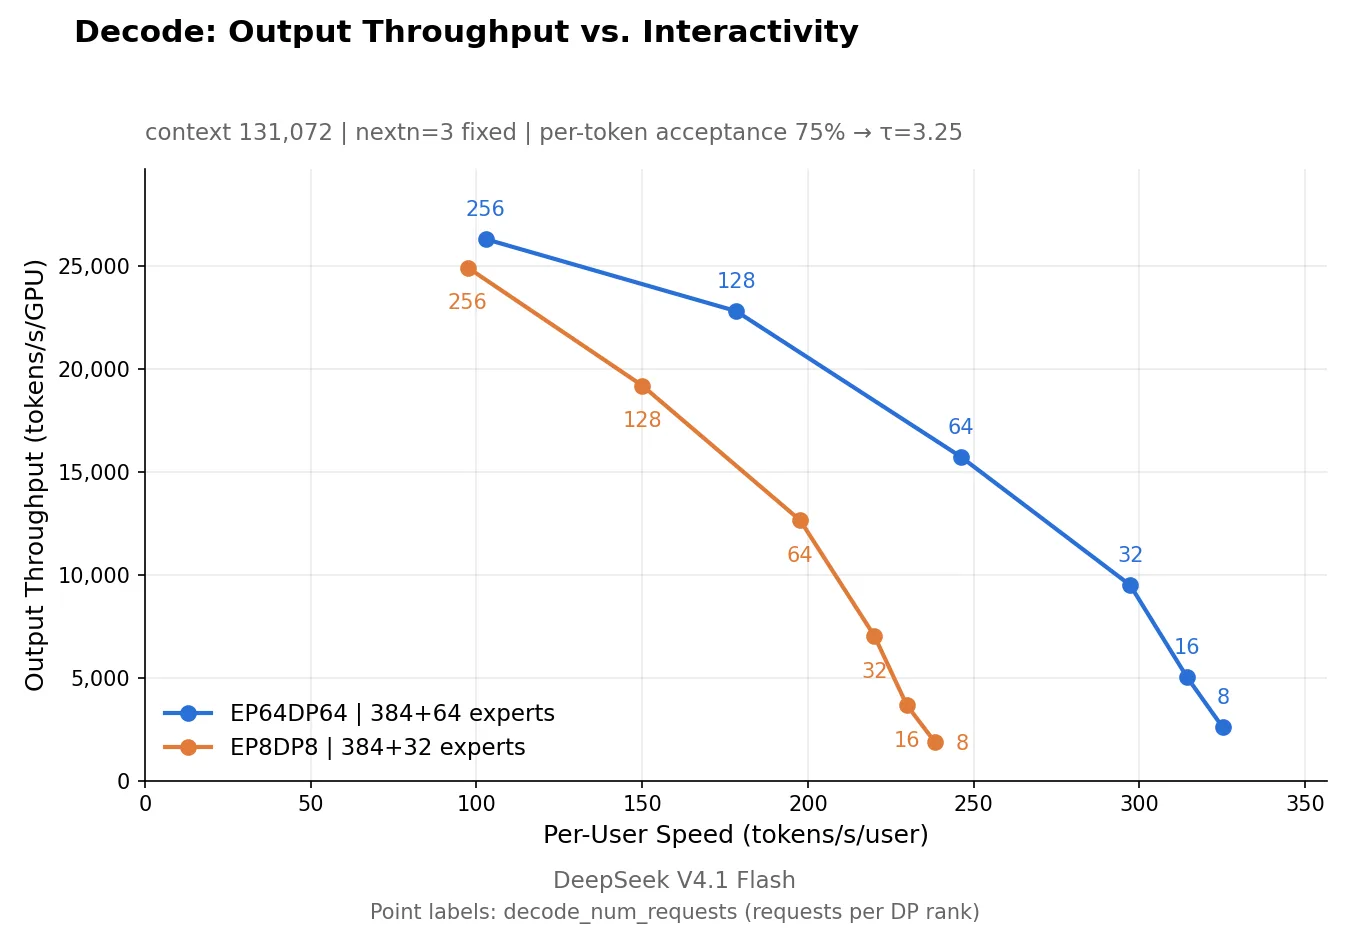
กราฟของ DeepSeek เทียบการกระจายงานฝั่ง decode แบบ EP64DP64 กับ EP8DP8 ที่บริบท 131,072 โทเคน และใช้อธิบายว่าทำไมบริษัทแนะนำ Wide-EP ส่วนกราฟฝั่ง prefill วัดบน GPU 4 ตัวแบบ EP4DP4
deepseek-recipe ให้พฤติกรรม API ตรงกับของทางการ
DeepSeek เผยแพร่ deepseek-recipe ควบคู่กับ DeepSeek DeepInfer เป็นชุดไลบรารี Rust พร้อม binding สำหรับ Python ที่แปลงคำขอแบบ Chat Completions, Responses และ Messages ให้เป็นรูปแบบบทสนทนาเดียว แล้วเข้ารหัสเป็นโทเคนของ DeepSeek V4 และ V4.1 บริษัทระบุว่าตรรกะตรงกับ API ทางการ ผู้ที่ติดตั้งเองจึงได้พฤติกรรม API แบบเดียวกัน
ไลบรารีนี้ยังป้องกันการแทรกโทเคนควบคุม (special-token injection) ข้อความอย่าง <|User|> ที่อยู่ในข้อความของผู้ใช้หรือผลลัพธ์ของเครื่องมือจะถูกเข้ารหัสเป็นข้อความธรรมดา ไม่กลายเป็นคำสั่งที่เปลี่ยนพฤติกรรมของโมเดล
ทำไมเรื่องนี้สำคัญ
DeepSeek เขียนในเอกสารว่าโจทย์หลักของเฟรมเวิร์กอนุมานคือการให้บริการโมเดลแก่ผู้ใช้จำนวนมากด้วยต้นทุนที่สมเหตุสมผล และเป้าหมายคือรับคำขอได้มากขึ้นด้วยพลังประมวลผลและพลังงานที่น้อยลง การที่บริษัทเปิดทั้งโค้ดเอนจินและตัวเลขรายได้ต่อ GPU ทำให้ผู้ให้บริการคลาวด์และศูนย์ข้อมูลประเมินได้ว่าการรัน DeepSeek V4.1 Flash เองคุ้มกว่าการเรียก API หรือไม่ การรองรับ Huawei Ascend 950 ตั้งแต่รุ่นแรกยังเป็นไปตามเป้าที่ DeepSeek เขียนไว้ว่าระบบต้องใช้ได้กับชิปหลายผู้ผลิต ไม่ผูกกับ NVIDIA รายเดียว
ผลต่อองค์กรไทย
- องค์กรทั่วไปยังไม่ต้องรันเอง ชุดที่คุ้มค่าตามเอกสารใช้ GPU รุ่น SM100 ถึง 128 ตัว องค์กรขนาดกลางที่ต้องการ DeepSeek V4.1 Flash ยังเหมาะกับการใช้ผ่าน API หรือผู้ให้บริการที่รันโมเดลให้มากกว่า
- ผู้ให้บริการคลาวด์และ GPU ในไทยศึกษา DeepSeek DeepInfer ได้ทันที โค้ดใช้สัญญาอนุญาต Apache 2.0 ที่ให้สิทธิ์ทำซ้ำ ดัดแปลง และแจกจ่ายต่อ แต่ต้องเตรียมทีมสร้างระบบ KV cache และตัวกระจายโหลดเอง
- ใช้เป็นแนวทางวางระบบ เอกสารถาม-ตอบบอกสัดส่วน GPU ต่อสตอเรจ อายุ KV cache และแบนด์วิดท์ระหว่างเครื่องไว้ชัด ทีมที่วางแผนศูนย์ข้อมูล AI ใช้ประกอบการคำนวณได้
- งานที่ต้องตรวจสอบย้อนหลังได้ โหมด deterministic sampling ให้ผลเหมือนเดิมเมื่อป้อนข้อมูลเดิม ช่วยงานทดสอบและงานที่หน่วยงานกำกับต้องการให้ทำซ้ำได้
- ข้อมูลอยู่ในประเทศเมื่อรันเอง องค์กรที่กังวลเรื่องการส่งข้อมูลส่วนบุคคลออกนอกประเทศตาม PDPA มีทางเลือกรันโมเดลในศูนย์ข้อมูลไทยมากขึ้น เมื่อผู้ให้บริการในประเทศนำเอนจินนี้ไปใช้
ติดตามข่าวโมเดล AI และการนำ AI ไปใช้ในองค์กรเพิ่มเติมได้ที่หมวด AI
คำถามที่พบบ่อย
DeepSeek DeepInfer คืออะไร?
DeepSeek DeepInfer คือเฟรมเวิร์กอนุมานที่ DeepSeek ใช้ให้บริการโมเดล DeepSeek V4.1 Flash ในระบบจริง เปิดซอร์สบน GitHub เมื่อ 20 ตุลาคม 2026 ภายใต้ Apache 2.0 รุ่นที่เปิดรองรับการอนุมานแบบ offline พร้อม kernel ที่ปรับแต่งแล้ว การกระจายงานแบบ expert parallel และ speculative decoding
DeepSeek DeepInfer ใช้กับฮาร์ดแวร์อะไรได้บ้าง?
README ของ DeepSeek DeepInfer ระบุว่ารองรับ GPU ของ NVIDIA สถาปัตยกรรม SM100 และ NPU Huawei Ascend 950 ต้องใช้ Linux, GCC 13 ขึ้นไป และ Python 3.12 ฝั่ง NVIDIA ต้องมี CUDA 13 ส่วนฝั่ง Ascend ต้องมี CANN 9.2
นำ DeepSeek DeepInfer ไปเปิดบริการ API เต็มรูปแบบได้เลยหรือไม่?
ยังไม่ได้ทันที DeepSeek ระบุว่ารุ่นที่เปิดซอร์สทำได้เฉพาะการอนุมานแบบ offline ยังขาดระบบ KV cache การแยกงาน Vision Encoder/Prefill/Decode และการกระจายโหลดระหว่างชุด data parallel ซึ่งผูกกับโครงสร้างภายในของบริษัท ผู้ใช้ต้องสร้างส่วนเหล่านี้เอง
ต้องใช้ GPU กี่ตัวถึงจะรัน DeepSeek V4.1 Flash ด้วย DeepSeek DeepInfer แบบคุ้มค่า?
เอกสารถาม-ตอบของ DeepSeek ระบุว่าติดตั้งแบบ 1 prefill กับ 1 decode ได้ แต่เพราะแนะนำให้ฝั่ง decode ใช้ EP64 ขึ้นไป ชุดเล็กที่สุดที่คุ้มค่าจึงเป็น GPU 64 ตัวสำหรับ prefill และอีก 64 ตัวสำหรับ decode
แหล่งอ้างอิง
- deepseek-ai/DeepInfer: High-performance, large-scale inference framework for DeepSeek models — DeepSeek (GitHub)
- DeepSeek V4.1 Flash Inference Deployment Q&A — DeepSeek (GitHub)
- deepseek-ai/deepseek-recipe — DeepSeek (GitHub)
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ