
Figma โมเดลแก้ดีไซน์ของตัวเอง เทรนต่อจาก Qwen 3.8 27B ได้ 77.8% ในชุดทดสอบภายใน
Figma โมเดลแก้ดีไซน์ที่เทรนต่อจาก Qwen 3.8 27B ได้ 77.8% ในชุดทดสอบภายใน 445 ตัวอย่าง สูสีกับโมเดลชั้นนำ และใช้ในเอเจนต์ที่เปิดให้ผู้ใช้ทั่วไป
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- Josh Clemm รองประธานฝ่ายวิศวกรรมของ Figma อธิบายเมื่อปลาย ตุลาคม 2026 ว่าบริษัทฝึกโมเดลแก้ดีไซน์ของตัวเองด้วย post-training เพื่อให้เอเจนต์ Figma แก้งานบนแคนวาสได้เร็วและถูกลง
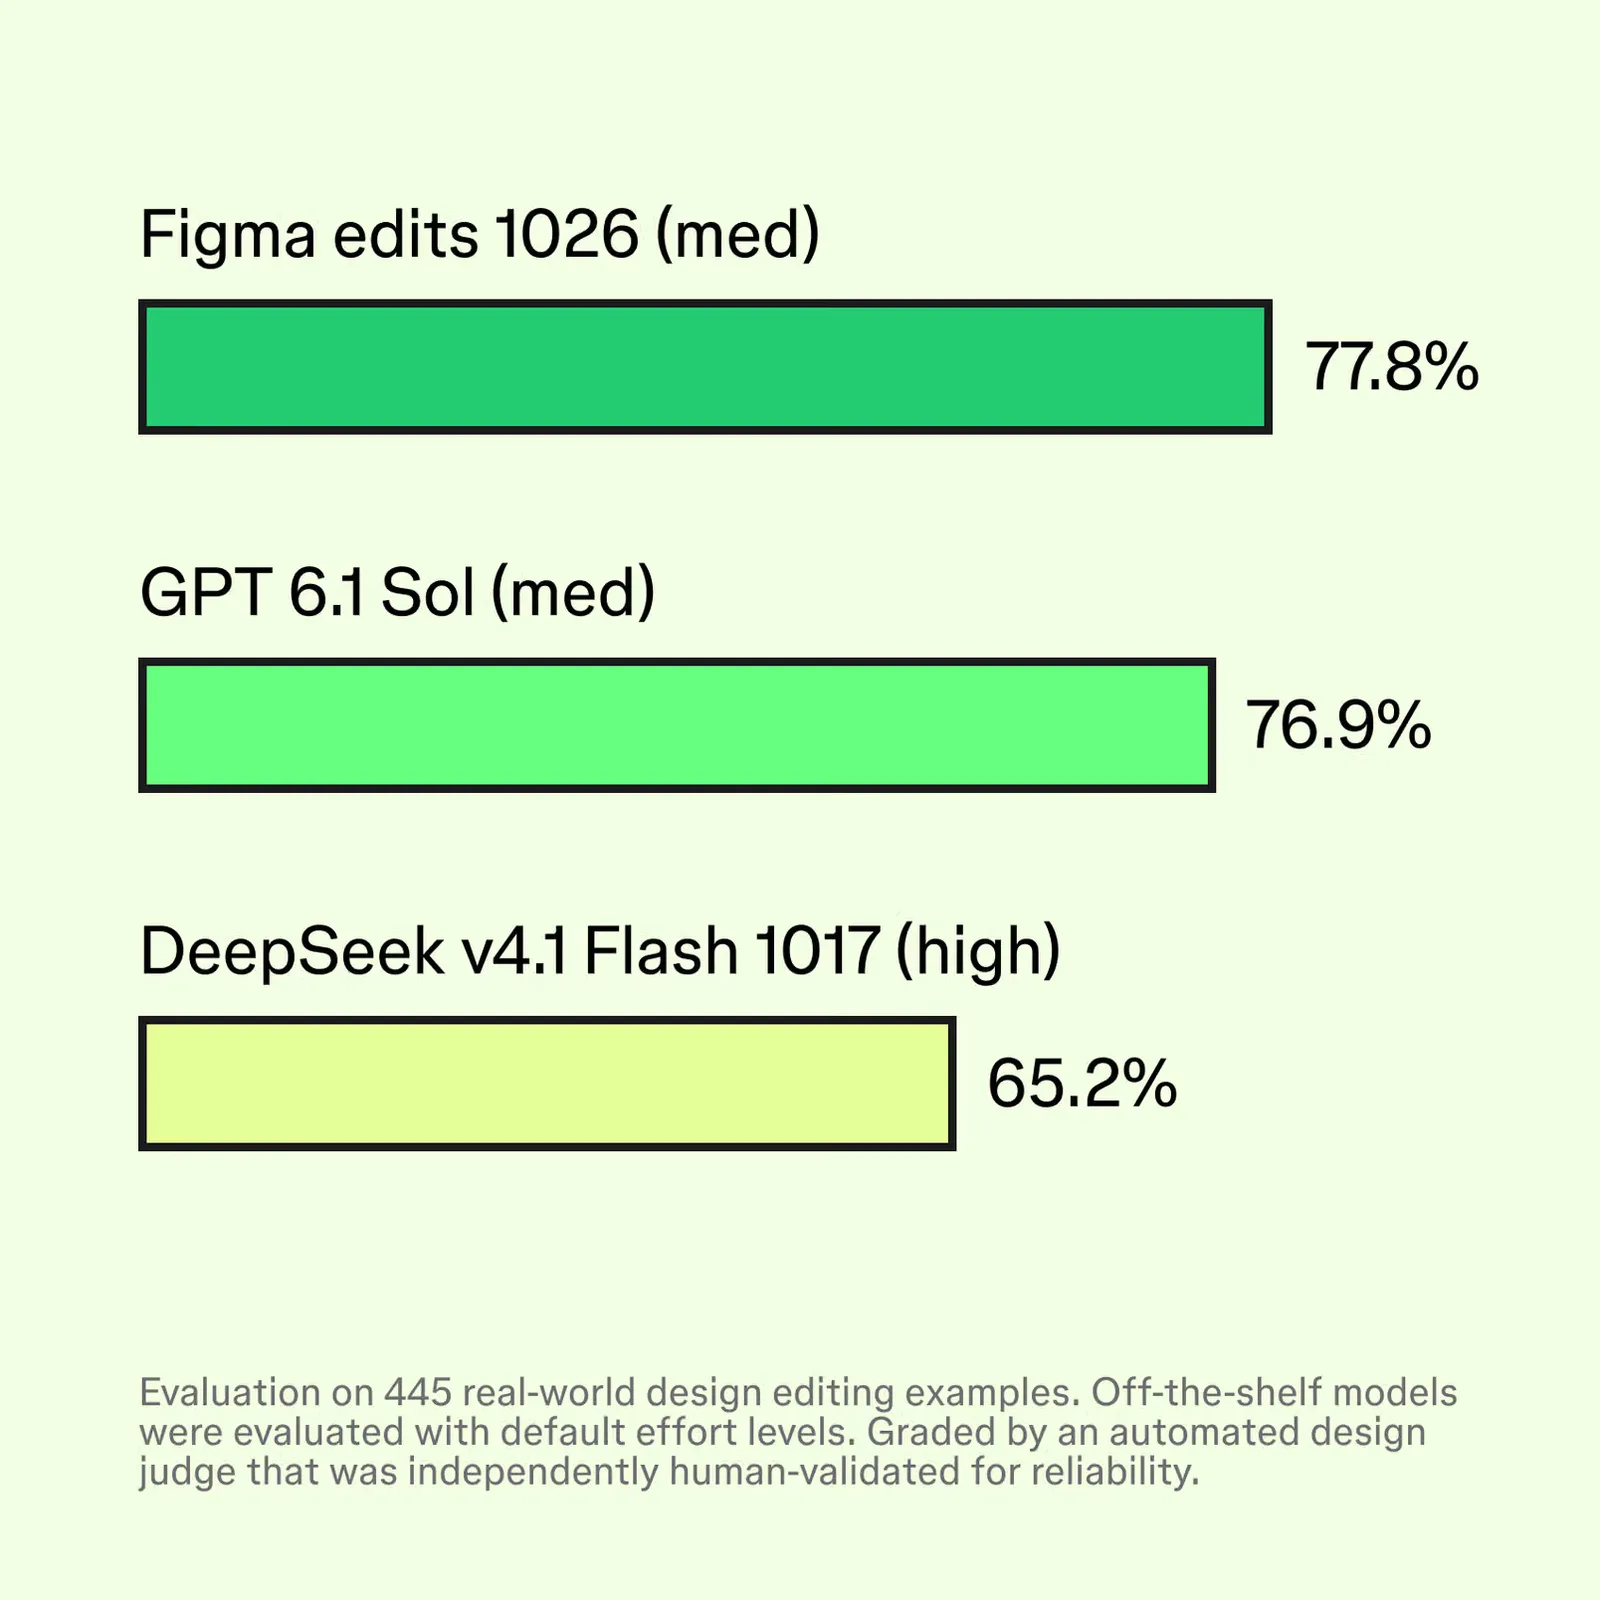
- รุ่นล่าสุดที่ยังไม่เปิดตัวเทรนต่อจาก Qwen 3.8 27B ได้ 77.8% เทียบ GPT 6.1 Sol 76.9% และ DeepSeek v4.1 Flash 65.2% ในชุดทดสอบภายใน 445 ตัวอย่าง
- รุ่นแรก ๆ ใช้ Llama 3.3 70B ฝึกด้วยตัวอย่างกว่า 250,000 รายการ ด้วย supervised fine-tuning แล้วเสริมด้วย reinforcement learning เพราะการเลียนแบบอย่างเดียวทำให้โมเดลทั่วไปน้อยลง
- Figma ระบุว่าตั้งแต่ช่วงเบต้าถึงเปิดทั่วไป งานทั่วไป เร็วขึ้นราว 20% ผู้ใช้ให้คะแนนสูงขึ้น 33% และกดยกเลิกงานของเอเจนต์ น้อยลง 60%
- ตัวเลขทั้งหมดเป็นของ Figma เองและยังไม่มีการทดสอบอิสระ เอเจนต์ใช้โมเดลของบริษัทกับงานแก้ละเอียด และใช้โมเดลบุคคลที่สามกับงานสร้างภาพและงานออกแบบใหม่
Figma เผยแพร่โพสต์วิศวกรรมเมื่อปลายตุลาคม 2026 ที่อธิบายวิธีฝึก Figma โมเดลแก้ดีไซน์ ซึ่งเป็นโมเดลของบริษัทเองสำหรับงานแก้ดีไซน์บนแคนวาส เทรนต่อจากโมเดลเปิดอย่าง Qwen ตามข้อมูลของ Figma โมเดลรุ่นล่าสุดที่ยังไม่เปิดตัว ซึ่งใช้ Qwen 3.8 27B เป็นฐาน ได้ 77.8% ในชุดทดสอบภายใน 445 ตัวอย่าง เทียบกับ GPT 6.1 Sol ที่ 76.9%
ข้อมูลทั้งหมดของ Figma โมเดลแก้ดีไซน์ในข่าวนี้มาจากโพสต์ของ Figma เอง ตัวเลขเป็นผลทดสอบภายในที่ตัดสินด้วยผู้ตัดสินอัตโนมัติ และ Figma ระบุว่าเป็นเพียงข้อมูลหนึ่งที่ใช้เลือกโมเดล เราไม่พบการทดสอบอิสระ จึงรายงานเฉพาะสิ่งที่บริษัทเปิดเผย
Figma โมเดลแก้ดีไซน์ ฝึกอย่างไร
Figma อธิบายที่มาของ Figma โมเดลแก้ดีไซน์ ว่างานประจำวันของผู้ออกแบบส่วนใหญ่เป็นการแก้เล็ก ๆ ที่ต่อเนื่องและตรวจด้วยเกณฑ์ตายตัวไม่ได้ เช่น ปรับระยะห่าง เปลี่ยนสี หรือจัดเลย์เอาต์ใหม่หลังได้รับความเห็น บริษัทจึงเริ่มจากงานแคบ ๆ คือช่วยแก้งานที่อยู่บนแคนวาสแล้ว เพราะตอนเริ่มงานโมเดลชั้นนำยังไม่เข้าใจไวยากรณ์ของ Figma และต้องใช้พรอมต์ระบบยาวที่สิ้นเปลืองโทเค็น
วิธีแรกของ Figma โมเดลแก้ดีไซน์ คือ supervised fine-tuning ตัวอย่างฝึกแต่ละชิ้นจับคู่ดีไซน์ตั้งต้น คำขอแก้ที่สร้างขึ้นสังเคราะห์ และตัวอย่างการแก้ที่สำเร็จ โดยแทนดีไซน์ด้วยรูปแบบไฟล์ดั้งเดิมของ Figma เพื่อให้โมเดลสร้างการเปลี่ยนแปลงที่นำกลับไปใช้บนแคนวาสได้ จากนั้นให้โมเดลครูขนาดใหญ่ลองแก้ แล้วตรวจผลด้วยตัวตรวจแบบแน่นอนและผู้ตัดสินภาพที่เป็นโมเดล ท่อสร้างข้อมูลปรับแก้ตัวเองตามผลประเมินได้
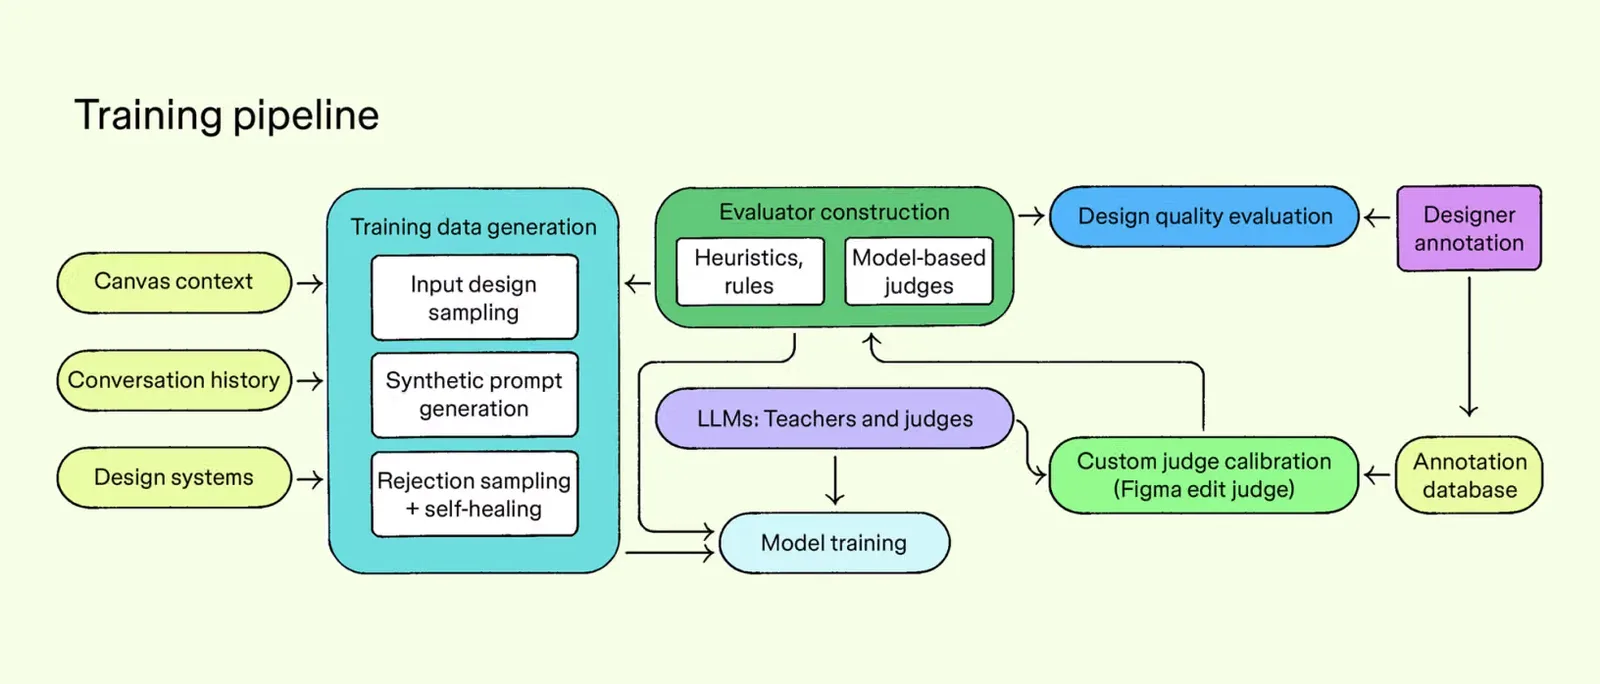
Figma บอกว่าวิธีนี้กับ Figma โมเดลแก้ดีไซน์ ไปได้ไกลเกินคาด โมเดล Llama 3.3 70B รุ่นแรกที่ฝึกด้วยตัวอย่างกว่า 250,000 รายการแข่งกับโมเดลชั้นนำในยุคนั้นได้ในงานแก้ดีไซน์ แต่ข้อจำกัดคือการเลียนแบบทำให้โมเดลสร้างงานคล้ายตัวอย่างฝึกและทั่วไปน้อยลง และต้องใช้ตัวอย่างมาก บริษัทจึงเพิ่ม reinforcement learning โดยลงทุนกับสภาพแวดล้อมฝึกเฉพาะงานออกแบบ ความหลากหลายของตัวอย่าง โมเดลให้รางวัล และเกณฑ์ที่นักออกแบบเขียนเอง ฐานโมเดลที่ใช้ตอนนี้ย้ายไปสู่ตระกูล Qwen รุ่นใหม่ Muse Spark Open และ Inkling เป็นต้น
Figma โมเดลแก้ดีไซน์ ประเมินผลอย่างไร
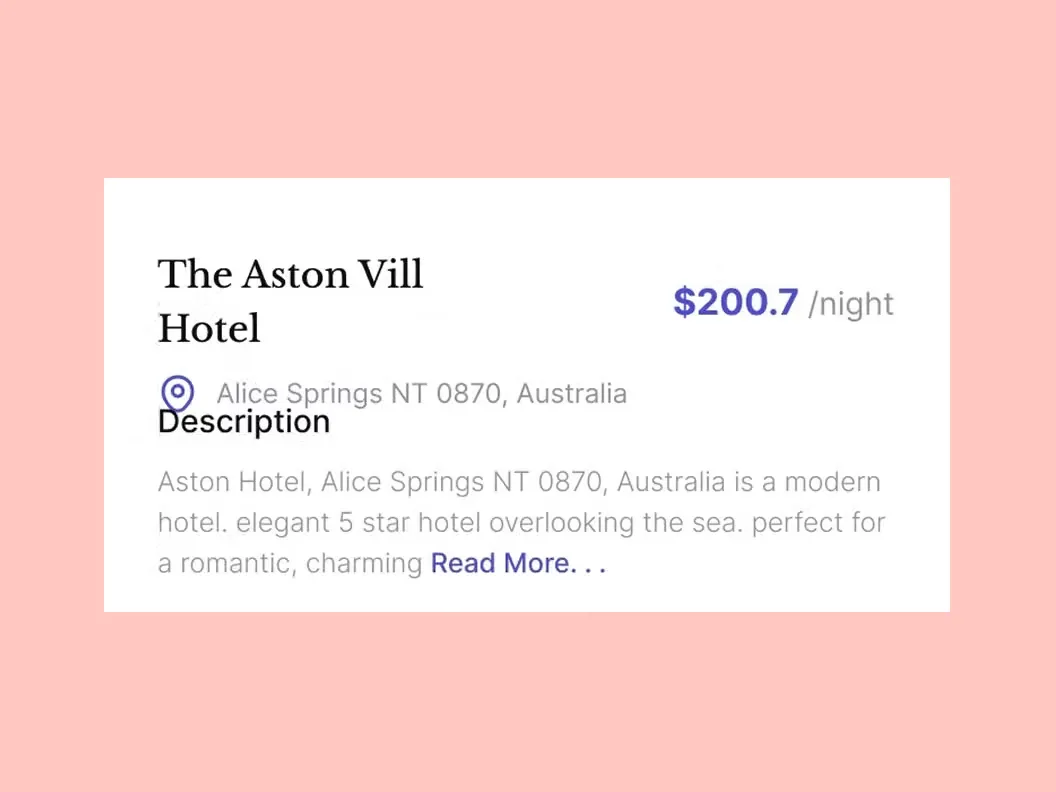
Figma ไม่ตัดสินว่าดีหรือไม่ดีเป็นก้อนเดียว แต่แยกประเมินหลายมิติ เพราะดีไซน์หนึ่งอาจจัดแนวดีแต่คอนทราสต์แย่ หรือแก้ให้ดูเรียบร้อยแต่ไม่ตรงคำขอ หรือใช้คอมโพเนนต์ผิดตัวทั้งที่หน้าตาถูก ระบบประเมินรวมการตรวจโครงสร้างกับผู้ตัดสินภาพ แล้วให้นักออกแบบผู้เชี่ยวชาญปรับเทียบและตรวจผล ตัวอย่างข้อผิดพลาดที่โพสต์ยกมาคือไอคอนและข้อความทับกัน ลูกศรถูกตัด และข้อความซ้อนกัน
| โมเดล | คะแนนในชุดทดสอบภายในของ Figma |
|---|---|
| Figma edits 1026 (med) ฐาน Qwen 3.8 27B ยังไม่เปิดตัว | 77.8% |
| GPT 6.1 Sol (med) | 76.9% |
| DeepSeek v4.1 Flash 1017 (high) | 65.2% |
ตามหมายเหตุใต้กราฟของ Figma โมเดลแก้ดีไซน์ ชุดทดสอบมี 445 ตัวอย่างงานแก้ดีไซน์จริง โมเดลสำเร็จรูปทดสอบด้วยระดับความพยายามเริ่มต้น และตัดสินด้วยผู้ตัดสินดีไซน์อัตโนมัติที่คนตรวจความน่าเชื่อถือแล้ว
Figma โมเดลแก้ดีไซน์ อยู่ตรงไหนในเอเจนต์ Figma
Figma ระบุในโพสต์ว่าเปิดเอเจนต์ให้ผู้ใช้ทุกคนเมื่อต้นเดือนตุลาคม 2026 (ตามถ้อยคำ "earlier this month" ของโพสต์ที่เผยแพร่ปลายเดือน) และเอเจนต์ใช้โมเดลแก้ดีไซน์ของบริษัทร่วมกับโมเดลบุคคลที่สามชั้นนำ แบ่งงานกันตามประเภท งานอย่างสร้างภาพ เวกเตอร์ และการสำรวจดีไซน์ใหม่ใช้โมเดลบุคคลที่สามที่ดีที่สุด ส่วนการแก้และปรับแต่งที่แม่นยำใช้โมเดลของตัวเอง
บริษัทอ้างผลของเอเจนต์ที่ใช้ Figma โมเดลแก้ดีไซน์ ตั้งแต่ช่วงเบต้าถึงเปิดทั่วไปว่างานทั่วไปเร็วขึ้นราว 20% ในการทดสอบแบบเทียบกับนักออกแบบผู้เชี่ยวชาญ เอเจนต์ใหม่ชนะหรือเสมอรุ่นที่ใช้งานจริงก่อนหน้า 62% ของครั้ง คะแนนจากผู้ใช้สูงขึ้น 33% และผู้ใช้กดยกเลิกงานของเอเจนต์น้อยลง 60% ส่วนแบ่งงานที่ขับเคลื่อนด้วยโมเดลของตัวเองเพิ่มขึ้นกว่าเท่าตัว และต้นทุนเฉลี่ยต่อข้อความลดลง Figma ระบุด้วยว่าฝึกโดยเคารพความเป็นส่วนตัวและความต้องการของลูกค้า
ทำไม Figma โมเดลแก้ดีไซน์ จึงสำคัญ
กรณี Figma โมเดลแก้ดีไซน์ เป็นตัวอย่างของแนวโน้มที่ Figma เรียกว่า post-training เฉพาะทางแข่งกับโมเดลชั้นนำได้ในงานแคบ ๆ โมเดลขนาด 27 พันล้านพารามิเตอร์เป็นขนาดที่ทีมองค์กรหลายแห่งรันเองได้ ถ้ามีข้อมูลงานที่ทำซ้ำบ่อย เกณฑ์ตัดสินที่ชัด และชุดทดสอบของตัวเอง สิ่งที่ต้องระวังคือคะแนนเป็นของ Figma เอง วัดด้วยผู้ตัดสินอัตโนมัติ และผลของงานแคบ ๆ ไม่ได้แปลว่าโมเดลทำงานทั่วไปได้เท่ากัน
สิ่งที่องค์กรไทยควรทำกับ Figma โมเดลแก้ดีไซน์
- ทีมออกแบบและผลิตภัณฑ์ ทดลองเอเจนต์ที่ใช้ Figma โมเดลแก้ดีไซน์ โดยเริ่มกับงานแก้ซ้ำ ๆ เช่น ปรับดีไซน์ตามความเห็น แล้วบันทึกว่าต้องแก้ซ้ำกี่ครั้งและยกเลิกบ่อยแค่ไหนก่อนขยายการใช้
- ตรวจนโยบายข้อมูล ว่าไฟล์ดีไซน์และระบบดีไซน์ขององค์กรถูกใช้ฝึกโมเดลหรือไม่ และตั้งค่าตามนโยบายของบริษัทและสัญญากับลูกค้า
- ถ้าคิดจะฝึกโมเดลเล็กเองสำหรับงานภายใน เริ่มจากงานที่ทำซ้ำบ่อยและวัดผลได้ สร้างชุดทดสอบจากงานจริงและให้ผู้เชี่ยวชาญตรวจ แทนการดูคะแนนชุดทดสอบทั่วไป
- ตรวจสิทธิ์ใช้งานของโมเดลฐาน ว่าอนุญาตให้ฝึกต่อและใช้เชิงพาณิชย์หรือไม่ ก่อนลงทุนฝึก
- วางแผนทรัพยากรคำนวณ การฝึกต่อและรันโมเดลขนาด 27 พันล้านพารามิเตอร์ต้องใช้ GPU ประเมินว่าจะรันเองหรือเช่า ติดตามข่าว AI อื่น ๆ ได้ที่หมวด AI
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
ทีมที่อยากทดลองฝึกหรือรันโมเดลเล็กกับงานภายในมักต้องมี GPU ใช้เป็นช่วง ๆ โดยไม่อยากลงทุนซื้อการ์ดเอง GPU Server ของ THAI DATA CLOUD ประมวลผลแบบขนานด้วย NVIDIA Tesla T4 และ V100 สำหรับงาน AI และ Deep Learning พร้อมใช้งานได้ภายในไม่กี่นาที (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
คำถามที่พบบ่อย
Figma โมเดลแก้ดีไซน์ คืออะไร?
Figma โมเดลแก้ดีไซน์ คือโมเดลภาษาที่ Figma ฝึกต่อ (post-training) จากโมเดลเปิดอย่าง Qwen เพื่อแก้งานที่มีอยู่บนแคนวาส เช่น ปรับระยะห่าง เปลี่ยนสี หรือจัดเลย์เอาต์ใหม่ตามความเห็น ใช้เป็นส่วนหนึ่งของเอเจนต์ Figma ควบคู่กับโมเดลบุคคลที่สามสำหรับงานอื่น
Figma โมเดลแก้ดีไซน์ เก่งกว่าโมเดลชั้นนำจริงหรือไม่?
ตามชุดทดสอบภายในของ Figma โมเดลแก้ดีไซน์ 445 ตัวอย่างงานแก้ดีไซน์จริง โมเดลรุ่นล่าสุดที่ยังไม่เปิดตัวได้ 77.8% เทียบ GPT 6.1 Sol 76.9% และ DeepSeek v4.1 Flash 65.2% ตัดสินด้วยผู้ตัดสินอัตโนมัติที่คนตรวจความน่าเชื่อถือแล้ว จึงเป็นผลของ Figma เอง ไม่ใช่ผลอิสระ และ Figma ระบุว่าเป็นเพียงข้อมูลหนึ่งในการเลือกโมเดล
ทำไม Figma ต้องฝึกโมเดลแก้ดีไซน์ของตัวเอง?
Figma โมเดลแก้ดีไซน์ เกิดจากเหตุนี้ Figma ระบุว่าตอนเริ่มงาน โมเดลชั้นนำไม่เข้าใจไวยากรณ์ของ Figma และต้องใช้พรอมต์ระบบยาวที่สิ้นเปลืองโทเค็น การฝึกเองช่วยให้งานแก้เล็ก ๆ ที่ผู้ออกแบบทำซ้ำทั้งวันเร็วขึ้นและถูกลง บริษัทบอกว่าสัดส่วนงานที่ขับเคลื่อนด้วยโมเดลของตัวเองเพิ่มขึ้นกว่าเท่าตัวและต้นทุนเฉลี่ยต่อข้อความลดลง
องค์กรไทยเรียนรู้อะไรจากกรณี Figma โมเดลแก้ดีไซน์ ได้บ้าง?
ข้อคิดคือโมเดลเล็กที่ฝึกต่อกับงานแคบ ๆ ที่มีข้อมูลและเกณฑ์ตัดสินชัดเจน อาจสู้โมเดลใหญ่ได้ในต้นทุนต่ำกว่า แต่ต้องมีชุดทดสอบที่ตรงกับงานจริงและคนตรวจสอบ ทีมที่คิดจะทำแบบเดียวกันควรเริ่มจากงานที่ทำซ้ำบ่อย วัดผลได้ และตรวจสิทธิ์การใช้ข้อมูลฝึกให้ชัด
แหล่งอ้างอิง
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- DeepSeek17NVIDIA133Tesla98
- ผลิตภัณฑ์และเทคโนโลยี
- Qwen13
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ