
CWE-bench v2 วัดเอเจนต์ AI แก้ช่องโหว่ 100 งาน Gemini 4 Argon นำ 67.8% Claude Opus 5.5 ตาม
CWE-bench v2 ของ Collinear AI เปิดชุดทดสอบ 100 งานที่ให้เอเจนต์ AI ค้นและแก้ช่องโหว่ใน 91 CWE ผล 11 โมเดล Gemini 4 Argon นำ 67.8% Claude Opus 5.5 ตาม 67.3%
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- Collinear AI เผยแพร่ CWE-bench v2 เมื่อ 3 พฤศจิกายน 2026 บน Hugging Face เป็นชุดทดสอบสาธารณะ 100 งาน ครอบคลุมจุดอ่อนซอฟต์แวร์ 91 ประเภท (CWE)
- ใน 11 โมเดล ที่ทดสอบ Gemini 4 Argon ได้ pass@1 67.8% และ pass@4 81.0% นำ Claude Opus 5.5 ที่ 67.3% และ 78.0% เพียงเล็กน้อย
- 95 จาก 100 งาน มีอย่างน้อยหนึ่งโมเดลแก้ได้ แต่แม้โมเดลอันดับ 1 ก็ล้มเหลวทุกครั้งใน 19% ของชุดทดสอบ
- ต้นทุนต่อรอบต่างกันมาก DeepSeek V4.1 Flash (1017) ได้ 57.0% ที่ 0.04 ดอลลาร์สหรัฐ ต่อรอบ ขณะที่ Opus 5.5 ได้ราว 10 จุดมากกว่าที่ 1.83 ดอลลาร์ และ Gemini 4 Argon ที่ 3.92 ดอลลาร์
- ผลทั้งหมดเป็นของผู้จัดทำ และแต่ละโมเดลใช้เครื่องมือรัน (harness) ต่างกัน จึงไม่ใช่การเทียบโมเดลล้วน ๆ
Collinear AI เผยแพร่ CWE-bench v2 เมื่อ 3 พฤศจิกายน 2026 บน Hugging Face ชุดทดสอบสาธารณะ 100 งานที่ให้เอเจนต์ AI ค้นและแก้ช่องโหว่ในรีโพโอเพนซอร์สจริง ครอบคลุมจุดอ่อน 91 ประเภท ในผล 11 โมเดล Gemini 4 Argon นำด้วย pass@1 67.8% ตามด้วย Claude Opus 5.5 ที่ 67.3% และแม้โมเดลอันดับ 1 ก็ยังล้มเหลวทุกครั้งใน 19% ของงาน
ข้อมูลทั้งหมดของ CWE-bench v2 ในข่าวนี้มาจากโพสต์และตารางผลของ Collinear AI ซึ่งเป็นผู้จัดทำชุดทดสอบเอง เราไม่ได้รันซ้ำ และไม่พบการทดสอบอิสระ ตัวเลข pass@1 คือคะแนนรางวัลเฉลี่ยจากการรัน 400 ครั้ง (100 งาน คูณ 4 ครั้ง) ส่วน pass@4 คือสัดส่วนงานที่แก้ได้อย่างน้อยหนึ่งครั้ง
CWE-bench v2 ทดสอบอะไร
เอเจนต์ได้รับสำเนารีโพโอเพนซอร์สจริงกับคำสั่งสั้น ๆ เป้าหมายคือหาและแก้จุดอ่อนด้านความปลอดภัยโดยไม่ทำให้ฟังก์ชันเดิมเสีย การให้คะแนนใช้โปรแกรมตรวจทั้งหมด ผลจึงตายตัวและทำซ้ำได้โดยไม่มีค่าใช้จ่ายเพิ่ม ตัวตรวจถูกปรับให้ยากและยุติธรรมด้วยคณะผู้ตัดสินที่เป็นโมเดล และ Collinear เก็บชุดทดสอบอีกส่วนไว้ไม่เปิดเผย เพื่อติดตามความก้าวหน้าบนงานที่ไม่มีโมเดลใดเคยเห็น
ทั้ง 100 งานครอบคลุม 91 CWE ซึ่งเป็นรหัสจำแนกประเภทจุดอ่อนซอฟต์แวร์ Collinear ระบุว่าโมเดลที่ทำได้ดีต้องเข้าใจจุดอ่อนหลายด้าน ไม่ใช่แค่จำรูปแบบที่คุ้นเคย บริษัทยังตรวจทุกงานด้วย 6 คำถาม เช่น คำสั่งอ่านเหมือนงานจริงไม่ใช่สภาพการทดสอบ ตัวตรวจดูพฤติกรรมที่ถูกต้องไม่ใช่โครงสร้างของแพตช์แบบเดียว โค้ดเริ่มต้นต้องล้มและแพตช์อ้างอิงต้องผ่าน และตัวตรวจต้องจับคำตอบที่จำมาจากแพตช์ต้นทางที่ใครก็รู้ได้ จากนั้นให้คนตรวจทีละงาน
ผลของ 11 โมเดลใน CWE-bench v2
| อันดับ | โมเดล | เครื่องมือรัน | pass@1 | pass@4 | ต้นทุนต่อรอบ (ดอลลาร์สหรัฐ) |
|---|---|---|---|---|---|
| 1 | Gemini 4 Argon | Antigravity SDK | 67.8% | 81.0% | 3.92 |
| 2 | Claude Opus 5.5 | Claude Code | 67.3% | 78.0% | 1.83 |
| 3 | Muse Wonder | OpenCode | 64.8% | 79.0% | 2.54 |
| 4 | GPT-6 Astra | Codex | 63.8% | 70.0% | 3.86 |
| 5 | DeepSeek V4.1 Flash (1017) | OpenCode | 57.0% | 72.0% | 0.04 |
| 6 | Grok 4.7 | OpenCode | 55.5% | 74.0% | 2.86 |
| 7 | Hy4 Preview | OpenCode | 52.0% | 68.0% | 0.42 |
| 8 | Mistral Large 4 | OpenCode | 46.3% | 59.0% | 0.36 |
| 9 | Qwen 3.8 Max (0902) | OpenCode | 45.0% | 62.0% | 2.05 |
| 10 | GLM 5.3 | OpenCode | 44.0% | 65.0% | 0.60 |
| 11 | Kimi K3.1 Pro | OpenCode | 41.5% | 63.0% | 0.92 |
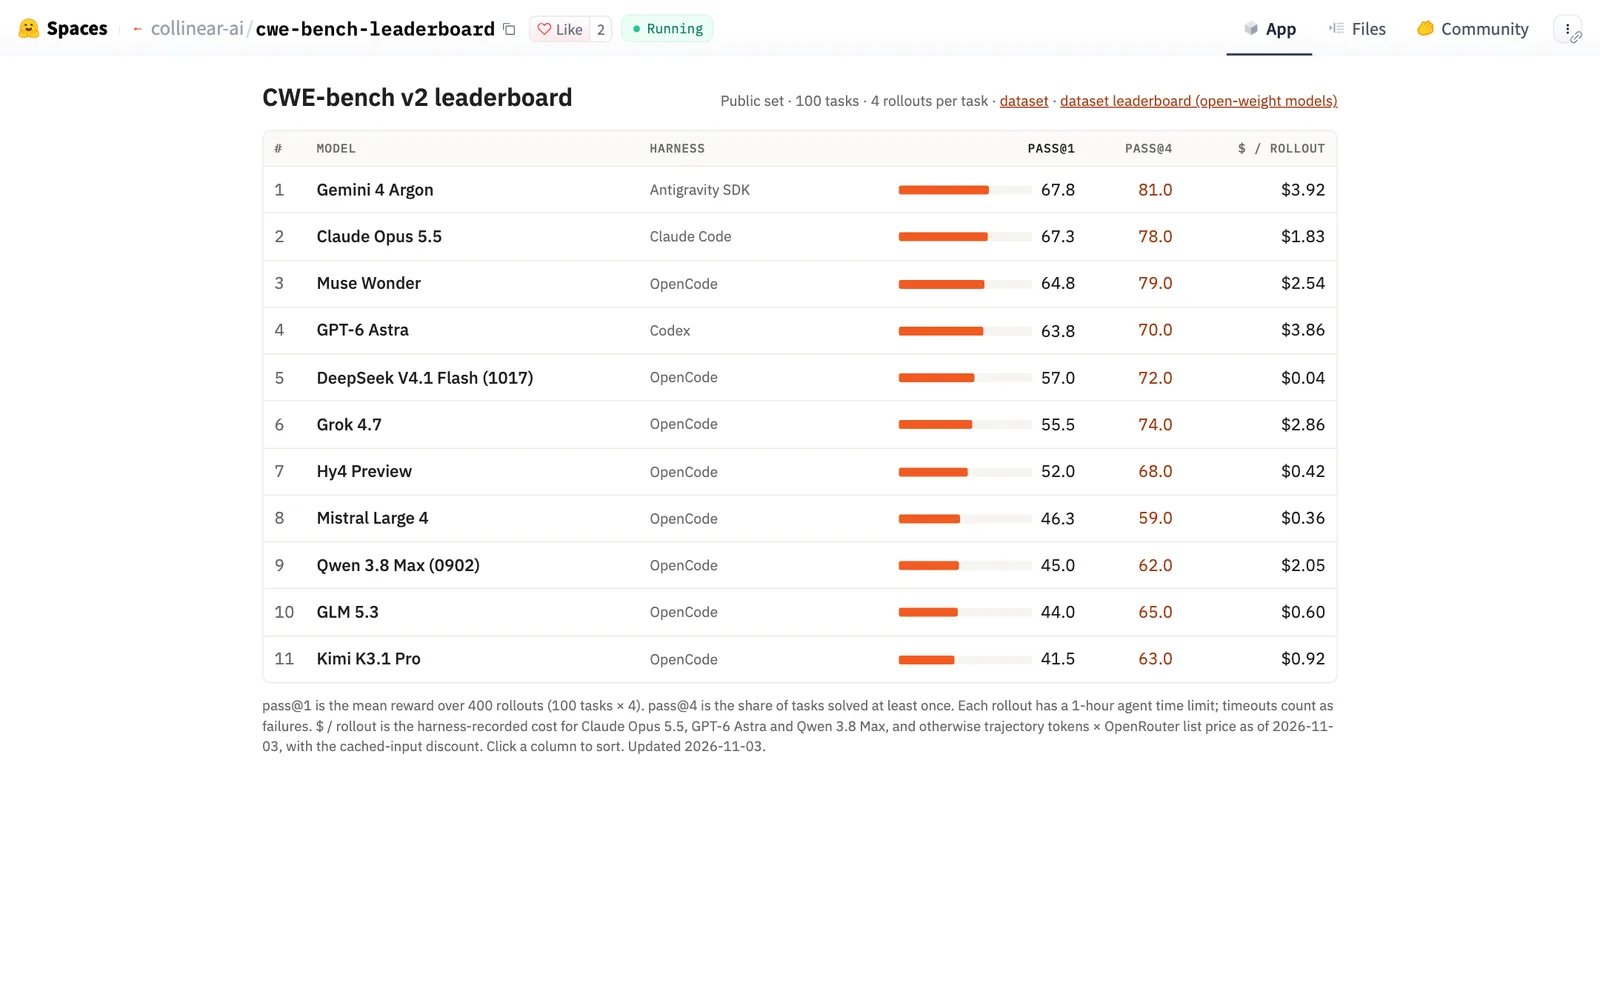
ตารางข้างต้นคัดจากหน้าอันดับของ Collinear (อัปเดต 3 พฤศจิกายน 2026) แต่ละรอบมีเวลาจำกัดของเอเจนต์ 1 ชั่วโมง หมดเวลานับเป็นล้มเหลว ต้นทุนต่อรอบมาจากบันทึกของเครื่องมือรันสำหรับ Claude Opus 5.5, GPT-6 Astra และ Qwen 3.8 Max ส่วนโมเดลอื่นคำนวณจากจำนวนโทเค็นของบันทึกการทำงานคูณราคา OpenRouter ณ 3 พฤศจิกายน 2026 พร้อมส่วนลดอินพุตที่แคช
อ่านผล CWE-bench v2 อย่างไรให้ไม่ตีความเกิน
ข้อควรระวังแรก คือแต่ละโมเดลรันผ่านเครื่องมือคนละตัว (Antigravity SDK, Claude Code, Codex และ OpenCode) ผลจึงปนผลของโมเดลกับผลของเครื่องมือและวิธีกำกับเอเจนต์ ข้อสองคือโมเดลอันดับ 1 กับ 2 ต่างกันเพียง 0.5 จุดเปอร์เซ็นต์ใน pass@1 ซึ่งโพสต์ไม่ได้ระบุช่วงความคลาดเคลื่อน ข้อสามคือชุดสาธารณะมี 100 งาน การเปลี่ยนไม่กี่งานก็ขยับอันดับได้
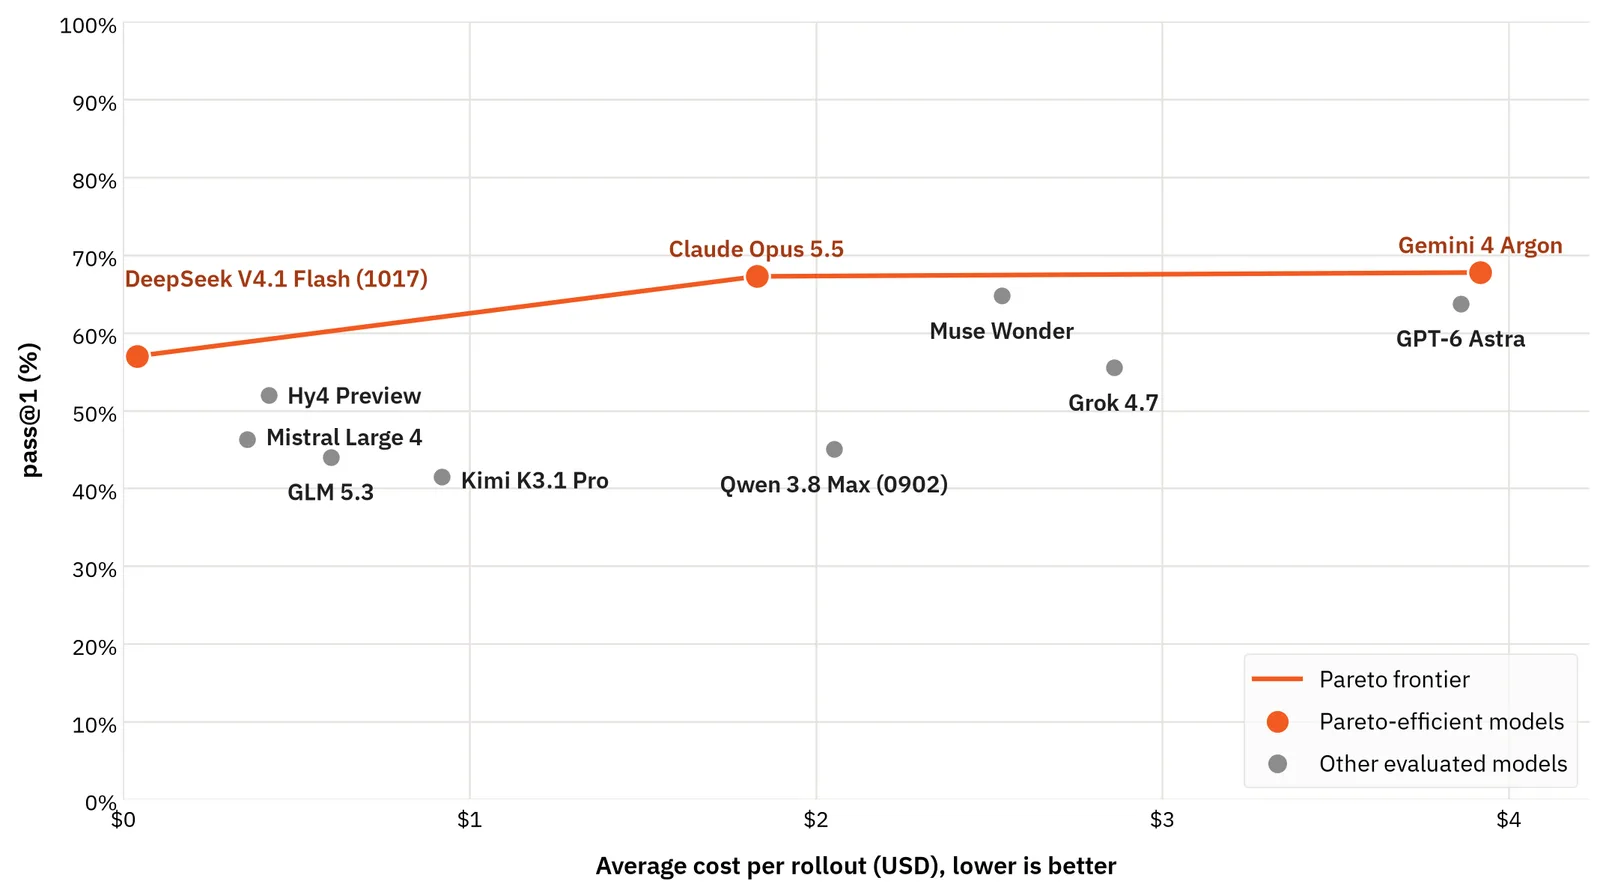
ที่น่าสนใจกว่าคืออันดับโดยรวม โพสต์ระบุว่า 95 จาก 100 งานมีอย่างน้อยหนึ่งโมเดลแก้ได้ แสดงว่างานแก้ได้จริง แต่แม้ผู้นำก็ล้มเหลวทุกครั้งใน 19% ของชุด ส่วนที่ยากจึงยังไม่ถูกแก้ ด้านต้นทุน Collinear ชี้ว่า DeepSeek V4.1 Flash (1017), Claude Opus 5.5 และ Gemini 4 Argon อยู่บนเส้นต้นทุนที่คุ้มสุด (Pareto frontier) คือ DeepSeek ได้ 57.0% ที่ 0.04 ดอลลาร์ต่อรอบ Opus ได้เพิ่มราว 10 จุดที่ 1.83 ดอลลาร์ และ Gemini เหนือขึ้นอีกเล็กน้อยที่ 3.92 ดอลลาร์
รัน CWE-bench v2 กับโมเดลของตัวเอง
แต่ละงานเป็นงาน Harbor ที่ประกอบด้วยสภาพแวดล้อม Docker คำสั่ง และตัวตรวจที่ให้ผลตายตัว ชุดข้อมูลมีไฟล์ registry.json ให้ Harbor รันทั้งชุดจากรีโพบน Hugging Face ได้โดยไม่ต้องโคลนเอง ผู้ใช้ต้องยอมรับเงื่อนไขการเข้าถึงชุดข้อมูล (dataset ถูกจำกัดสิทธิ์) และบันทึก token ของ Hugging Face ไว้ในตัวช่วยข้อมูลรับรองของ git ก่อน Collinear ยังติดป้ายงานเหล่านี้เป็นสภาพแวดล้อมสำหรับ reinforcement learning ด้วย เพื่อให้ใช้เป็นรางวัลฝึกเอเจนต์ฝ่ายป้องกันได้ ไม่ใช่แค่ประเมิน
ทำไม CWE-bench v2 จึงสำคัญ
หลายองค์กรเริ่มใช้เอเจนต์ AI ช่วยแก้ช่องโหว่และรีวิวโค้ด แต่คะแนนจากชุดทดสอบทั่วไปไม่บอกว่าเอเจนต์แก้จุดอ่อนจริงได้แค่ไหน CWE-bench v2 ให้ตัวเลขเปรียบเทียบที่ทำซ้ำได้ว่าเอเจนต์ที่ดีที่สุดแก้ได้ราวสองในสามต่อการลองครั้งเดียว และงานราว 19% ล้มเหลวทุกครั้งแม้กับโมเดลอันดับ 1 ข้อมูลนี้ช่วยตั้งความคาดหวังให้ตรงกับความจริง
สิ่งที่องค์กรไทยควรทำกับ CWE-bench v2
- ใช้เอเจนต์เป็นผู้ช่วย ไม่ใช่ผู้อนุมัติแพตช์ ให้คนและชุดทดสอบของตัวเองตรวจทุกการแก้ก่อนรวมเข้าระบบจริง เพราะแม้โมเดลที่ดีที่สุดก็ล้มเหลวในงานหนึ่งในห้า
- สร้างชุดทดสอบจากโค้ดของตัวเอง เหมือนที่ CWE-bench v2 ใช้ตัวตรวจที่ดูพฤติกรรมไม่ใช่รูปแบบแพตช์ เพื่อวัดว่าเอเจนต์ทำงานกับระบบของคุณได้หรือไม่
- เทียบต้นทุนกับผลลัพธ์ ต้นทุนต่อรอบในตารางต่างกันกว่า 90 เท่า (0.04 เทียบ 3.92 ดอลลาร์) ลองโมเดลราคาต่ำกับงานทั่วไป และเก็บโมเดลแพงไว้สำหรับงานที่ยาก
- แยกสิทธิ์ของเอเจนต์ ให้เข้าถึงเฉพาะรีโพและสภาพแวดล้อมทดสอบ ไม่ให้แตะข้อมูลจริงหรือกุญแจ ระหว่างที่ยังไม่มั่นใจ
- ตามผลชุดไม่เปิดเผย Collinear มีชุดที่เก็บไว้ต่างหากและเปิดให้ทดสอบโดยติดต่อบริษัท ซึ่งลดโอกาสที่โมเดลจะ "จำข้อสอบ" ติดตามข่าว AI อื่น ๆ ได้ที่หมวด AI
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
ทีมที่อยากลองรันเอเจนต์ AI กับรีโพของตัวเองในสภาพแวดล้อมแยก มักต้องการเซิร์ฟเวอร์ชั่วคราวที่ควบคุมสิทธิ์ได้ Cloud Linux Server ของ THAI DATA CLOUD ให้เลือก Ubuntu, AlmaLinux หรือ Debian ได้ มี Root Access เต็มรูปแบบ และตั้งอยู่ใน Data Center ไทยและสิงคโปร์ (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
คำถามที่พบบ่อย
CWE-bench v2 คืออะไร?
CWE-bench v2 คือชุดทดสอบของ Collinear AI ที่ให้เอเจนต์ AI รับสำเนารีโพโอเพนซอร์สจริงกับคำสั่งสั้น ๆ เพื่อหาและแก้จุดอ่อนด้านความปลอดภัยโดยไม่ทำให้ฟังก์ชันเดิมเสีย ชุดสาธารณะมี 100 งานครอบคลุม 91 CWE ตรวจคะแนนด้วยโปรแกรมจึงทำซ้ำได้
CWE-bench v2 โมเดลไหนได้คะแนนสูงสุด?
ตามตารางของ CWE-bench v2 ที่ Collinear AI เผยแพร่ 3 พฤศจิกายน 2026 จาก 11 โมเดล Gemini 4 Argon ได้ pass@1 67.8% และ pass@4 81.0% อันดับสอง Claude Opus 5.5 ได้ 67.3% และ 78.0% ผลเป็นของผู้จัดทำเอง และแต่ละโมเดลรันผ่านเครื่องมือคนละตัว จึงเทียบกันตรง ๆ ไม่ได้ทั้งหมด
CWE-bench v2 บอกอะไรองค์กรที่คิดใช้เอเจนต์ AI แก้ช่องโหว่?
บอกว่าเอเจนต์ที่ดีที่สุดแก้ได้ราวสองในสามต่อการลองครั้งเดียว และยังมีงาน 19% ที่ล้มเหลวทุกครั้ง จึงใช้เป็นผู้ช่วยได้แต่ต้องมีคนตรวจแพตช์และชุดทดสอบของตัวเอง ราคาต่อรอบที่ต่างกันกว่า 90 เท่ายังทำให้เลือกโมเดลตามงานและงบประมาณได้
รัน CWE-bench v2 กับโมเดลของตัวเองได้อย่างไร?
ตามคำอธิบายของผู้จัดทำ แต่ละงานเป็นงาน Harbor ที่รันใน Docker ดึงตรงจากรีโพบน Hugging Face ด้วยคำสั่ง harbor run ผู้ใช้ต้องยอมรับเงื่อนไขการเข้าถึงชุดข้อมูลที่ถูกจำกัดสิทธิ์ก่อน และบันทึก token ของ Hugging Face ไว้กับ git จากนั้นรัน 4 ครั้งต่องานเพื่อคำนวณคะแนน
แหล่งอ้างอิง
- CWE-bench v2: More coverage, quality, and transparency — Collinear AI (Hugging Face blog)
- CWE-bench v2 leaderboard — Collinear AI (Hugging Face Space)
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Hugging Face20OpenRouter4DeepSeek17
- ประเทศและสถานที่
- สิงคโปร์214
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ