
MAI-DxO วินิจฉัยโรคเคสยากถูก 83% ผลวิจัย Microsoft ตีพิมพ์ใน Science เทียบแพทย์ 22–36%
Microsoft ตีพิมพ์ผล MAI-DxO วินิจฉัยโรคใน Science 22 ต.ค. 2026 ถูก 83% ในเคสยาก 304 เคสของ NEJM เทียบแพทย์ 22–36% แต่ยังเป็นการทดสอบจำลอง ไม่ใช่ผู้ป่วยจริง
โดย กองบรรณาธิการ THAI DATA อ่าน 6 นาที ผู้เข้าชม 1
สรุปประเด็นสำคัญ
- Microsoft AI เผยแพร่งานวิจัย MAI-DxO (Microsoft AI Diagnostic Orchestrator) ในวารสาร Science เมื่อ 22 ตุลาคม 2026 พร้อมชุดทดสอบ SDBench ที่ให้ AI และแพทย์ถามประวัติและสั่งตรวจทีละขั้น
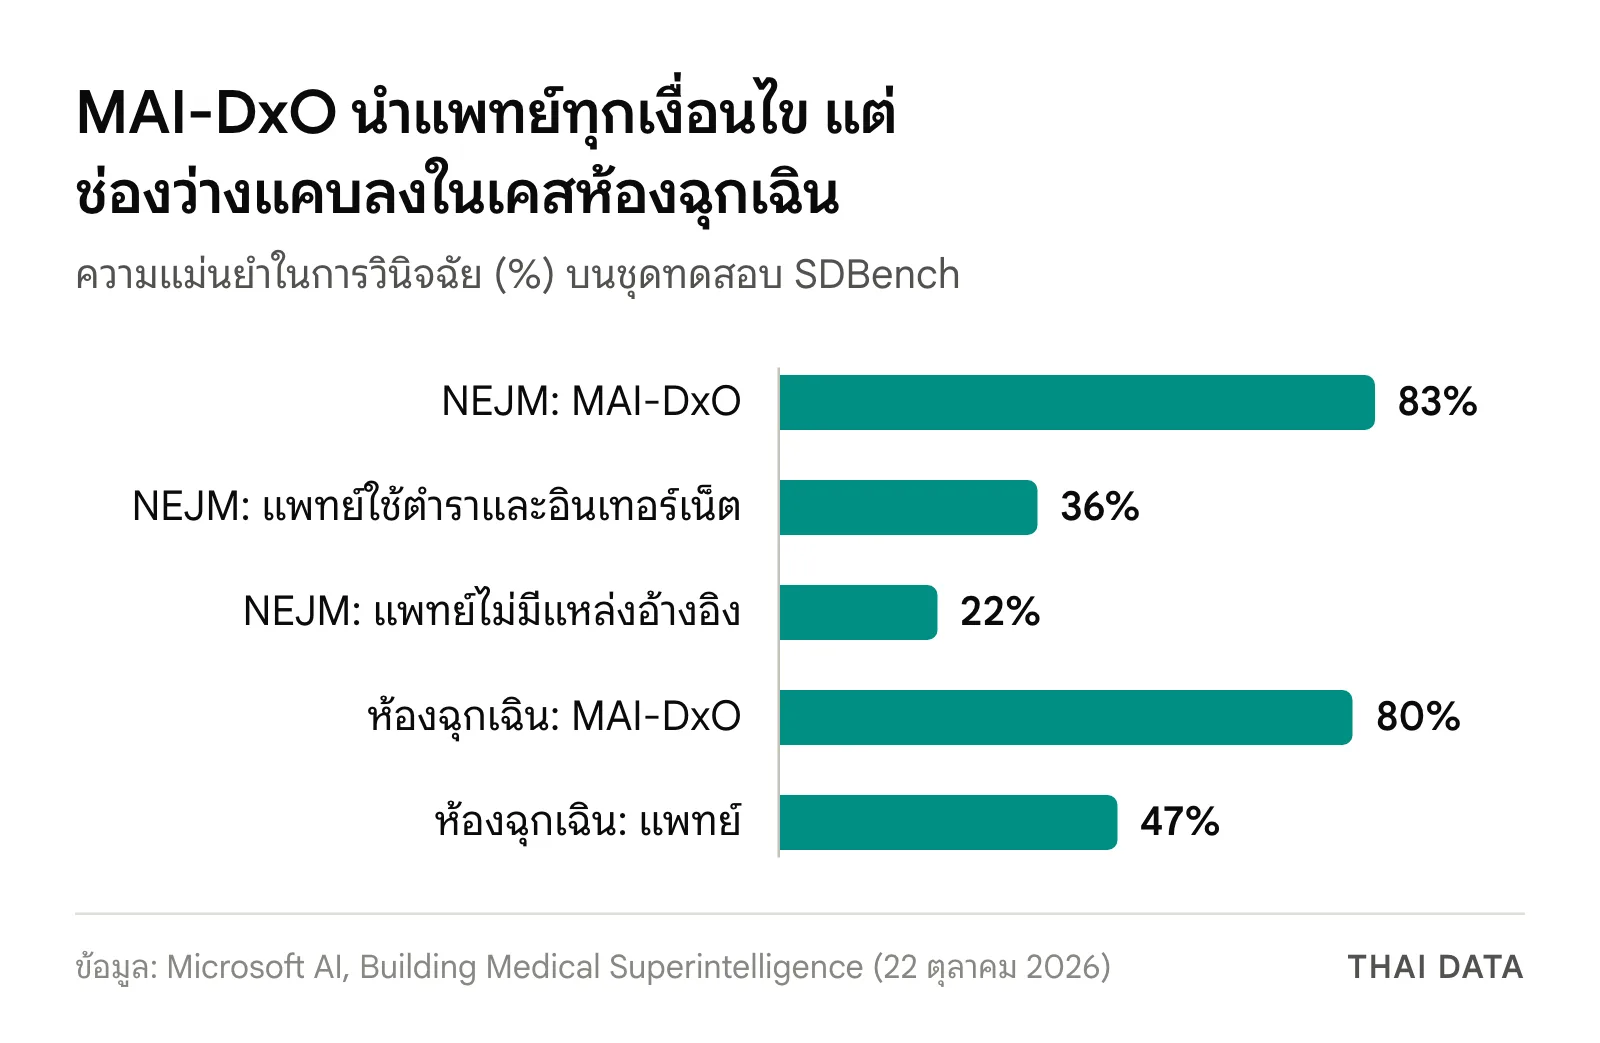
- ในเคสซับซ้อน 304 เคส จาก NEJM MAI-DxO วินิจฉัยโรคถูก 83% ขณะที่แพทย์ทำได้ 22% เมื่อไม่มีตำรา และ 36% เมื่อใช้ตำราและอินเทอร์เน็ตได้ หรือราว 3.7 และ 2.3 เท่า
- ในเคสห้องฉุกเฉินทั่วไปจากชุดข้อมูล MIMIC-IV-ED ระบบได้ 80% เทียบแพทย์ 47% ส่วนค่าตรวจเฉลี่ยต่อเคสในกราฟของ Microsoft อยู่ระหว่าง 1,303–5,431 ดอลลาร์ ตามงบที่ตั้ง
- ผล MAI-DxO วินิจฉัยโรคทั้ง 2 ชุดเคสมาจากการทดสอบจำลอง ขั้นต่อไปคือการศึกษากับผู้ป่วยจริงร่วมกับ Beth Israel Deaconess Medical Center ในบอสตัน
Microsoft AI เผยแพร่งานวิจัยในวารสาร Science เมื่อวันที่ 22 ตุลาคม 2026 ว่าระบบ MAI-DxO วินิจฉัยโรคในเคสซับซ้อน 304 เคสจาก The New England Journal of Medicine (NEJM) ได้ถูกต้อง 83% ขณะที่แพทย์ทำได้ 22% เมื่อไม่มีตำรา และ 36% เมื่อใช้ตำราและอินเทอร์เน็ตได้ ผลนี้มาจากการทดสอบจำลองบนชุดเคส ยังไม่ใช่การดูแลผู้ป่วยจริง
คำว่า "แม่นยำเกือบ 4 เท่า" ที่ Microsoft ใช้ในประกาศจึงเป็นกรณีที่ห่างที่สุด คือเทียบกับแพทย์ที่ไม่มีแหล่งอ้างอิงใด ๆ ในเคสที่ยากที่สุดของวงการแพทย์ บทความนี้สรุปว่าการทดสอบ MAI-DxO วินิจฉัยโรคออกแบบอย่างไร ตัวเลขแต่ละตัวมาจากเงื่อนไขไหน และอะไรที่ประกาศยังไม่ได้บอก บทความนี้เป็นข่าวเทคโนโลยี ไม่ใช่คำแนะนำทางการแพทย์
MAI-DxO วินิจฉัยโรคอย่างไร
MAI-DxO ย่อมาจาก Microsoft AI Diagnostic Orchestrator Microsoft อธิบายว่าระบบไม่ได้ให้โมเดลตัวเดียวตอบทันที แต่ทำงานเหมือนคณะแพทย์เสมือน แต่ละบทบาทเสนอโรคที่เป็นไปได้ เลือกคำถามหรือการตรวจที่มีประโยชน์ และโต้แย้งข้อสรุปที่กำลังก่อตัว ระบบประสานการถกกันหลายรอบ ปรับการประเมินเมื่อได้ผลตรวจใหม่ และชั่งว่าการตรวจแต่ละอย่างคุ้มกับค่าใช้จ่ายหรือไม่
ชุดทดสอบที่ใช้ชื่อ SDBench (Sequential Diagnosis Benchmark) ซึ่ง Microsoft สร้างขึ้นเพราะมองว่าข้อสอบใบอนุญาตแพทย์อย่าง USMLE ให้ข้อมูลทั้งหมดตั้งแต่ต้นแล้วให้เลือกคำตอบเดียว ต่างจากงานจริงที่แพทย์ต้องค่อย ๆ ถามประวัติ สั่งตรวจ และปรับการวินิจฉัยตามผลที่ได้ หน้า SDBench ของ Microsoft อธิบายองค์ประกอบไว้ดังนี้
- ผู้วินิจฉัย (AI หรือแพทย์) เริ่มจากสรุปเคสสั้น ๆ ที่ยังไม่เฉลยโรค แล้วเลือกเองว่าจะถามหรือสั่งตรวจอะไรต่อ
- Gatekeeper ตอบคำถามและผลตรวจจากเนื้อหาเต็มของเคส และสร้างผลตรวจสังเคราะห์ที่สมจริงเมื่อเคสต้นฉบับไม่มีผลนั้น
- Judge ให้คะแนนคำวินิจฉัยเทียบกับคำตอบจริงด้วยมาตรวัด 1–5 โดยคะแนน 4–5 นับว่าถูก
- ทุกเคสวัดทั้งความถูกต้อง หลักฐานที่ขอ และค่าตรวจโดยประมาณ จึงประเมินทั้งคำตอบและเส้นทางที่ไปถึงคำตอบ
ผลทดสอบ MAI-DxO วินิจฉัยโรคเทียบแพทย์
SDBench ใช้เคสสองชุด ชุดแรกคือเคสซับซ้อน 304 เคสจากรายงานผู้ป่วยของ NEJM ชุดที่สองคือเคสห้องฉุกเฉินที่พบบ่อยกว่าจากฐานข้อมูล MIMIC-IV-ED ซึ่ง Microsoft ไม่ได้ระบุจำนวนเคสไว้ในประกาศ ตัวเลขหลักที่ Microsoft รายงานมีดังนี้
| ชุดเคส | MAI-DxO | แพทย์ | ห่างกัน (ตามที่ Microsoft คำนวณ) |
|---|---|---|---|
| NEJM 304 เคส แพทย์ไม่มีแหล่งอ้างอิง | 83% | 22% | ราว 3.7 เท่า |
| NEJM 304 เคส แพทย์ใช้ตำราและอินเทอร์เน็ต | 83% | 36% | ราว 2.3 เท่า |
| ห้องฉุกเฉิน MIMIC-IV-ED | 80% | 47% | มากกว่า 1.7 เท่า |
| NEJM ตั้งค่าเน้นประหยัด | 81% | – | ค่าใช้จ่ายไม่ถึงครึ่งของระบบที่เทียบ |
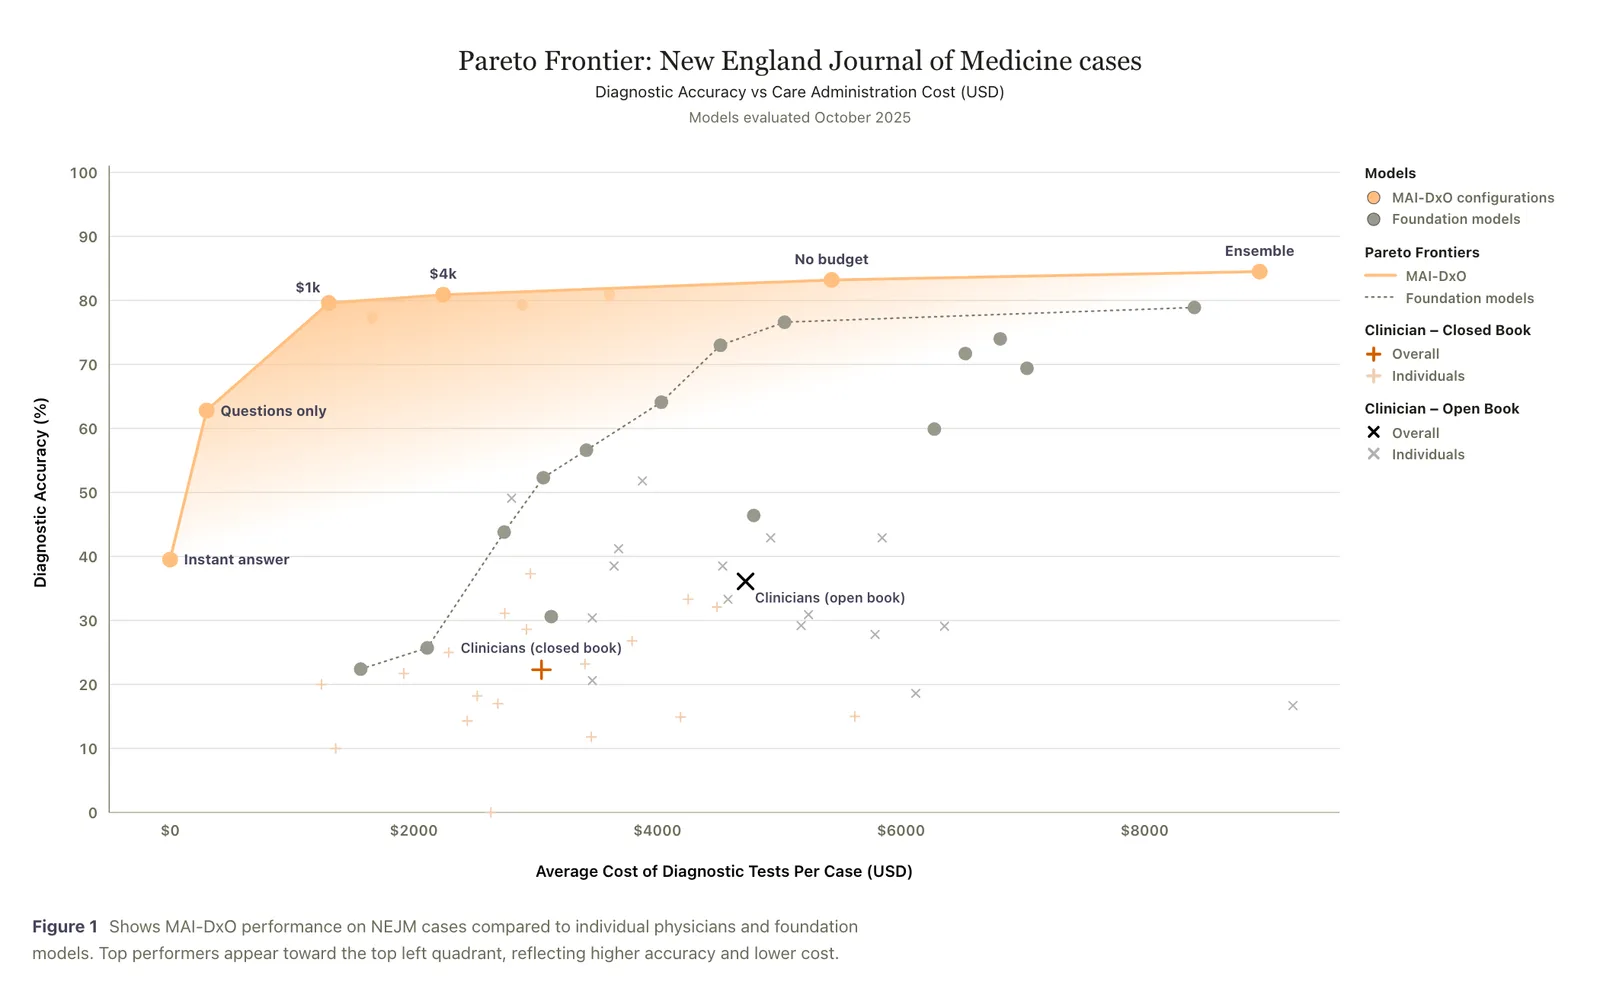
กราฟในหน้าประกาศยังแสดงค่าตรวจเฉลี่ยต่อเคส ซึ่งช่วยให้เห็นว่าความแม่นยำแลกมาด้วยอะไร ในเคส NEJM เมื่อไม่จำกัดงบ MAI-DxO ได้ 83.2% ใช้ค่าตรวจเฉลี่ย 5,431 ดอลลาร์ต่อเคส สูงกว่าแพทย์ที่ใช้ 3,049 ดอลลาร์ (ไม่มีแหล่งอ้างอิง) และ 4,724 ดอลลาร์ (ใช้ตำราและอินเทอร์เน็ต) แต่เมื่อตั้งงบ 1,000 ดอลลาร์ ระบบยังได้ 79.6% ด้วยค่าตรวจเฉลี่ย 1,303 ดอลลาร์ ส่วน GPT-5 ที่ใช้ตรง ๆ โดยไม่ผ่านระบบนี้ได้ 78.9% ด้วยค่าตรวจ 8,409 ดอลลาร์ Microsoft จึงสรุปว่าไม่มีวิธีของมนุษย์หรือ AI แบบใดที่ทั้งแม่นกว่าและถูกกว่า MAI-DxO ในทั้งสองชุดเคส
ข้อจำกัดที่ต้องอ่านคู่กับตัวเลข
ตัวเลข MAI-DxO วินิจฉัยโรคเหล่านี้มีเงื่อนไขที่ Microsoft บอกไว้เองหรือที่หน้าเอกสารของบริษัทแสดง ผู้อ่านควรรู้ก่อนตีความว่า AI เก่งกว่าหมอ
- เป็นการทดสอบจำลอง ผลตรวจบางส่วนมาจาก Gatekeeper ที่สร้างผลสังเคราะห์ขึ้นเมื่อเคสต้นฉบับไม่มี และ Microsoft เขียนเองว่าบททดสอบที่แท้จริงคือผลงานในสภาพแวดล้อมทางคลินิกจริง
- เคส NEJM คือเคสยากที่สุด ไม่ใช่ผู้ป่วยทั่วไป ในเคสห้องฉุกเฉินที่พบบ่อยกว่า ช่องว่างระหว่างระบบกับแพทย์แคบลงเหลือราว 1.7 เท่า
- เงื่อนไขของแพทย์ต่างจากงานจริง ในงานรุ่นแรกเมื่อ 30 มิถุนายน 2025 Microsoft ระบุว่าแพทย์ทำโจทย์โดยไม่มีเพื่อนร่วมงาน ตำรา หรือ AI ช่วย ซึ่งไม่ใช่วิธีทำงานปกติ ฉบับตีพิมพ์จึงเพิ่มกลุ่มที่ใช้ตำราและอินเทอร์เน็ตได้ แต่ประกาศไม่ได้บอกจำนวนแพทย์ที่ร่วมทดสอบ
- กราฟระบุว่าโมเดลถูกประเมินเมื่อตุลาคม 2025 Microsoft บอกว่าเมื่อทดสอบซ้ำกับโมเดลรุ่นใหม่กว่า รวมถึง GPT-5.5 ผลยังดีขึ้นโดยไม่ต้องเปลี่ยนวิธีประสานงาน แต่ประกาศไม่ได้ระบุว่าตัวเลขหลักใช้โมเดลพื้นฐานใด
- ยังไม่มีข้อมูลการอนุมัติ ประกาศปี 2026 ไม่ได้พูดถึงการอนุมัติจากหน่วยงานกำกับหรือการเปิดให้โรงพยาบาลใช้ ส่วนประกาศปี 2025 เขียนชัดว่างานนี้ยังไม่ได้รับอนุมัติให้ใช้ทางคลินิก
จากงานวิจัยปี 2025 ถึงฉบับที่ผ่านการตีพิมพ์
| ประเด็น | มิถุนายน 2025 (preprint) | ตุลาคม 2026 (Science) |
|---|---|---|
| การตรวจทาน | ยังไม่ผ่าน peer review | ตีพิมพ์ใน Science |
| ชุดเคส | NEJM 304 เคส | NEJM 304 เคส และเคสห้องฉุกเฉิน MIMIC-IV-ED |
| ความแม่นยำของระบบ | สูงสุด 85.5% (จับคู่กับ o3) | 83% (NEJM) และ 80% (ห้องฉุกเฉิน) |
| แพทย์ | แพทย์ 21 คนจากสหรัฐฯ และสหราชอาณาจักร เฉลี่ย 20% | 22% ไม่มีแหล่งอ้างอิง 36% ใช้ตำราและอินเทอร์เน็ต |
ส่วนที่เปิดให้คนนอกตรวจสอบผล MAI-DxO วินิจฉัยโรคได้คือ SDBench Microsoft ระบุว่าจะเปิดโค้ดของชุดทดสอบ Gatekeeper, Judge และตัวประมาณค่าตรวจสำหรับเคส NEJM บางส่วน หน้า SDBench บอกว่าในคลังโค้ดมีเคสสังเคราะห์ 5 เคสให้ลองได้ทันที ส่วนเคส NEJM ต้องขอสิทธิ์ใช้ และข้อมูล MIMIC ต้องผ่านการรับรองของ PhysioNet พร้อมข้อตกลงการใช้ข้อมูล
ทำไมเรื่องนี้สำคัญ
ข่าวนี้สะท้อนการเปลี่ยนวิธีวัด AI ทางการแพทย์จากคะแนนข้อสอบ ไปเป็นการวัดว่าระบบถามและสั่งตรวจอย่างไร และใช้เงินเท่าไรกว่าจะได้คำตอบ ซึ่งใกล้กับคำถามที่ผู้บริหารโรงพยาบาลสนใจมากกว่า ขั้นต่อไปคือพิสูจน์ว่า MAI-DxO วินิจฉัยโรคได้ดีกับผู้ป่วยจริง ผ่านการศึกษาไปข้างหน้ากับ Beth Israel Deaconess Medical Center ในบอสตัน ที่ผู้ป่วยจะโต้ตอบกับระบบโดยตรงแล้ววัดผลเทียบกับการประเมินของแพทย์ที่ทำแยกกัน
Microsoft ยังรวมทีมสุขภาพจากทั่วบริษัท รวมทีมที่ทำ Dragon Copilot กับ PowerScribe เข้ามาไว้ใน Microsoft AI และทำงานร่วมกับ Mayo Clinic เพื่อพัฒนาโมเดลจากข้อมูลทางคลินิกหลายรูปแบบ
ผลต่อองค์กรไทย
- โรงพยาบาลและผู้ซื้อระบบ AI ควรถามผู้ขายถึงผลทดสอบแบบทีละขั้นที่วัดทั้งความแม่นยำและค่าตรวจ และผลการศึกษากับผู้ป่วยจริง ไม่ใช่แค่คะแนนข้อสอบแพทย์ เพราะตัวเลขของ MAI-DxO วินิจฉัยโรคเองยังมาจากการทดสอบจำลอง
- ดูเงื่อนไขของตัวเลขทุกครั้ง ตัวเลข "เกือบ 4 เท่า" กับ "1.7 เท่า" มาจากงานเดียวกันแต่คนละชุดเคสและคนละเงื่อนไขของแพทย์ การสื่อสารภายในองค์กรควรบอกเงื่อนไขควบคู่เสมอ
- ทีม HealthTech และนักวิจัยไทย ใช้ SDBench ทดสอบโมเดลหรือระบบของตัวเองได้ แต่ต้องขอสิทธิ์ข้อมูล NEJM และ MIMIC ตามเงื่อนไขของเจ้าของข้อมูล และข้อมูลผู้ป่วยไทยที่จะนำมาทดสอบต้องผ่านการกำกับดูแลข้อมูลสุขภาพขององค์กร
- ผู้ใช้ทั่วไป ยังใช้ MAI-DxO วินิจฉัยโรคเองไม่ได้ ระบบนี้ไม่ใช่เครื่องมือวินิจฉัยตัวเอง หากมีอาการผิดปกติควรพบแพทย์
ติดตามข่าว AI สำหรับองค์กรเพิ่มเติมได้ที่หมวด AI
คำถามที่พบบ่อย
MAI-DxO คืออะไร?
MAI-DxO หรือ Microsoft AI Diagnostic Orchestrator คือระบบ AI ของ Microsoft AI ที่ทำงานเหมือนคณะแพทย์เสมือนหลายคน MAI-DxO วินิจฉัยโรคโดยให้แต่ละบทบาทเสนอโรคที่เป็นไปได้ เลือกคำถามหรือการตรวจ และแย้งกันหลายรอบ พร้อมชั่งว่าการตรวจคุ้มค่าใช้จ่ายหรือไม่
MAI-DxO วินิจฉัยโรคแม่นกว่าแพทย์จริงไหม?
ในการทดสอบจำลองที่ตีพิมพ์ใน Science เมื่อ 22 ตุลาคม 2026 MAI-DxO วินิจฉัยโรคเคสซับซ้อนของ NEJM ถูก 83% เทียบแพทย์ 22% เมื่อไม่มีตำรา และ 36% เมื่อใช้ตำราและอินเทอร์เน็ต แต่เป็นการทดสอบบนชุดเคส ไม่ใช่การดูแลผู้ป่วยจริง Microsoft จึงวางแผนศึกษากับผู้ป่วยจริงต่อ
ตัวเลขแม่นกว่าแพทย์เกือบ 4 เท่ามาจากไหน?
มาจากผล MAI-DxO วินิจฉัยโรคถูก 83% หารด้วย 22% ของแพทย์ที่ไม่มีตำราหรืออินเทอร์เน็ต ในเคสยาก 304 เคสของ NEJM ได้ราว 3.7 เท่า ถ้าเทียบกับแพทย์ที่ใช้ตำราและอินเทอร์เน็ตได้จะเหลือราว 2.3 เท่า และในเคสห้องฉุกเฉินทั่วไปเหลือราว 1.7 เท่า
โรงพยาบาลหรือคนทั่วไปใช้ MAI-DxO ได้แล้วหรือยัง?
ยังไม่ได้ ประกาศวันที่ 22 ตุลาคม 2026 ไม่ได้ระบุการอนุมัติจากหน่วยงานกำกับหรือกำหนดเปิดให้ใช้ ผล MAI-DxO วินิจฉัยโรคยังมาจากการทดสอบจำลอง ขั้นต่อไปคือการศึกษากับผู้ป่วยจริงร่วมกับ Beth Israel Deaconess Medical Center ส่วนที่เปิดให้นักวิจัยใช้คือโค้ด SDBench
แหล่งอ้างอิง
- Building Medical Superintelligence — Microsoft AI
- SDBench: Sequential Diagnosis Benchmark — Microsoft
- The Path to Medical Superintelligence — Microsoft AI
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Microsoft124
- ประเทศและสถานที่
- สหรัฐอเมริกา445สหราชอาณาจักร186
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ