
Databricks Agent Memory เปิด Beta ให้ AI Agent จำผู้ใช้ข้ามบทสนทนา เก็บบน Lakebase
Databricks Agent Memory เปิด Beta 20 ต.ค. 2026 ให้ AI Agent จำความชอบ ข้อเท็จจริง และวิธีทำงานข้ามบทสนทนา เก็บใน Lakebase ใน workspace ขององค์กร
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- Databricks ประกาศ Databricks Agent Memory บนแพลตฟอร์ม Agent Bricks เมื่อ 20 ตุลาคม 2026 (เวลาสหรัฐฯ) สถานะ Beta ประกอบด้วย managed sessions, managed memory และ memory pipelines
- ข้อมูลทั้งหมดเก็บใน Lakebase ซึ่งเป็น Postgres แบบ serverless ใน workspace ของลูกค้า เริ่มใช้ได้ด้วยแพ็กเกจ
databricks-agentbricksรุ่น 0.6.0 ขึ้นไปกับ agent ภาษา Python 3.10 ขึ้นไป - ผลทดสอบภายในของ Databricks จากงานข้อมูลองค์กร 114 กรณี ระบุว่า agent ที่มีหน่วยความจำผ่านงาน 68.4% เทียบกับ 22.3% เมื่อไม่มี ใช้โทเคนน้อยลง 31% และเร็วขึ้น 26%
- เอกสารของ Databricks ระบุว่า store คือขอบเขตความปลอดภัย ใครเข้าถึง store ได้จะอ่านและเขียนได้ทุกรายการ จึงแนะนำให้แยก store ต่อ tenant
Databricks เปิดตัว Databricks Agent Memory เมื่อวันที่ 20 ตุลาคม 2026 (เวลาสหรัฐฯ) เป็นบริการหน่วยความจำของ AI Agent บนแพลตฟอร์ม Agent Bricks สถานะ Beta ที่ให้ agent จำความชอบ ข้อเท็จจริง และวิธีทำงานของผู้ใช้ข้ามบทสนทนา โดยเก็บข้อมูลไว้ใน Lakebase ภายใน workspace ขององค์กร Databricks อ้างว่าในชุดทดสอบภายใน agent ที่มีหน่วยความจำผ่านงานได้ราว 3 เท่าและใช้โทเคนน้อยลง 31%
ปัญหาที่ Databricks ยกขึ้นมาคือ agent ส่วนใหญ่เป็นแบบ stateless จบบทสนทนาแล้วลืมทุกอย่าง วันรุ่งขึ้นต้องค้นหาใหม่ว่าตารางไหนเก็บข้อมูลอะไร ตัวย่อภายในบริษัทหมายถึงอะไร หรือ join แบบไหนใช้ได้จริง ส่วนผู้ใช้ที่เคยแก้คำตอบหรือบอกความชอบไว้ก็ต้องพูดซ้ำทุกครั้ง ทีมพัฒนาจึงมักใส่ประวัติทั้งหมดกลับเข้า context หรือสร้างระบบหน่วยความจำเองบน object storage หรือ vector database ซึ่ง Databricks มองว่าทั้งสองทางมีต้นทุนแฝง
Databricks Agent Memory มีอะไรบ้าง
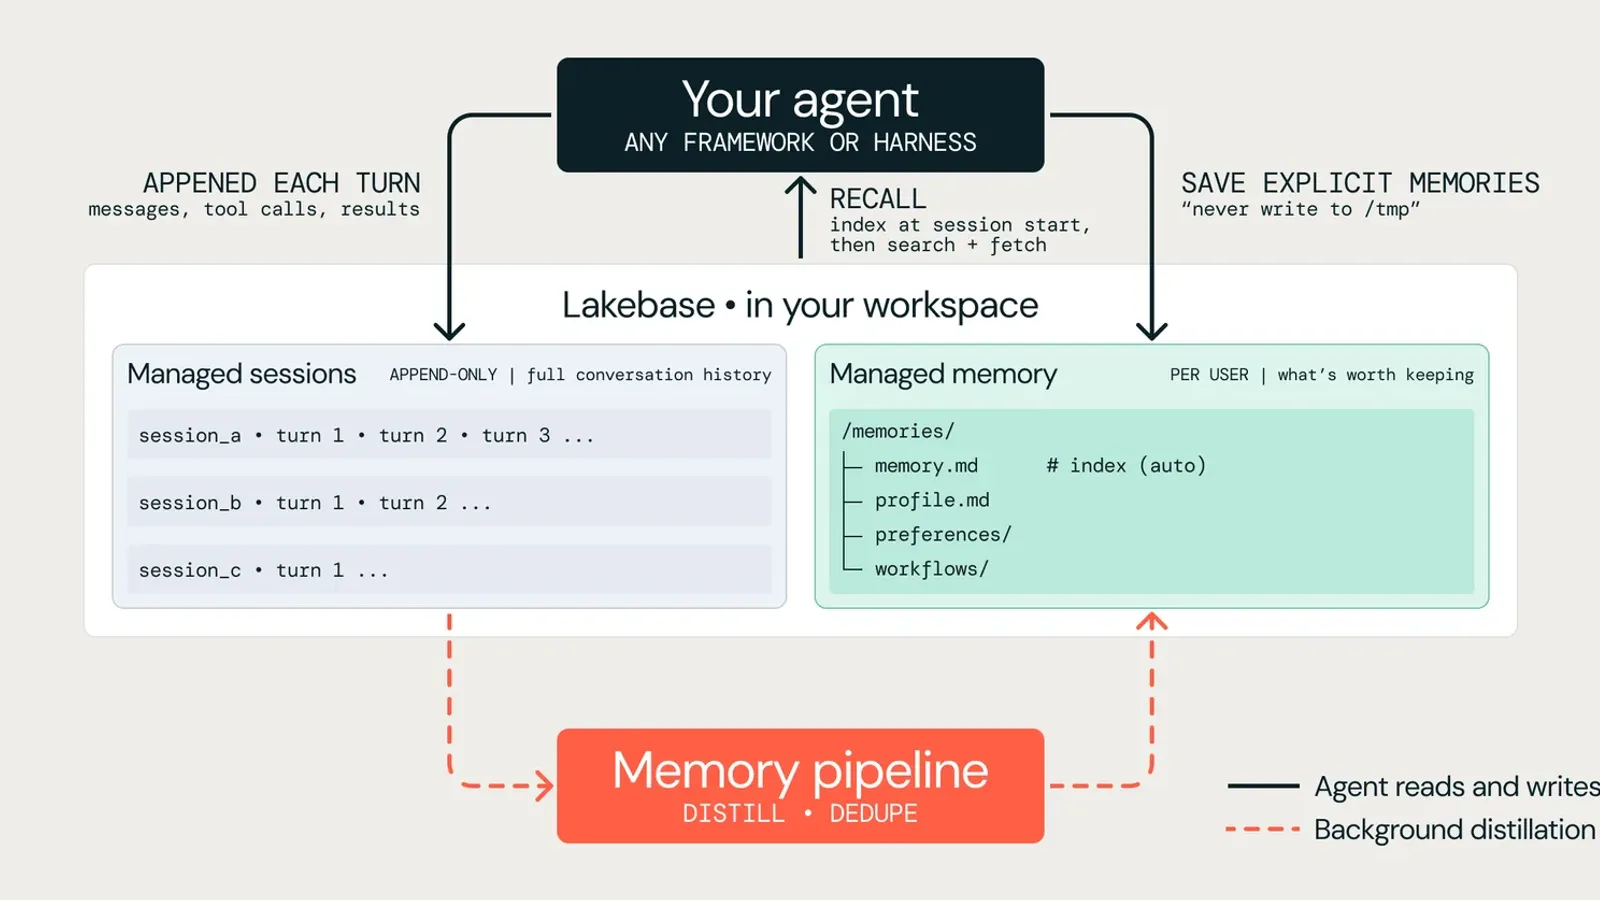
Databricks Agent Memory แบ่งเป็น 3 ส่วน ทำงานแยกกันได้แต่ออกแบบให้ใช้คู่กัน
- Managed sessions บันทึกแต่ละบทสนทนาเป็นลำดับข้อความ tool calls และผลลัพธ์ ในรูปแบบของเฟรมเวิร์กที่ agent ใช้อยู่ ให้ agent กลับมาคุยต่อจากจุดเดิมได้
- Managed memory เก็บสิ่งที่ควรจำระยะยาว เช่น โปรไฟล์ ความชอบ ความรู้เฉพาะโดเมน และขั้นตอนการทำงาน เมื่อเริ่มบทสนทนา agent โหลดดัชนีของสิ่งที่รู้อยู่แล้ว แล้วค้นรายละเอียดด้วย hybrid search ที่รวมคำค้นกับ semantic search
- Memory pipelines สรุปบทสนทนาเป็นหน่วยความจำระยะยาวในเบื้องหลัง แบบสั่งเองหรือตามรอบเวลา ดึงข้อเท็จจริงที่คงทน ตัดรายการซ้ำ และแทนที่ข้อมูลเก่าที่บทสนทนาใหม่ขัดแย้ง
ข้อมูลของ Databricks Agent Memory ทั้งหมดเก็บใน Lakebase ซึ่งเป็น Postgres แบบ serverless ที่ Databricks สร้างไว้ใน workspace ของลูกค้าและดูแลระบบให้ เอกสารของ Databricks ย้ำว่าการลบ session หรือทั้ง session store ไม่ได้ลบหน่วยความจำที่สรุปไว้แล้วใน memory store เพราะสองส่วนนี้แยกกัน ระบบเดียวกันนี้เป็นตัวที่ทำงานอยู่เบื้องหลังหน่วยความจำของ Genie ผู้ช่วยถามข้อมูลด้วยภาษาธรรมชาติของ Databricks อยู่แล้ว
ผลทดสอบของ Databricks Agent Memory ที่ Databricks อ้าง
Databricks Agent Memory พัฒนาจากงานวิจัยชื่อ MemCurrent ของทีม Databricks AI Research ซึ่งแยกหน่วยความจำเป็นสองชั้น คือ episodic memory ที่เก็บบันทึกดิบของแต่ละ session และ derived memory ที่เป็นข้อสรุปจากบันทึกเหล่านั้น โดยมีกระบวนการเบื้องหลังที่ทีมวิจัยเรียกว่า "dreaming" คอยรวบรวมและจัดระเบียบ
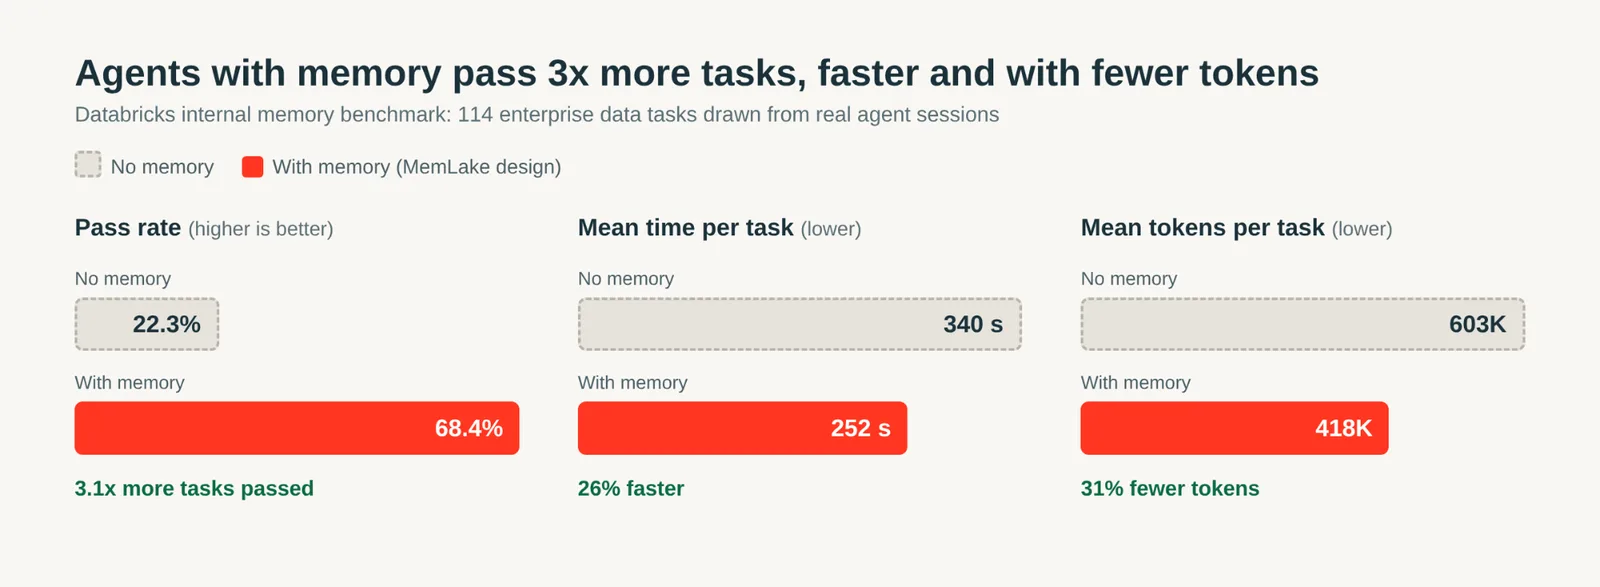
ชุดทดสอบภายในสร้างจากบทสนทนาจริงใน Genie กว่า 12,000 sessions คัดเหลือ 114 กรณีทดสอบจากผู้ใช้ 29 คนและประวัติ 2,233 sessions ผลตามกราฟในบล็อกประกาศของ Databricks เป็นดังนี้
| ตัวชี้วัด (ชุดทดสอบภายในของ Databricks) | ไม่มีหน่วยความจำ | มีหน่วยความจำ |
|---|---|---|
| อัตราผ่านงาน | 22.3% | 68.4% (มากกว่า 3.1 เท่า) |
| เวลาเฉลี่ยต่องาน | 340 วินาที | 252 วินาที (เร็วขึ้น 26%) |
| โทเคนเฉลี่ยต่องาน | 603K | 418K (น้อยลง 31%) |
Databricks ยกตัวอย่างจากงานวิจัยว่า agent ตัวหนึ่งใช้ 11 tool calls และ subagent 8 ตัว เวลาเกือบ 6 นาที เพื่อตอบคำถามเรื่องลูกค้ารายใหญ่ของสินค้าหนึ่ง หลังบันทึกขั้นตอนนั้นลงหน่วยความจำ คำถามต่อเนื่องที่เกี่ยวข้องใช้เพียง 2 tool calls และ 41 วินาที ส่วนวิธีใส่ประวัติทั้งหมดกลับเข้า context นั้น Databricks ระบุว่าใน benchmark หน่วยความจำแบบโอเพนซอร์สใช้ input tokens ต่อคำถามมากกว่าหน่วยความจำที่ออกแบบดีราว 12 เท่าที่ความแม่นยำเท่ากัน ตัวเลขทั้งหมดนี้เป็นผลทดสอบของผู้ผลิตเองกับชุดทดสอบภายใน ไม่ใช่การทดสอบ Databricks Agent Memory โดยหน่วยงานอิสระ
วิธีเริ่มใช้ Databricks Agent Memory และเงื่อนไขช่วง Beta
เอกสารของ Databricks ระบุเงื่อนไขหลักของ Databricks Agent Memory ไว้ดังนี้
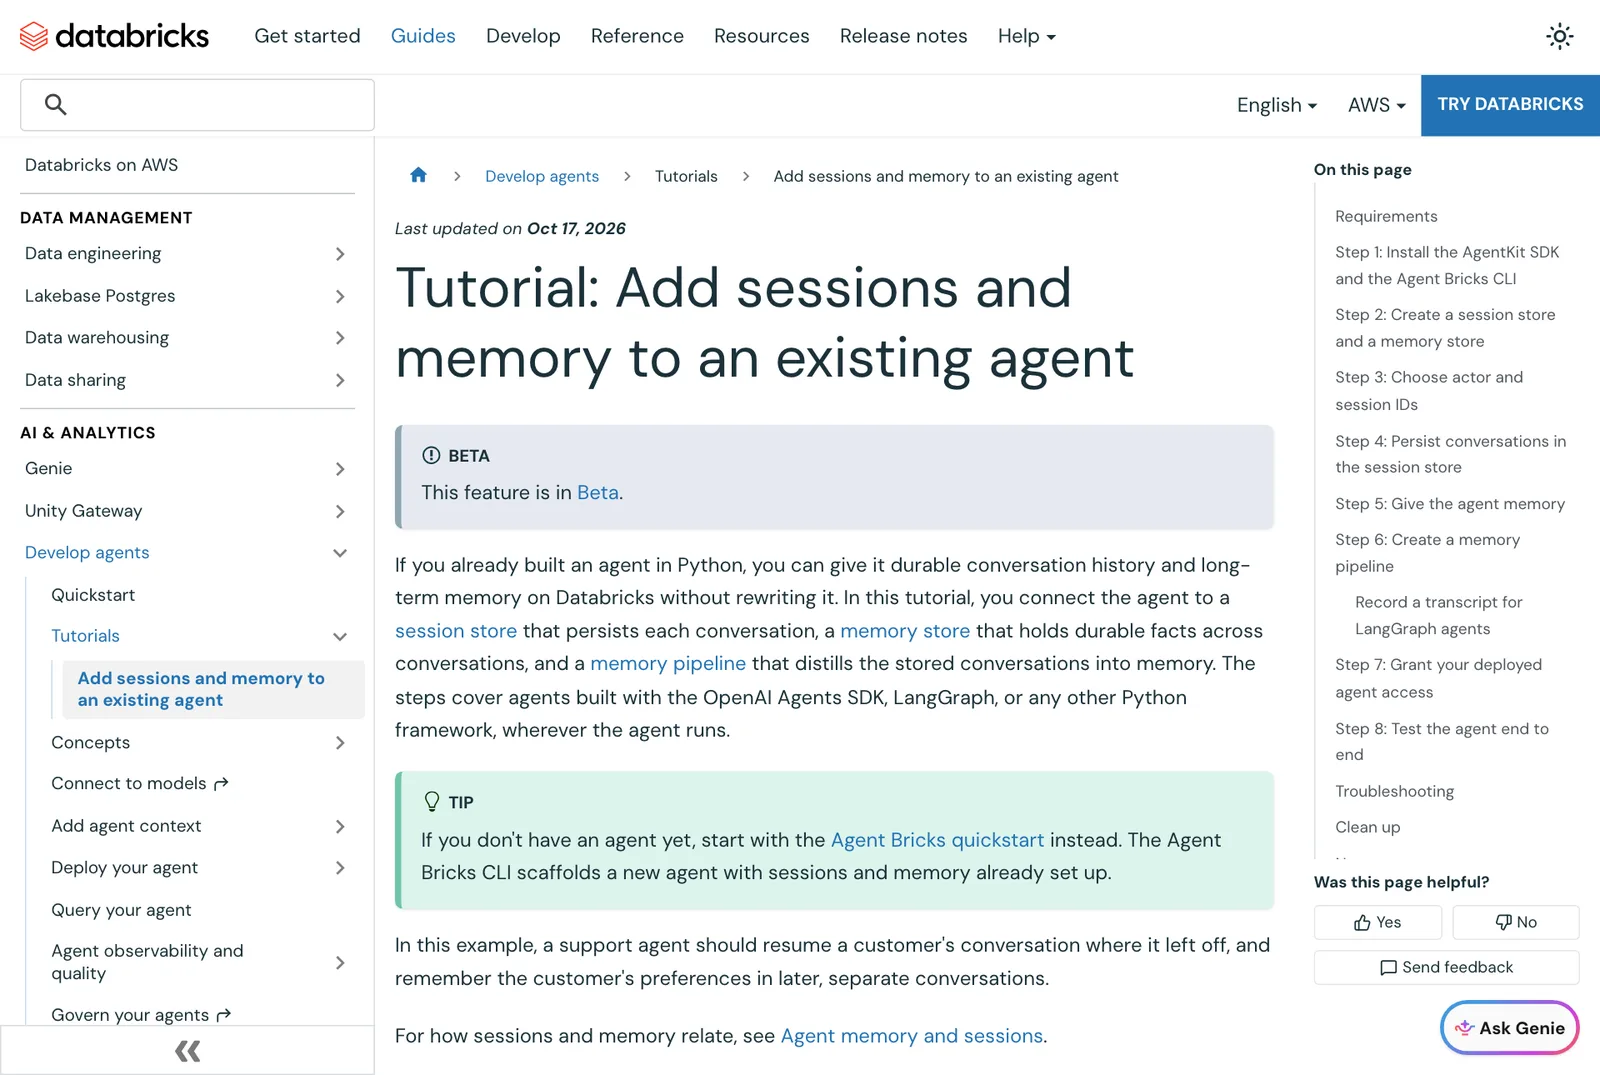
- ใช้กับ agent ภาษา Python 3.10 ขึ้นไป มีขั้นตอนเฉพาะสำหรับ OpenAI Agents SDK และ LangGraph ส่วนเฟรมเวิร์กอื่นเรียก AgentKit SDK โดยตรง และ agent จะรันที่ใดก็ได้
- ติดตั้งแพ็กเกจ
databricks-agentbricksรุ่น 0.6.0 ขึ้นไป ซึ่งรวม AgentKit SDK, Agent Bricks CLI และ adapter ของเฟรมเวิร์ก - ทุกการเรียกใช้ store ต้องระบุ
actor_id(หน่วยความจำนี้เป็นของใคร) และsession_id(บทสนทนาไหน) memory pipeline จะเขียนหน่วยความจำของแต่ละคนภายใต้actor_idเดียวกับ session ของคนนั้น - store คือขอบเขตความปลอดภัย ผู้ใดเข้าถึง store ได้จะอ่านและเขียนได้ทุกรายการ เอกสารจึงแนะนำให้สร้าง store แยกต่อ tenant เมื่อต้องกั้นข้อมูลลูกค้าแต่ละราย
- นักพัฒนาอ่าน ส่งออก และลบรายการที่ agent จำเกี่ยวกับผู้ใช้แต่ละคนได้ และสั่ง memory pipeline ได้ว่าให้เก็บหรือข้ามอะไร เช่น ให้เก็บความชอบของลูกค้าแต่ไม่เก็บบันทึกการดีบักครั้งเดียว
- ระบบหน่วยความจำแบบเดิมที่กำกับด้วย Unity Catalog ถูกจัดเป็น legacy และไม่แนะนำสำหรับ agent ใหม่
ทำไมเรื่องนี้สำคัญ
เมื่อ AI Agent ขยับจากเดโมไปใช้งานจริงทุกวัน ต้นทุนโทเคนและความสม่ำเสมอของคำตอบกลายเป็นตัวตัดสินว่าจะขยายผลได้หรือไม่ การที่ Databricks ย้ายหน่วยความจำมาอยู่ในฐานข้อมูล Postgres ที่อยู่ใน workspace เดียวกับข้อมูลองค์กร ทำให้หน่วยความจำของ agent กลายเป็นข้อมูลอีกชุดที่ต้องกำกับดูแลเหมือนตารางอื่น แทนที่จะกระจายอยู่ใน vector database หรือไฟล์ของแต่ละทีม งานวิจัย MemCurrent ยังอ้างว่าแนวทางนี้ดีกว่า Mem0 และระบบหน่วยความจำอื่นที่นำมาเทียบในชุดทดสอบเดียวกันทั้งด้านอัตราผ่านและจำนวนโทเคน
Databricks Agent Memory เป็นส่วนเสริมของ Agent Bricks ซึ่งมี agent hosting, Databricks Sandbox, Unity Gateway, MCP server สำเร็จรูป และระบบ tracing กับ evaluation อยู่แล้ว ต่อจากการเปิด Private Network Gateway ให้ Serverless และDatabricks Transactions ในเดือนเดียวกัน
ผลต่อองค์กรไทย
- ถือว่าข้อมูลใน Databricks Agent Memory เป็นข้อมูลส่วนบุคคล ความชอบ การตัดสินใจ และโปรไฟล์ที่ผูกกับ
actor_idของพนักงานหรือลูกค้าอาจอยู่ในขอบเขต PDPA ควรกำหนดระยะเวลาเก็บ วิธีลบเมื่อเจ้าของข้อมูลขอ และบันทึกไว้ในเอกสารการประมวลผลข้อมูล - ออกแบบ store ตามขอบเขตสิทธิ์ เพราะใครเข้าถึง store ได้จะเห็นทุกรายการ งานที่ให้บริการลูกค้าหลายรายหรือหลายบริษัทในเครือควรแยก store ต่อ tenant ตั้งแต่แรก
- เขียนคำสั่งให้ memory pipeline ระบุชัดว่าห้ามเก็บเลขบัตรประชาชน ข้อมูลสุขภาพ หรือข้อมูลการเงินที่ผู้ใช้พิมพ์มาในบทสนทนา และตรวจผลการสรุปเป็นระยะ
- ทดสอบต้นทุนกับงานจริงก่อนขยาย ตัวเลขโทเคนลดลง 31% มาจากชุดทดสอบของ Databricks เอง ควรวัดผล Databricks Agent Memory เทียบกับ agent เดิมขององค์กรช่วง Beta และระวังว่า Beta อาจเปลี่ยนรูปแบบ API
- ตรวจตำแหน่งข้อมูล หน่วยความจำอยู่ใน Lakebase ของ workspace จึงอยู่ใน region เดียวกับ workspace องค์กรที่มีข้อกำหนดเรื่องที่ตั้งข้อมูลควรยืนยันก่อนเปิดใช้
ติดตามข่าวฐานข้อมูลและ Data Platform เพิ่มเติมได้ที่หมวด Data
คำถามที่พบบ่อย
Databricks Agent Memory คืออะไร?
Databricks Agent Memory คือบริการหน่วยความจำแบบ managed บน Agent Bricks ที่ให้ AI Agent เก็บประวัติบทสนทนา (sessions) และจำข้อเท็จจริง ความชอบ และขั้นตอนการทำงานของผู้ใช้ข้ามบทสนทนา (memory) โดยเก็บไว้ใน Lakebase ใน workspace ขององค์กร เปิดเป็น Beta เมื่อ 20 ตุลาคม 2026
Databricks Agent Memory ใช้กับ agent ที่สร้างด้วยเฟรมเวิร์กอื่นได้ไหม?
ได้ เอกสารของ Databricks ระบุว่า Databricks Agent Memory ใช้ได้กับ agent ภาษา Python 3.10 ขึ้นไป มีขั้นตอนเฉพาะสำหรับ OpenAI Agents SDK และ LangGraph ส่วนเฟรมเวิร์กอื่นเรียกผ่าน AgentKit SDK ในแพ็กเกจ databricks-agentbricks รุ่น 0.6.0 ขึ้นไป และ agent ไม่จำเป็นต้องรันบน Databricks
หน่วยความจำของ agent ช่วยลดค่าใช้จ่ายได้จริงหรือไม่?
Databricks อ้างผลทดสอบของตัวเองว่า agent ที่ใช้ Databricks Agent Memory ใช้โทเคนเฉลี่ยต่องานลดลง 31% และตัวอย่างหนึ่งลดจาก 11 tool calls เกือบ 6 นาที เหลือ 2 tool calls 41 วินาที แต่เป็นตัวเลขจากชุดทดสอบภายใน องค์กรควรวัดกับงานจริงของตัวเองก่อน
ข้อมูลที่ agent จำไว้เกี่ยวกับ PDPA อย่างไร?
หน่วยความจำที่ผูกกับผู้ใช้แต่ละคน เช่น ความชอบและการตัดสินใจ อาจเป็นข้อมูลส่วนบุคคล Databricks ระบุว่านักพัฒนาอ่าน ส่งออก และลบรายการที่ Databricks Agent Memory เก็บเกี่ยวกับผู้ใช้แต่ละคนได้ องค์กรจึงควรกำหนดระยะเวลาเก็บ วิธีลบตามคำขอ และสิทธิ์เข้าถึง store ให้ชัดก่อนใช้งาน
แหล่งอ้างอิง
- Introducing Agent Memory on Databricks — Databricks
- MemCurrent: Designing Persistent Memory for Production Agents — Databricks
- Agent memory and sessions — Databricks Documentation
- Tutorial: Add sessions and memory to an existing agent — Databricks Documentation
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Databricks12OpenAI36Unity2
- ประเทศและสถานที่
- สหรัฐอเมริกา324
- ผลิตภัณฑ์และเทคโนโลยี
- Python19Unity Catalog7PostgreSQL11
- กฎหมายและมาตรฐาน
- PDPA110
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ