
NVIDIA Auto Ontology โอเพนซอร์สสร้าง semantic layer ให้ AI agent เขียน SQL ตรงความหมาย
NVIDIA Auto Ontology เป็นไลบรารีโอเพนซอร์ส Apache-2.0 สร้างชั้นความหมายธุรกิจจากเมทาดาทา ให้ AI agent ถามฐานข้อมูลเป็น SQL ผ่าน MCP CLI และ API ได้แม่นขึ้น
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- README ของ NVIDIA Auto Ontology บนโปรเจกต์ GitHub ของ NVIDIA ระบุว่าเป็นไลบรารีโอเพนซอร์สสัญญา Apache-2.0 ที่สร้างชั้น context จากเมทาดาทาองค์กร และเปิดให้ agent ใช้ผ่าน 3 ช่องทาง คือ MCP, CLI และ API
- ชุดโปรเจกต์ใช้ Postgres กับ pgvector เก็บแค็ตตาล็อกและ ontology มี FastAPI และ Next.js 16 เป็นส่วนประกอบ และเชื่อมฐานข้อมูล 4 ชนิด ได้แก่ Databricks, Postgres, Snowflake และ DuckDB
- ค่าตั้งต้นเรียกโมเดลผ่าน NVIDIA NIM เช่น nvidia/nemotron-3-nano-30b-a3b เป็น LLM และ nvidia/nemotron-3-embed-1b เป็นโมเดล embedding และต้องมี NVIDIA API key
- ถ้าเพิ่มการเชื่อมต่อฐานข้อมูลผ่านหน้าเว็บโดยไม่ตั้ง HashiCorp Vault รหัสผ่านถูกเก็บเป็นข้อความธรรมดาใน Postgres ตาม README ส่วนโปรเจกต์ ณ 3 พฤศจิกายน 2026 ยังไม่รับ contribution จากภายนอก
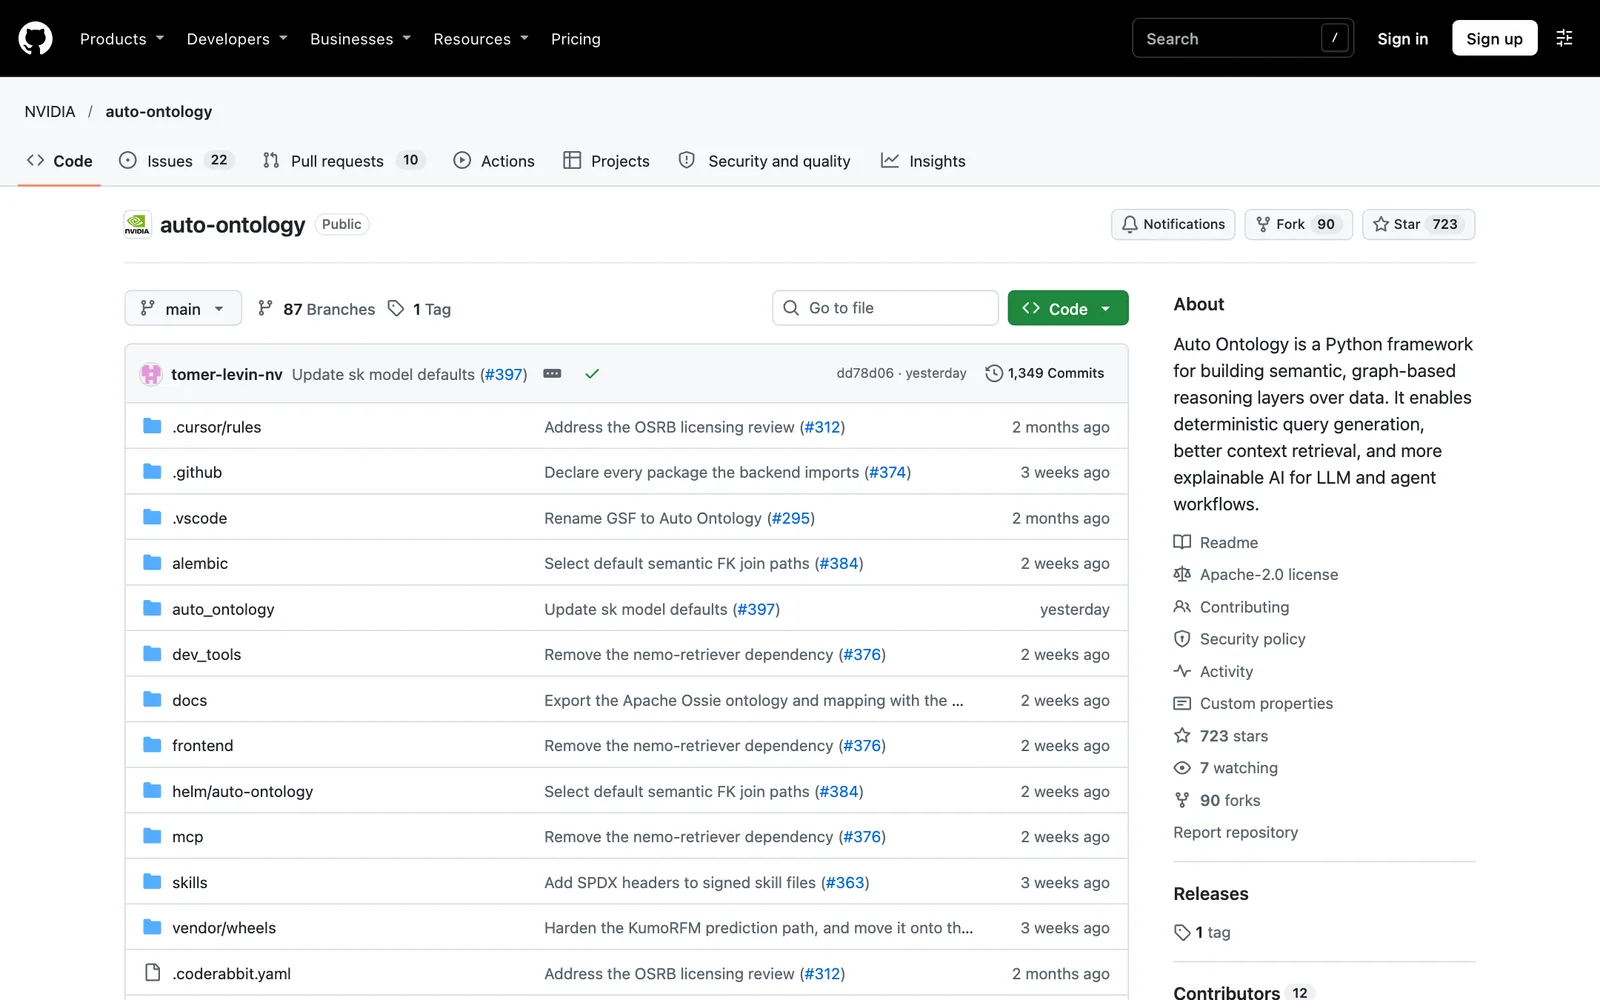
NVIDIA เปิดโอเพนซอร์สไลบรารี NVIDIA Auto Ontology บน GitHub ภายใต้สัญญา Apache-2.0 เพื่อสร้างชั้นความหมายธุรกิจ (semantic layer) จากเมทาดาทาของข้อมูลองค์กร ให้ AI agent ที่เขียน SQL ถามฐานข้อมูลได้อย่างมีบริบท ตาม README ที่เราเปิดอ่านเมื่อ 3 พฤศจิกายน 2026 ไลบรารีเปิดให้ agent เรียกผ่าน MCP, CLI และ API รวม 3 ช่องทาง
ปัญหาที่โปรเจกต์บอกว่าแก้คือความน่าเชื่อถือ README ยกตัวอย่างว่าตัวเลขรายได้ที่ตอบเร็วขึ้นแต่ผิดนั้นไม่มีค่า agent จึงต้องรู้ว่าข้อมูลอยู่ที่ไหน มีความหมายอย่างไร ควรใช้หรือไม่ และมาจากไหน
NVIDIA Auto Ontology ทำอะไรได้บ้าง
README แบ่งงานของ NVIDIA Auto Ontology เป็น 5 ขั้น
| ขั้น | สิ่งที่ README ระบุ |
|---|---|
| Discover | สร้าง ontology จากเมทาดาทา เชื่อม ontology และ semantic model ที่มีอยู่ สร้างกราฟความรู้ที่พร้อมใช้กับ AI |
| Ground | ให้ agent รู้ความหมายทางธุรกิจของเมตริก เอนทิตี และความสัมพันธ์ และจัดความหมายที่ขัดกันข้ามระบบให้ตรงกัน |
| Validate | ตรวจคำสั่งที่สร้างขึ้นกับคำนิยามที่รับรองแล้วและสายข้อมูล (lineage) แล้วคืนที่มาของคำตอบทุกครั้ง |
| Expose | ส่งบริบทให้ agent harness ใดก็ได้ผ่าน MCP, CLI และ API |
| Learn | นำคำแก้ไขที่รับรองแล้วและการใช้งานกลับเข้า ontology เพื่อให้ปรับปรุงทุกครั้งที่มีคนถาม |
README ยังระบุว่าไลบรารี "เสริม" semantic model ที่ลูกค้ามีอยู่แล้ว ไม่ได้มาแทนที่ ฟีเจอร์ที่ README ระบุยังรวมการถามข้อมูลเป็นภาษาธรรมชาติแล้วแปลงเป็น SQL ระบบยืนยันตัวตนและ RBAC หน้าเว็บสำหรับแชต วิเคราะห์ และดูแค็ตตาล็อก
ส่วนประกอบและสิ่งที่ต้องเตรียมสำหรับ NVIDIA Auto Ontology
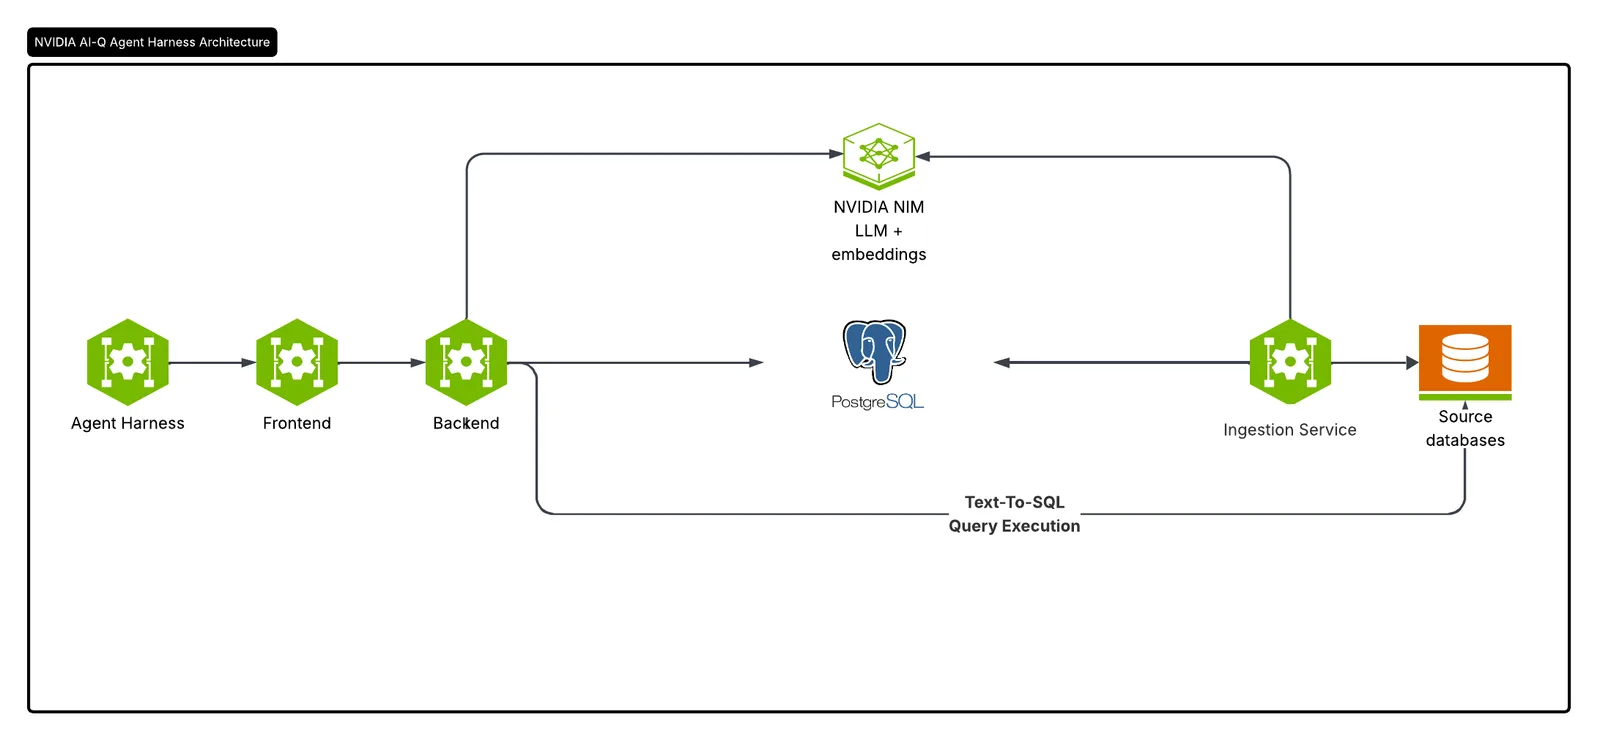
ตาม README ชุดโปรเจกต์ประกอบด้วย
- Frontend Next.js 16 (React 19, TypeScript) พร้อม Better Auth และ Prisma ทำหน้าที่หน้าเว็บ ระบบยืนยันตัวตน และเกตเวย์ API พอร์ตตั้งต้น 3000
- Backend FastAPI (Python 3.12 ขึ้นไป) และ LangChain จัดการแชตและการแปลงคำถามเป็น SQL แค็ตตาล็อก และ API ของแหล่งข้อมูล พอร์ต 3001
- Ingestion worker FastAPI นำเข้าข้อมูลตารางและเขียน embedding พอร์ต 3002
- Postgres พร้อม pgvector เก็บเมทาดาทาของแอป แค็ตตาล็อก ontology และเวกเตอร์
- HashiCorp Vault เป็นตัวเลือกสำหรับเก็บรหัสเชื่อมต่อ
การเรียกโมเดลใช้ NVIDIA NIM ได้ทั้งผ่าน NVIDIA API catalog ที่ build.nvidia.com หรือ NIM ที่โฮสต์เอง ค่าตั้งต้นใน .env.example ตาม README คือ nvidia/nemotron-3-nano-30b-a3b สำหรับ LLM, nvidia/nemotron-3-embed-1b สำหรับ embedding และ nvidia/llama-nemotron-rerank-vl-1b-v2 สำหรับจัดอันดับผลค้นคืน ต้องมี NVIDIA API key รูปแบบ nvapi จากแคตตาล็อกดังกล่าวสำหรับงานแชตและการนำเข้าข้อมูล
ผู้ติดตั้งใช้ Docker Compose v2 สำหรับชุดในเครื่อง หรือ Helm chart บน Kubernetes และต้องมีรายละเอียดการเชื่อมต่อฐานข้อมูลต้นทางที่ README ระบุว่าเป็น Databricks, Postgres, Snowflake หรือ DuckDB
ข้อควรระวังด้านความปลอดภัยที่ README บอกไว้
ส่วน Connections Management ของ README ระบุว่า ถ้าเพิ่มการเชื่อมต่อฐานข้อมูลผ่านหน้าเว็บโดยไม่ได้ตั้ง Vault ข้อมูลการเชื่อมต่อทั้งชุด รวมรหัสผ่าน จะถูกเก็บแบบไม่เข้ารหัสในแถวฐานข้อมูลของแค็ตตาล็อก Vault ปิดอยู่เป็นค่าตั้งต้น และถ้าตั้งค่าไม่ครบ ระบบเตือนแล้วกลับไปเก็บแบบข้อความธรรมดา
ข้อควรรู้อื่นจาก README
- รองรับ SSO ผ่าน IdP โดยตั้ง Redirect URI เป็น
APP_URL/api/auth/sso/callback - ผู้ใช้สร้าง API token สำหรับสคริปต์ได้ ระบบเก็บเฉพาะค่าแฮช SHA-256 และโทเคนทำงานตามสิทธิ์ของเจ้าของ
- พอร์ต FastAPI เป็นขอบเขตบริการภายในที่เชื่อถือกัน ต้องไม่เปิดสู่สาธารณะ เพราะ header ระบุตัวผู้ใช้ไม่ได้ถูก FastAPI ตรวจซ้ำ
วัดผลแบบไหน และสถานะของโปรเจกต์
README ชี้ไปที่ที่เก็บ ontology-sql-eval สำหรับรันเบนช์มาร์ก text-to-SQL เช่น BIRD ชุดทดสอบนี้เทียบ 2 แบบ คือ LLM ที่เห็นเพียงสคีมา กับ agent ที่ใช้ ontology แล้วรายงานผลต่างเป็นตัวเลขเดียว โดยตรวจด้วยการเทียบผลการรันแบบกำหนดแน่นอน ไม่ใช้ LLM เป็นผู้ตัดสิน เรายังไม่ได้เปิดอ่านผลเบนช์มาร์กที่ NVIDIA เผยแพร่ จึงไม่รายงานตัวเลขความแม่นยำใด ๆ
ข้อจำกัดที่ README ระบุชัดคือโปรเจกต์ "ยังไม่รับ contribution จากภายนอก" แม้เป็นโอเพนซอร์สสัญญา Apache-2.0 องค์กรที่ต้องการแก้โค้ดจึงต้องฟอร์กเอง
ทำไมเรื่องนี้สำคัญ
องค์กรที่เริ่มให้ AI agent ถามฐานข้อมูลจริงมักเจอปัญหาเดียวกัน คือชื่อคอลัมน์ไม่บอกความหมาย และเมตริกเดียวกันนิยามต่างกันในแต่ละระบบ แนวทางของ NVIDIA Auto Ontology คือเก็บความหมายและสายข้อมูลไว้ในชั้นกลางที่ตรวจสอบได้ แทนการหวังให้โมเดลเดาจากชื่อตาราง ซึ่งเป็นทิศเดียวกับที่ผู้ขายข้อมูลรายอื่นทำ เช่น Oracle ที่เพิ่ม semantic layer ใน Autonomous AI Lakehouse และ Dell AI Data Platform ที่เพิ่ม knowledge graph
ผลต่อองค์กรไทย
- ลองใน sandbox ก่อน ใช้ชุดข้อมูลตัวอย่างหรือสำเนาที่ไม่มีข้อมูลส่วนบุคคล เพราะซอฟต์แวร์ใหม่ที่เชื่อมฐานข้อมูลจริงควรผ่านการทดสอบสิทธิ์และ log ก่อน
- ตั้ง Vault ก่อนเพิ่มการเชื่อมต่อ ตามที่ README เตือนเรื่องรหัสผ่านแบบข้อความธรรมดา และใช้บัญชีฐานข้อมูลแบบอ่านอย่างเดียว ข้อหลังเป็นข้อแนะนำทั่วไปของเรา ไม่ใช่ข้อความใน README
- ถามเรื่องที่ตั้งการประมวลผล ค่าตั้งต้นเรียก NIM ที่โฮสต์โดย NVIDIA ถ้าข้อมูลมีส่วนบุคคลตาม PDPA ควรพิจารณา NIM ที่โฮสต์เองและทบทวนว่าข้อมูลใดถูกส่งออกไปเป็น prompt
- เริ่มจากนิยามเมตริกกลาง ไม่ว่าจะใช้ไลบรารีนี้หรือไม่ การตกลงนิยามรายได้ ลูกค้า และคำสั่งซื้อให้ตรงกันคือส่วนที่ต้องทำเอง
- ติดตามสถานะโปรเจกต์ เพราะยังไม่รับ contribution จากภายนอก ตรวจประวัติ commit และไฟล์ THIRD_PARTY_NOTICES.md ก่อนนำไปใช้
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
องค์กรไทยที่เริ่มให้ AI agent เข้าถึงฐานข้อมูลจริงต้องตัดสินใจว่าข้อมูลและงานประมวลผลจะอยู่ที่ใด Private Cloud ไทยบน Proxmox VE ของ THAI DATA CLOUD เก็บข้อมูลไว้ในประเทศ รองรับ PDPA และมีทีมวิศวกรไทยดูแล 24/7 (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
ติดตามข่าวข้อมูลและฐานข้อมูลอื่น ๆ ได้ที่หมวด Data
ภาพบันทึก
คำถามที่พบบ่อย
NVIDIA Auto Ontology คืออะไร?
NVIDIA Auto Ontology คือไลบรารีโอเพนซอร์สของ NVIDIA ที่สร้างชั้น semantic หรือ ontology จากเมทาดาทาของข้อมูลองค์กร เพื่อบอก AI agent ว่าข้อมูลอยู่ที่ไหน มีความหมายอย่างไร และใช้อย่างไร แล้วเปิดให้เรียกใช้ผ่าน MCP, CLI และ API
NVIDIA Auto Ontology ใช้สัญญาอนุญาตอะไร?
README ระบุว่า NVIDIA Auto Ontology เผยแพร่ภายใต้ Apache License 2.0 ส่วนส่วนประกอบของบุคคลที่สามที่ใช้ในโปรเจกต์ระบุไว้ในไฟล์ THIRD_PARTY_NOTICES.md และโปรเจกต์ยังไม่รับ contribution จากภายนอก ณ วันที่เราตรวจ
NVIDIA Auto Ontology เชื่อมกับฐานข้อมูลอะไรได้บ้าง?
README ระบุแหล่งข้อมูลที่ต้องเตรียมคือ Databricks, Postgres, Snowflake หรือ DuckDB ตัวโปรเจกต์เองใช้ Postgres ที่มี pgvector เก็บแค็ตตาล็อก ontology และเวกเตอร์ และรันได้ด้วย Docker Compose หรือ Helm chart บน Kubernetes
ใช้ NVIDIA Auto Ontology ต้องมีอะไรบ้าง?
ต้องมี Docker กับ Docker Compose v2 สำหรับชุดทดลองในเครื่อง NVIDIA API key สำหรับเรียกโมเดลผ่าน NIM และรายละเอียดการเชื่อมต่อฐานข้อมูลต้นทาง ถ้าติดตั้งบน Kubernetes ให้ดูไฟล์ DEPLOYMENT.md ของโปรเจกต์
แหล่งอ้างอิง
- NVIDIA/auto-ontology — NVIDIA (GitHub)
- NVIDIA/ontology-sql-eval — NVIDIA (GitHub)
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- NVIDIA126GitHub91Databricks18Snowflake12HashiCorp2
- ผลิตภัณฑ์และเทคโนโลยี
- Model Context Protocol33Next.js5DuckDB4Docker46Kubernetes39TypeScript7Python40Proxmox VE20
- กฎหมายและมาตรฐาน
- PDPA253
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ