
NVIDIA เปิดโมเดล NVIDIA Kumo พยากรณ์จากฐานข้อมูลไม่ต้องเทรน ใช้ใน Snowflake และ Databricks
NVIDIA เปิดโมเดล NVIDIA Kumo แบบ open weight 21 ต.ค. 2026 พยากรณ์ churn ทุจริต และยอดขายจากตารางฐานข้อมูลโดยไม่ต้องเทรนต่อโจทย์ ใช้ใน Snowflake และ Databricks
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
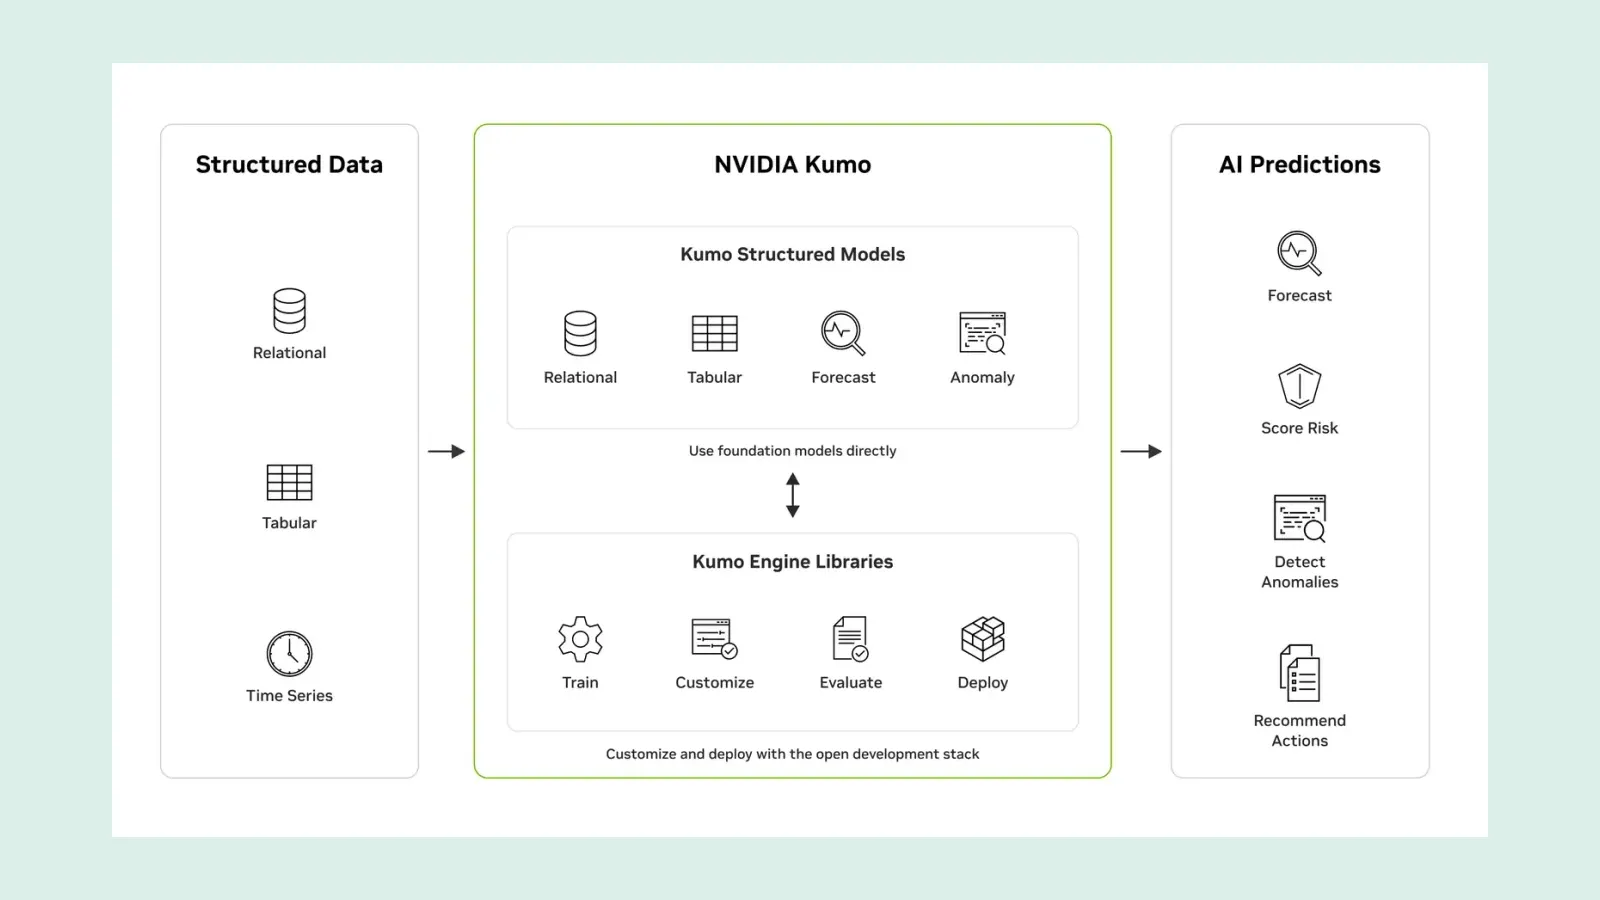
- NVIDIA เปิดโมเดล NVIDIA Kumo เมื่อ 21 ตุลาคม 2026 ในงาน GTC Berlin เป็นตระกูลโมเดลแบบ open weight สำหรับข้อมูลเชิงโครงสร้าง 4 ตัว คือ Kumo Relational, Kumo Tabular, Kumo Forecast และ Kumo Anomaly
- Kumo Relational อ่านตัวอย่างในอดีตได้สูงสุด 10,000 รายการเป็นบริบท แล้วพยากรณ์ เช่น ลูกค้าเลิกใช้ ยอดขาย หรือการทุจริต ในการประมวลผลรอบเดียว โดยไม่ต้องเทรนโมเดลแยกต่อโจทย์และไม่ต้องทำ feature engineering
- ผลทดสอบที่ NVIDIA เผยแพร่: ชนะโมเดล supervised ใน 41 งานจาก 15 ฐานข้อมูล และบน SAP SALT ทำคะแนน MRR สูงกว่า AutoGluon 8% หรือ 16% เมื่อ fine-tune รองรับฐานข้อมูลขนาด 500,000 ล้านแถวขึ้นไป
- ลูกค้า Snowflake รันโมเดล NVIDIA Kumo (Kumo Relational และ Kumo Engine) ใน Snowflake Notebooks บน GPU ได้โดยข้อมูลไม่ออกนอกบัญชี ส่วน Databricks ใช้ Kumo Anomaly คู่กับ Genie Ontology
- โค้ดใช้สัญญาอนุญาต Apache 2.0 ส่วนน้ำหนักโมเดลใช้ OpenMDW 1.1 ดาวน์โหลดได้จาก Hugging Face หรือใช้ผ่าน NVIDIA NIM
NVIDIA เปิดโมเดล NVIDIA Kumo เมื่อวันที่ 21 ตุลาคม 2026 ในงาน GTC Berlin เป็นโมเดลแบบ open weight 4 ตัวที่พยากรณ์จากข้อมูลในตารางฐานข้อมูลโดยตรง เช่น ลูกค้ารายไหนจะเลิกใช้ ธุรกรรมไหนเสี่ยงทุจริต หรือยอดขายสัปดาห์หน้าจะเป็นเท่าไร โดยไม่ต้องเทรนโมเดลแยกต่อโจทย์ และรันได้ใน Snowflake กับ Databricks
ทุกวันนี้งาน machine learning บนข้อมูลธุรกิจยังต้องทำซ้ำทุกโจทย์ ตั้งแต่เตรียมข้อมูล รวมหลายตารางเป็นตารางเดียว สร้างฟีเจอร์ เทรนและจูนโมเดล ไปจนถึงวางระบบใช้งาน NVIDIA บอกว่า Kumo ย้ายงานที่ทำซ้ำเหล่านี้ไปไว้ในโมเดลพื้นฐาน (foundation model) ที่เทรนไว้ล่วงหน้าสำหรับข้อมูลเชิงโครงสร้างโดยเฉพาะ
โมเดล NVIDIA Kumo มีอะไรบ้าง
| โมเดล | ใช้กับข้อมูลแบบไหน | ตัวอย่างงาน |
|---|---|---|
| Kumo Relational | หลายตารางที่เชื่อมกันด้วย key | ลูกค้าเลิกใช้ (churn) การทุจริต ยอดซื้อซ้ำ |
| Kumo Tabular | ตารางเดียว | จำแนกประเภทหรือพยากรณ์ตัวเลขพร้อมค่าความไม่แน่นอน มีขนาดเล็ก กลาง ใหญ่ |
| Kumo Forecast | อนุกรมเวลา | วางแผนความต้องการสินค้า วางแผนกำลังการผลิต |
| Kumo Anomaly | อนุกรมเวลา | ตรวจความผิดปกติในงานปฏิบัติการ โรงงาน และโครงสร้างพื้นฐาน |
นอกจากโมเดล ยังมี Kumo Engine ซึ่งเป็นไลบรารีโอเพนซอร์สสำหรับเทรน ปรับแต่ง ประเมิน และนำโมเดลไปใช้ ติดตั้งด้วย pip install kumo-engine และมีตัวเลือกสำหรับ Snowflake กับ Databricks ทั้งหมดอยู่ใน NVIDIA Agent Knowledge Foundation ชุดเครื่องมือที่ช่วยให้ AI agent ใช้ข้อมูลขององค์กรได้ ร่วมกับไลบรารี CUDA-X อย่าง cuDF, cuGraph, cuML, cuOpt, cuVS และไลบรารีใหม่ Auto-Ontology ที่แปลงข้อมูลดิบเป็นแนวคิดทางธุรกิจ เช่น ลูกค้า สินค้า และคำสั่งซื้อ
Kumo Relational ทำงานอย่างไร
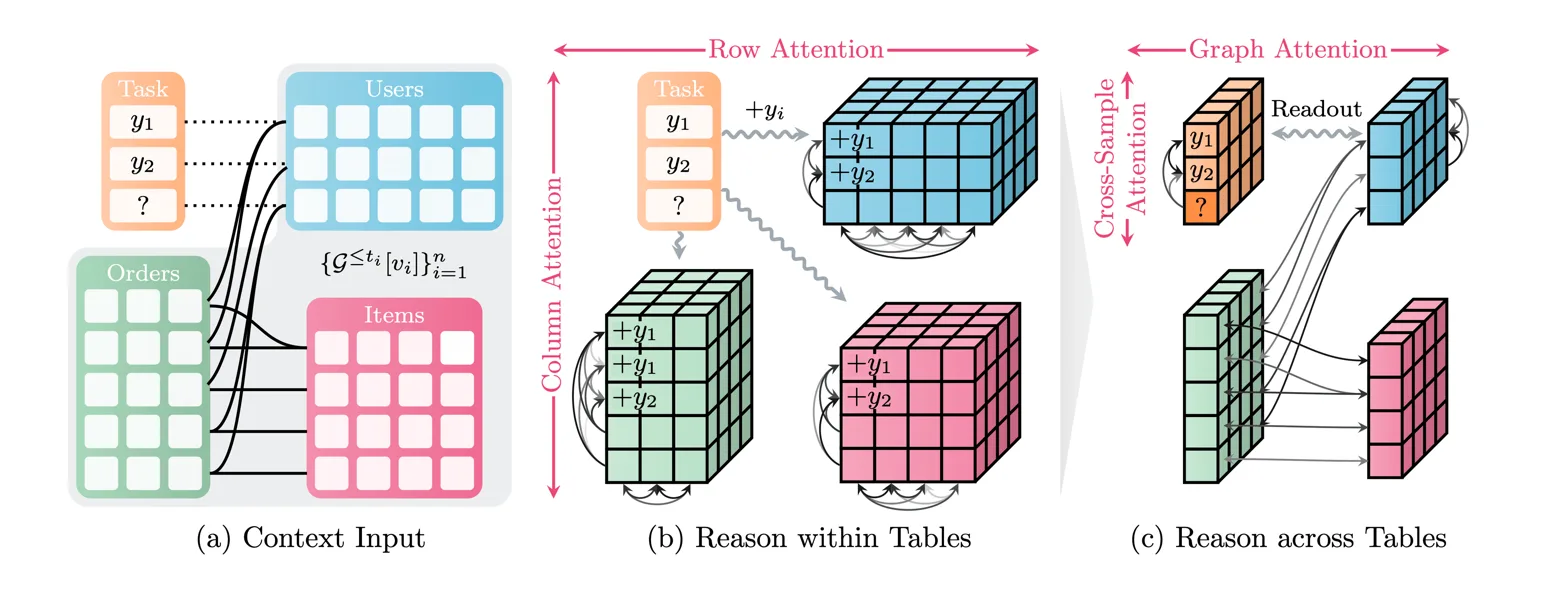
Kumo Relational เป็นตัวหลักของโมเดล NVIDIA Kumo ต่างจากโมเดลตารางทั่วไปที่ต้องรวมข้อมูลให้เป็นตารางกว้างตารางเดียว ตัวโมเดลอ่านตาราง foreign key และ timestamp จากฐานข้อมูลตรง ๆ ผู้ใช้เขียนโจทย์ด้วย Predictive Query Language (PQL) เช่น "นับคำสั่งซื้อใน 30 วันข้างหน้าของผู้ใช้แต่ละคน" แล้วระบบดึงตัวอย่างในอดีตสูงสุด 10,000 รายการมาเป็นบริบท (in-context learning) และตอบในการประมวลผลรอบเดียว
- เทรนล่วงหน้าด้วยฐานข้อมูลสังเคราะห์ทั้งหมด ไม่ได้ใช้ข้อมูลจริงของลูกค้า และหน้าโมเดลระบุว่าพัฒนาต่อจาก KumoRFM-2
- ย้อนสร้างสถานะฐานข้อมูล ณ จุดเวลาในอดีต เพื่อไม่ให้ข้อมูลอนาคตรั่วเข้าไปในการพยากรณ์ (data leakage)
- รองรับฐานข้อมูลขนาด 500,000 ล้านแถวขึ้นไป ผ่านเอนจินกราฟที่อ่านข้อมูลได้สูงสุด 5 GB/s
- fine-tune ต่อด้วยข้อมูลของตัวเองได้เมื่อต้องการความแม่นยำสูงสุด
ผลทดสอบที่ NVIDIA เปิดเผย
บล็อกและงานวิจัยของทีม NVIDIA ทดสอบ Kumo Relational กับ 41 งานจาก 15 ฐานข้อมูลใน RelBench V1/V2, SAP SALT และ 4DBInfer ซึ่งไม่มีชุดใดอยู่ในข้อมูลเทรน ผลที่รายงานไว้มีดังนี้
| ชุดทดสอบ | ผลของ Kumo Relational |
|---|---|
| RelBench V1 (classification) | สูงกว่า gradient-boosted trees ที่ผู้เชี่ยวชาญทำฟีเจอร์ไว้เกือบ 4 คะแนน AUROC โดยเฉลี่ย |
| SAP SALT เทียบ XGBoost | สูงกว่า 7 คะแนน MRR ทันที และ 13 คะแนนหลัง fine-tune |
| SAP SALT เทียบ AutoGluon | MRR สูงกว่า 8% และ 16% หลัง fine-tune |
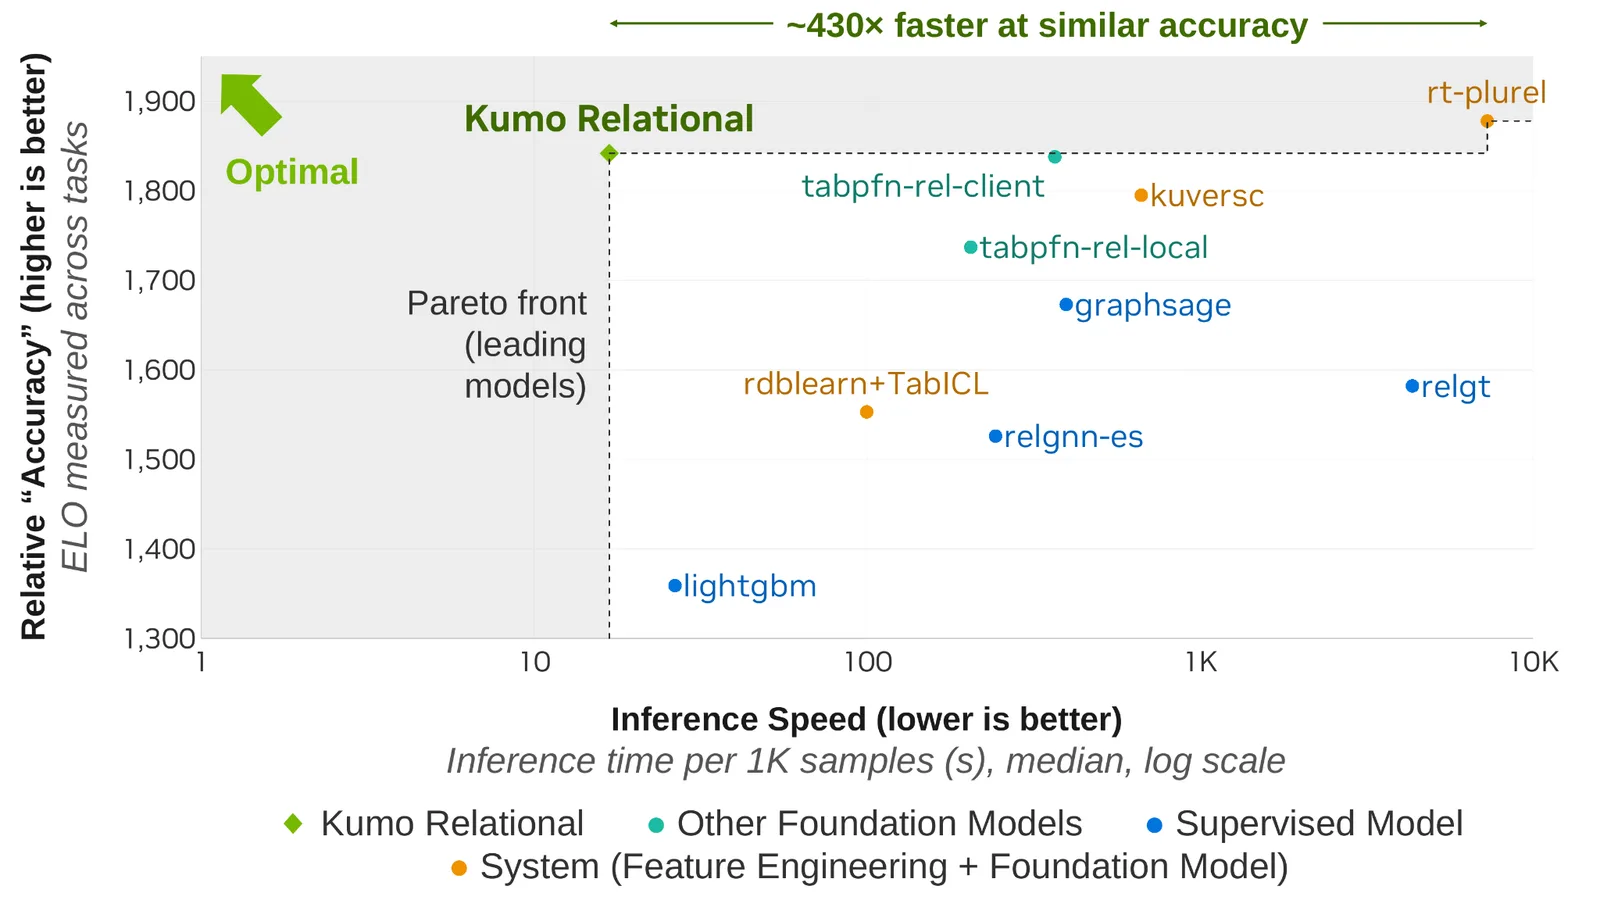
| RelArena-α | Elo 1,842 ใช้เวลาราว 17 วินาทีต่อ 1,000 ตัวอย่าง เร็วกว่าอันดับหนึ่ง (Elo 1,878) ราว 430 เท่า |
ทีมผู้พัฒนาระบุข้อจำกัดไว้เองว่า โมเดลทำได้ดีที่สุดกับข้อมูลที่มีความสัมพันธ์และการเปลี่ยนแปลงตามเวลาชัดเจน เช่น พฤติกรรมผู้ใช้ งานที่มีข้อมูลเทรนจำนวนมากโมเดล supervised เฉพาะงานอาจยังแม่นกว่าเล็กน้อย และสัญญาณที่ใช้พยากรณ์ต้องอยู่ห่างกันไม่กี่ตาราง จึงควรเริ่มจากโจทย์แคบ ๆ ไม่กี่ตารางก่อน
ใช้โมเดล NVIDIA Kumo กับ Snowflake และ Databricks อย่างไร
บล็อกของ Snowflake ระบุว่าลูกค้าติดตั้งแพ็กเกจ Kumo ใน Snowflake Notebooks บน Container Runtime ที่ใช้ GPU ของ NVIDIA ผ่าน compute pool แล้วอ่านตาราง เทรน และเขียนผลพยากรณ์กลับเข้าตาราง Snowflake โดยข้อมูลไม่ออกนอกบัญชีและอยู่ภายใต้การควบคุมสิทธิ์เดิม ลูกค้าที่ใช้อยู่แล้วมี Affirm, NOV, VideoAmp และ Yieldmo ฝั่ง Databricks ใช้ Kumo Anomaly คู่กับ Genie Ontology และ NVIDIA ระบุว่า Cognite, Coinbase, DoorDash, Revolut และ Tubi เป็นกลุ่มแรกที่ทดลองใช้
Vanja Josifovski รองประธานฝ่าย Graph Engineering ของ NVIDIA กล่าวในบล็อกของ Snowflake ว่า ข้อมูลองค์กรเป็นข้อมูลเชิงความสัมพันธ์โดยธรรมชาติ และการพยากรณ์ที่แม่นที่สุดมาจากการเรียนรู้บนโครงสร้างนั้นโดยตรง แทนการทิ้งโครงสร้างไป
ทำไมเรื่องนี้สำคัญ
LLM ทำให้ AI agent อ่าน เขียน และให้เหตุผลได้ แต่การพยากรณ์จากตัวเลขในฐานข้อมูลยังพึ่งโมเดลแบบเดิมที่ต้องสร้างทีละงาน โมเดล NVIDIA Kumo ทำให้คำถามเชิงพยากรณ์กลายเป็นคำสั่ง query หนึ่งบรรทัด ทั้งทีมข้อมูลและ agent เรียกใช้ได้ และการที่ Snowflake กับ Databricks รองรับตั้งแต่วันแรกทำให้องค์กรไม่ต้องย้ายข้อมูลออกจากแพลตฟอร์มเดิม
ผลต่อองค์กรไทย
- เลือกโจทย์ที่ข้อมูลพร้อม ธนาคาร ค้าปลีก และโทรคมนาคมที่มีตารางลูกค้า ธุรกรรม และคำสั่งซื้อเชื่อมกันอยู่แล้ว ลองเทียบโมเดล NVIDIA Kumo กับโมเดล churn หรือ fraud ที่ใช้อยู่ โดยใช้ชุดข้อมูลทดสอบเดียวกัน
- คำนวณต้นทุน GPU ตัวอย่างโค้ดของโมเดล NVIDIA Kumo รันบน GPU ทั้งหมด องค์กรที่ใช้ Snowflake หรือ Databricks ควรประเมินค่า compute pool แบบ GPU ก่อนขยายผล
- ข้อมูลอยู่ในที่เดิมช่วยเรื่อง PDPA การเทรนและพยากรณ์ภายในบัญชี Snowflake หรือรันน้ำหนักโมเดลบนเครื่องของตัวเอง ทำให้ข้อมูลส่วนบุคคลไม่ต้องส่งออกไปภายนอก แต่ยังต้องบันทึกวัตถุประสงค์การประมวลผลตามเดิม
- อ่านสัญญาอนุญาตของน้ำหนักโมเดล โค้ดใช้ Apache 2.0 แต่น้ำหนักใช้ OpenMDW 1.1 ซึ่งฝ่ายกฎหมายควรตรวจก่อนใช้ในระบบที่ให้บริการลูกค้า
- ตรวจผลก่อนใช้ตัดสินใจกับลูกค้า โดยเฉพาะการปฏิเสธสินเชื่อหรือบล็อกธุรกรรม ควรมีคนทบทวนและบันทึกเหตุผลได้
ติดตามข่าวฐานข้อมูลและแพลตฟอร์มข้อมูลได้ที่หมวด ข้อมูลและฐานข้อมูล
คำถามที่พบบ่อย
โมเดล NVIDIA Kumo คืออะไร?
โมเดล NVIDIA Kumo คือตระกูลโมเดลแบบ open weight ที่ NVIDIA เปิดเมื่อ 21 ตุลาคม 2026 สำหรับพยากรณ์จากข้อมูลเชิงโครงสร้าง ทั้งตารางเดี่ยว หลายตารางที่เชื่อมกัน และอนุกรมเวลา ใช้พยากรณ์ผล ให้คะแนนความเสี่ยง ตรวจความผิดปกติ และแนะนำการกระทำ โดยไม่ต้องสร้างโมเดลแยกทุกโจทย์
Kumo Relational ต่างจาก XGBoost อย่างไร?
XGBoost ต้องรวมหลายตารางให้เป็นตารางเดียวและทำ feature engineering ก่อนเทรนทุกโจทย์ ส่วน Kumo Relational ในชุดโมเดล NVIDIA Kumo อ่านตาราง foreign key และ timestamp จากฐานข้อมูลโดยตรง แล้วใช้ตัวอย่างในอดีตสูงสุด 10,000 รายการเป็นบริบท NVIDIA รายงานว่าบน SAP SALT ชนะ XGBoost ที่ทำฟีเจอร์ไว้ 7 คะแนน MRR และ 13 คะแนนหลัง fine-tune
ใช้โมเดล NVIDIA Kumo กับ Snowflake หรือ Databricks ได้ไหม?
ได้ ลูกค้า Snowflake ติดตั้งแพ็กเกจของโมเดล NVIDIA Kumo ใน Snowflake Notebooks บน Container Runtime ที่มี GPU แล้วเทรนและเขียนผลพยากรณ์กลับเข้าตาราง Snowflake โดยข้อมูลไม่ออกนอกบัญชี ส่วน Kumo Engine มีตัวติดตั้งสำหรับ Databricks Notebook และ Databricks ใช้ Kumo Anomaly คู่กับ Genie Ontology
โมเดล NVIDIA Kumo ใช้เชิงพาณิชย์ได้หรือไม่?
หน้าโมเดลบน Hugging Face ระบุว่าโค้ดเผยแพร่ภายใต้ Apache 2.0 และน้ำหนักของโมเดล NVIDIA Kumo ภายใต้ OpenMDW License Agreement เวอร์ชัน 1.1 องค์กรดาวน์โหลดไปรันบน GPU ของตัวเองหรือใช้ผ่าน NVIDIA NIM ได้ แต่ควรให้ฝ่ายกฎหมายอ่านเงื่อนไขสัญญาอนุญาตก่อนใช้ในระบบจริง
แหล่งอ้างอิง
- Kumo: Open Models for Structured Data — NVIDIA Developer
- NVIDIA Agent Toolkit Expands, Grounding Enterprise Agents in Company Data — NVIDIA
- NVIDIA Open Models Advance Europe’s Sovereign Intelligence Across Industries — NVIDIA
- NVIDIA Kumo Relational Outperforms Supervised Machine Learning on Relational Data, No Training Required — NVIDIA (Hugging Face Blog)
- Kumo-Relational model card — NVIDIA (Hugging Face)
- Scaling Graph ML with NVIDIA Kumo on Snowflake — Snowflake
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- NVIDIA53Snowflake9Databricks13SAP12Hugging Face10Revolut2
- กฎหมายและมาตรฐาน
- PDPA132
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ