
HBM คืออะไร? หน่วยความจำซ้อนชั้นที่ GPU สำหรับ AI ต้องใช้ ตั้งแต่ HBM2E ถึง HBM4E
HBM คือ DRAM ที่ซ้อนชิปหลายชั้นด้วย TSV วางชิด GPU บนบัสกว้าง 1,024–2,048 บิต ส่งข้อมูลได้หลาย TB/s ต่อ stack อธิบายแต่ละรุ่น ชิปที่ใช้ และเหตุที่ขาดตลาด
โดย กองบรรณาธิการ THAI DATA อ่าน 10 นาที ผู้เข้าชม 1

สรุปประเด็นสำคัญ
- HBM (High Bandwidth Memory) คือ DRAM ที่ซ้อนชิปเป็นชั้นและเชื่อมกันด้วย TSV วางชิดชิปประมวลผลบน silicon interposer บัสข้อมูลของ HBM หนึ่ง stack กว้าง 1,024 บิต หรือ 16 เท่าของ DDR5 module มาตรฐานตามที่ Micron ระบุ และ HBM4 ขยายเป็น 2,048 บิต
- มาตรฐาน HBM4 (JESD270-4) ที่ JEDEC ประกาศเมื่อ 16 เมษายน 2025 กำหนดความเร็ว 8 Gb/s ต่อขา แบนด์วิดท์สูงสุด 2 TB/s ต่อ stack และซ้อนได้ 16 ชั้น ความจุ 64 GB ส่วนสินค้าจริงของ Samsung ทำได้ถึง 3.3 TB/s
- HBM4E อยู่ในขั้นส่งตัวอย่าง SK hynix ส่งตัวอย่างแบบ 12 ชั้น ความจุ 48 GB ความเร็ว 16 Gbps ต่อขาเมื่อ 18 มิถุนายน 2026 และ Samsung ระบุสเปกสูงสุด 64 GB กับ 4 TB/s ต่อ stack
- GPU ที่ใช้ HBM4 อย่าง NVIDIA Rubin (288 GB, 19.2 TB/s) และ AMD Instinct MI455X (432 GB, 23.3 TB/s) มีแบนด์วิดท์หน่วยความจำราว 9–11 เท่าของ NVIDIA A100 ที่ใช้ HBM2e
- SK hynix ระบุในผลประกอบการไตรมาส 2/2026 ว่าความต้องการของลูกค้าสูงกว่ากำลังผลิต ราคา DRAM และ NAND ขึ้นมากจากไตรมาสก่อน และได้ทำสัญญาระยะยาวกับลูกค้าราว 10 ราย
HBM (High Bandwidth Memory) คือหน่วยความจำ DRAM ที่นำชิปหลายชั้นมาซ้อนกันในแนวตั้ง เชื่อมแต่ละชั้นด้วย TSV แล้ววางไว้ชิด GPU หรือชิป AI ในแพ็กเกจเดียวกัน บัสข้อมูลกว้าง 1,024–2,048 บิตต่อ stack ทำให้ส่งข้อมูลได้ถึงระดับ TB/s ต่อ stack มาตรฐานล่าสุดคือ HBM4 ที่ JEDEC ประกาศเมื่อ 16 เมษายน 2025 และเป็นหน่วยความจำหลักของตัวเร่ง AI ระดับดาต้าเซ็นเตอร์ของ NVIDIA และ AMD
บทความนี้อธิบายว่า HBM ทำงานอย่างไร แต่ละรุ่นต่างกันแค่ไหน ชิปรุ่นใดใช้ HBM รุ่นใด เหตุที่ HBM ขาดตลาดจนดันราคาหน่วยความจำทั้งตลาด และสิ่งที่องค์กรไทยควรดูก่อนซื้อเซิร์ฟเวอร์ AI หรือเช่า GPU Cloud ตัวเลขทุกตัวมาจากหน้ามาตรฐานของ JEDEC และหน้าผลิตภัณฑ์หรือห้องข่าวของผู้ผลิต ณ วันที่ 8 ตุลาคม 2026
HBM ทำงานอย่างไร
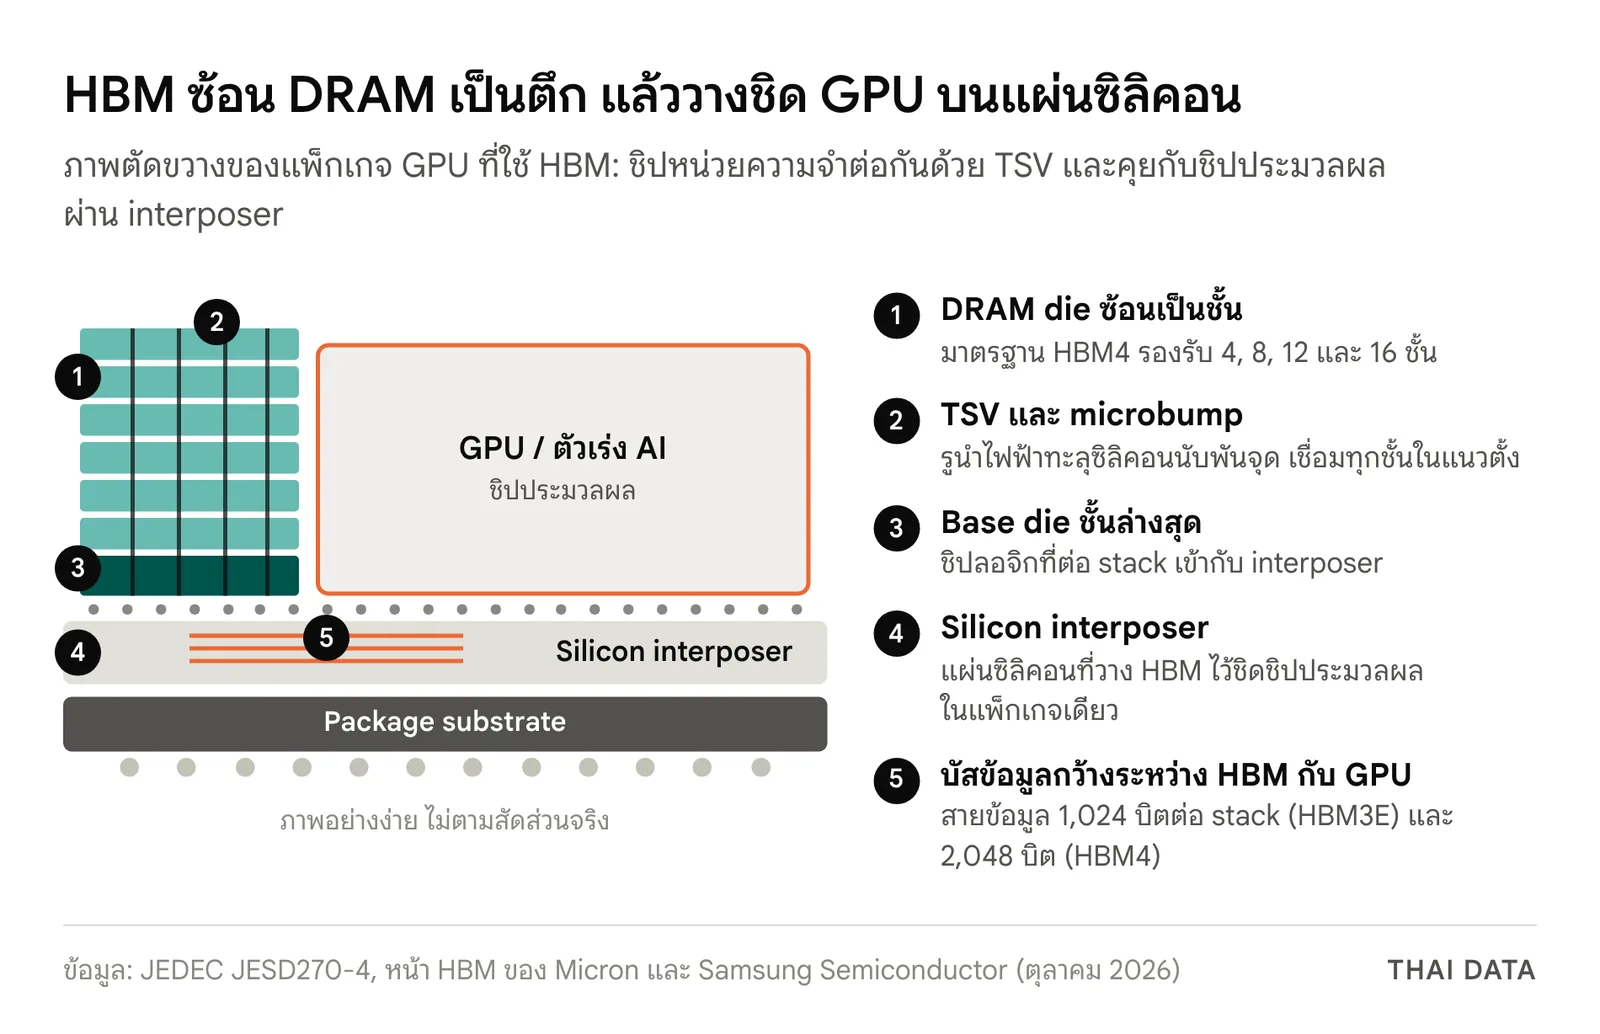
Micron อธิบายว่า HBM เป็น DRAM แบบซ้อนสามมิติ แทนที่จะวางชิปหน่วยความจำเรียงบนแผงวงจร ผู้ผลิตนำ DRAM die หลายแผ่นมาซ้อนกันบน base die (ชั้นฐาน) แล้วเชื่อมทุกชั้นด้วย TSV (through-silicon via) และ microbump นับพันจุด SK hynix นิยาม TSV ว่าเป็นช่องทางรูปเสาที่เจาะทะลุความหนาของซิลิคอน ใช้ส่งข้อมูล คำสั่ง และกระแสไฟระหว่างชิปชั้นบนกับชั้นล่าง
แบนด์วิดท์ของ HBM คำนวณจากความเร็วต่อขาคูณจำนวนขาข้อมูลแล้วหารด้วย 8 เพื่อแปลงบิตเป็นไบต์ SK hynix ยกตัวอย่าง HBM2E ที่ 3.6 Gbps ต่อขา กับขาข้อมูล 1,024 ขา ได้ 3,686.4 Gbps หรือ 460.8 GB/s ต่อ stack จุดแข็งของ HBM จึงอยู่ที่ความกว้าง ไม่ใช่ความเร็วต่อขา Micron ระบุว่า HBM หนึ่ง cube มีบัสข้อมูล 1,024 บิต กว้างกว่า DDR5 module มาตรฐาน 16 เท่า ขณะที่ DDR5 อาศัยบัสแคบที่วิ่งด้วยสัญญาณนาฬิกาสูงมาก
การวางตัวก็สำคัญไม่แพ้กัน HBM อยู่ในแพ็กเกจเดียวกับ CPU หรือ GPU บน silicon interposer ระยะทางที่ข้อมูลต้องวิ่งจึงสั้น Micron ระบุว่าทำให้ใช้พลังงานต่อบิตต่ำกว่า ส่วน base die ชั้นล่างสุดเป็นชิปลอจิกที่ต่อ stack เข้ากับ interposer ใน HBM4 ของ Samsung ชิปนี้ผลิตด้วยกระบวนการลอจิก 4 นาโนเมตร คู่กับ DRAM รุ่น 1c ของบริษัท
ทำไม GPU สำหรับ AI ต้องใช้ HBM
งาน AI ต้องย้ายข้อมูลปริมาณมหาศาลระหว่างหน่วยความจำกับหน่วยประมวลผล ถ้าหน่วยความจำป้อนข้อมูลไม่ทัน ชิปที่แรงแค่ไหนก็ต้องรอ Micron สรุปว่าข้อได้เปรียบใหญ่ที่สุดของ HBM คือทำให้ชิปประมวลผลทำงานต่อเนื่องแทนที่จะนั่งรอข้อมูล
โมเดลภาษาขนาดใหญ่เห็นผลชัดที่สุด เพราะระหว่างสร้างคำตอบ โมเดลต้องอ่านน้ำหนัก (parameters) จากหน่วยความจำซ้ำแล้วซ้ำอีก SK hynix ยกตัวอย่างว่า GPU หนึ่งตัวที่ติด HBM3E แบบ 12 ชั้นสี่ stack อ่านพารามิเตอร์ทั้ง 70,000 ล้านตัวของ Llama 3 70B ได้ 35 รอบในหนึ่งวินาที แบนด์วิดท์จึงเป็นตัวกำหนดสำคัญของความเร็วในการตอบ
ความจุก็สำคัญพอกัน โมเดล 70,000 ล้านพารามิเตอร์ที่เก็บน้ำหนักแบบ 16 บิต (2 ไบต์ต่อพารามิเตอร์) ใช้หน่วยความจำราว 140 GB สำหรับน้ำหนักอย่างเดียว ยังไม่รวม KV cache ที่โตตามความยาวบทสนทนา AMD ระบุว่า HBM4 ขนาด 432 GB บน MI455X ช่วยให้โมเดลที่ใหญ่ขึ้น รวมทั้ง KV cache และ activation อยู่ในหน่วยความจำของ GPU ได้ ส่วน NVIDIA ระบุว่า H200 ซึ่งเป็น GPU รุ่นแรกที่ใช้ HBM3E มีหน่วยความจำ 141 GB เกือบสองเท่าของ H100 และแบนด์วิดท์มากกว่า 1.4 เท่า หน่วยความจำที่ใหญ่และเร็วขึ้นนี้ช่วยเร่งทั้งงาน Generative AI, LLM และงานคำนวณทางวิทยาศาสตร์ (HPC)
HBM แต่ละรุ่นต่างกันอย่างไร ตั้งแต่ HBM2E ถึง HBM4E
ตารางนี้รวมสเปกต่อ stack จากมาตรฐานของ JEDEC และจากผู้ผลิต รุ่นที่มีตัว E ต่อท้ายเป็นรุ่นต่อยอดที่ผู้ผลิตประกาศสเปกเอง ตัวเลขของรุ่นเหล่านี้จึงมาจากผู้ผลิต
| รุ่น | ความเร็วต่อขา | บัสต่อ stack | แบนด์วิดท์ต่อ stack | ความจุต่อ stack | อ้างอิง |
|---|---|---|---|---|---|
| HBM2E | 3.6 Gbps | 1,024 บิต | 460 GB/s | 16 GB (8 ชั้น) | SK hynix, 2020 |
| HBM3 | 6.4 Gbps | 1,024 บิต | 819 GB/s | 4–64 GB ตามมาตรฐาน | JEDEC JESD238, 2022 |
| HBM3E | 9.2–9.6 Gbps | 1,024 บิต | 1.18–1.2+ TB/s | 24–36 GB (8–12 ชั้น) | Samsung, SK hynix, Micron |
| HBM4 (มาตรฐาน) | 8 Gbps | 2,048 บิต | 2 TB/s | สูงสุด 64 GB (16 ชั้น) | JEDEC JESD270-4, 2025 |
| HBM4 (สินค้า) | 11–13 Gbps | 2,048 บิต | 2.8–3.3 TB/s | 24–36 GB (12 ชั้น) | Samsung, Micron |
| HBM4E | สูงสุด 16 Gbps | 2,048 บิต | สูงสุด 4 TB/s | 48–64 GB (12–16 ชั้น) | SK hynix, Samsung |
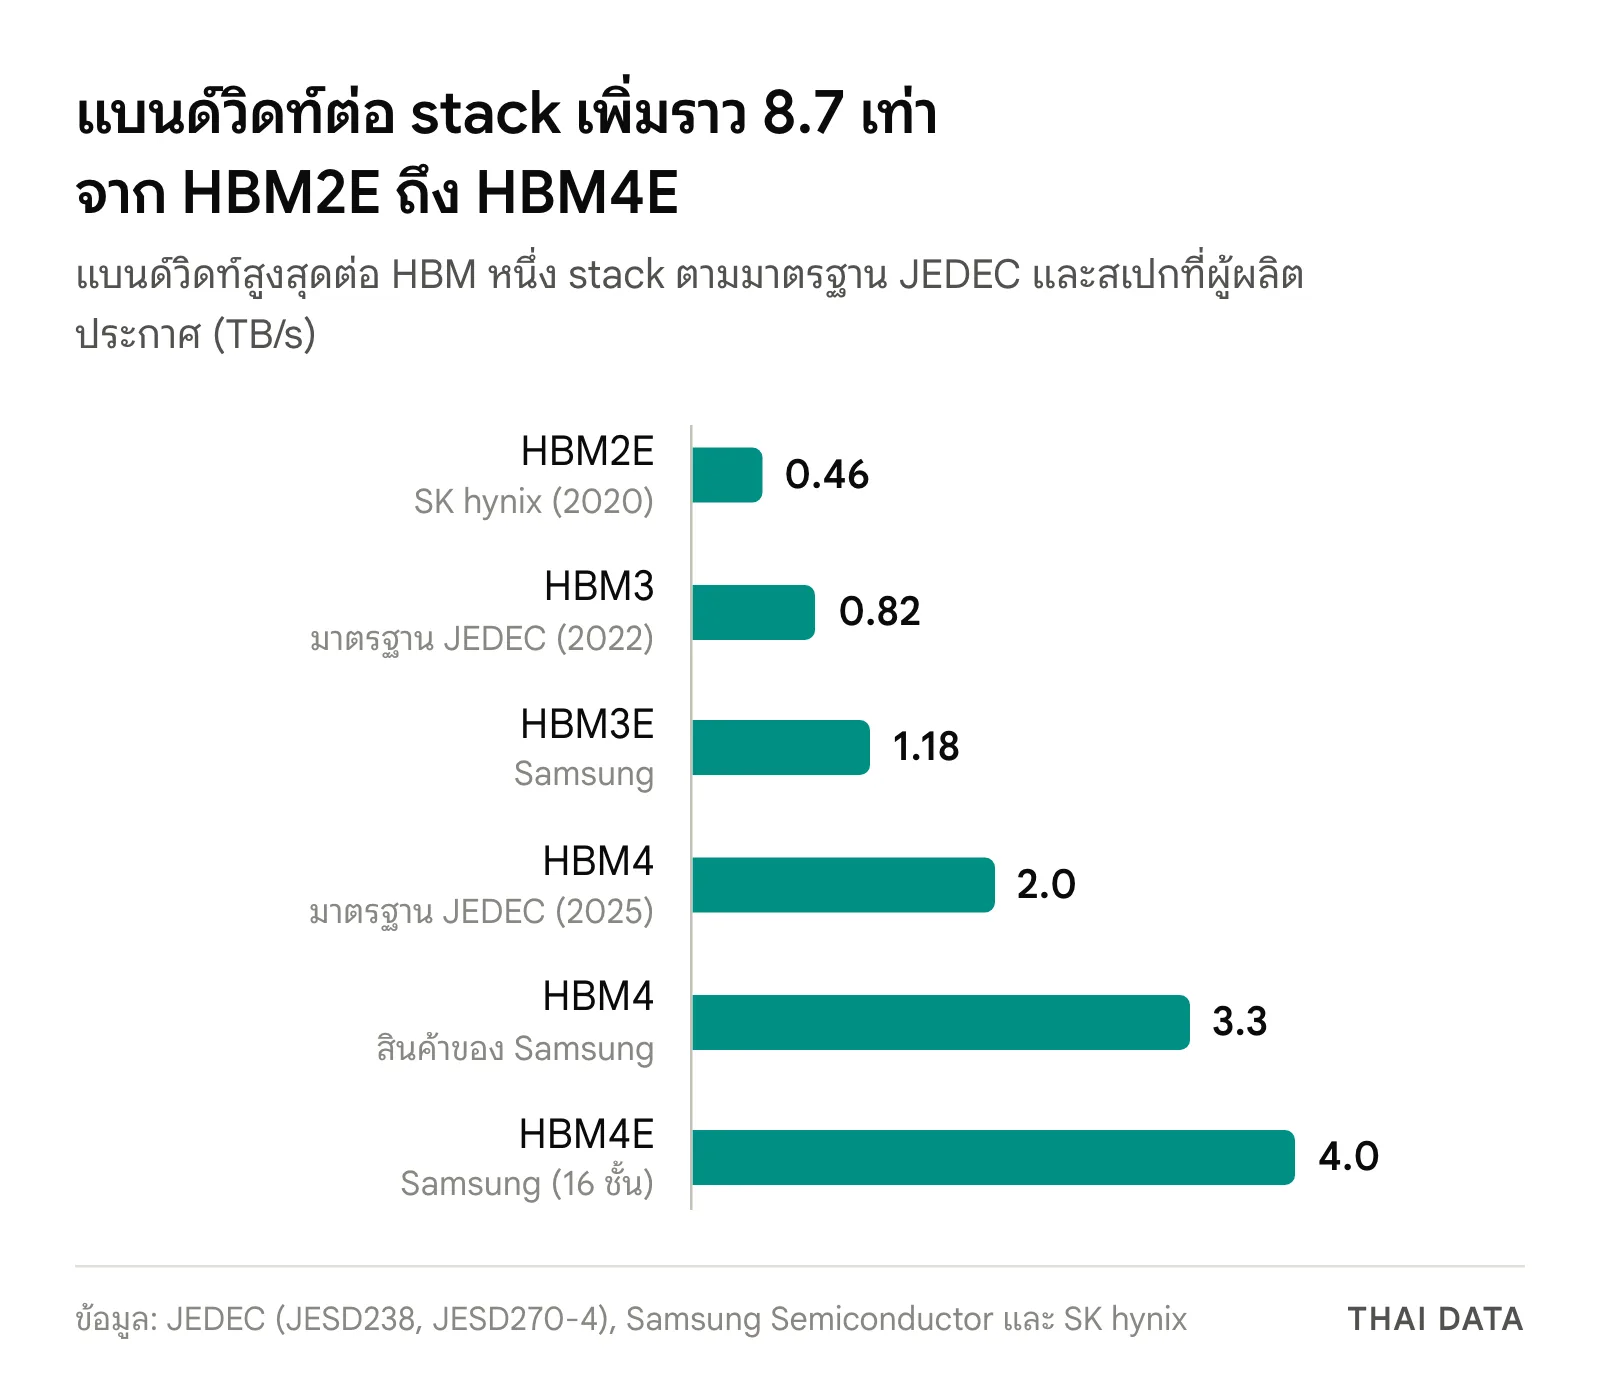
จาก HBM2E ถึง HBM4E แบนด์วิดท์ต่อ stack เพิ่มขึ้นราว 8.7 เท่า มาจากสองทาง คือความเร็วต่อขาที่เพิ่มจาก 3.6 Gbps เป็นสูงสุด 16 Gbps และการขยายบัสเป็นสองเท่าใน HBM4 ซึ่งทำให้ HBM4 ตามมาตรฐานที่ 8 Gbps ยังได้แบนด์วิดท์มากกว่า HBM3E ที่วิ่งเร็วกว่าต่อขา มาตรฐาน HBM3 ของ JEDEC ยังเพิ่มช่องสัญญาณอิสระจาก 8 เป็น 16 ช่อง และเพิ่ม ECC บนชิปเพื่อความน่าเชื่อถือในระดับแพลตฟอร์ม
HBM4 และ HBM4E เปลี่ยนอะไรบ้าง
JEDEC ออกมาตรฐาน JESD270-4 HBM4 เมื่อ 16 เมษายน 2025 สาระหลักมีดังนี้
- บัส 2,048 บิต ที่ความเร็วสูงสุด 8 Gb/s ต่อขา ได้แบนด์วิดท์รวมสูงสุด 2 TB/s ต่อ stack
- ช่องสัญญาณเพิ่มเป็น 32 ช่อง จาก 16 ช่องใน HBM3 แต่ละช่องมี pseudo-channel 2 ช่อง
- ใช้ร่วมกับ controller ของ HBM3 ได้ controller ตัวเดียวรองรับทั้ง HBM3 และ HBM4 ได้หากต้องการ
- ซ้อนได้ 4, 8, 12 หรือ 16 ชั้น ใช้ die ขนาด 24 Gb หรือ 32 Gb ความจุสูงสุด 64 GB ต่อ stack
- Directed Refresh Management (DRFM) ช่วยรับมือการโจมตีแบบ row-hammer
สินค้าจริงวิ่งเร็วกว่ามาตรฐาน Samsung ประกาศเมื่อ 12 กุมภาพันธ์ 2026 ว่าเริ่มผลิต HBM4 จำนวนมากและส่งสินค้าเชิงพาณิชย์ให้ลูกค้าแล้ว ความเร็ว 11.7 Gbps เร่งได้ถึง 13 Gbps SK hynix เริ่มส่ง HBM4 จำนวนมากในไตรมาส 2/2026 ส่วน Micron ผลิต HBM4 ขนาด 36 GB แบบ 12 ชั้นในปริมาณมากแล้ว ความเร็วมากกว่า 11 Gb/s
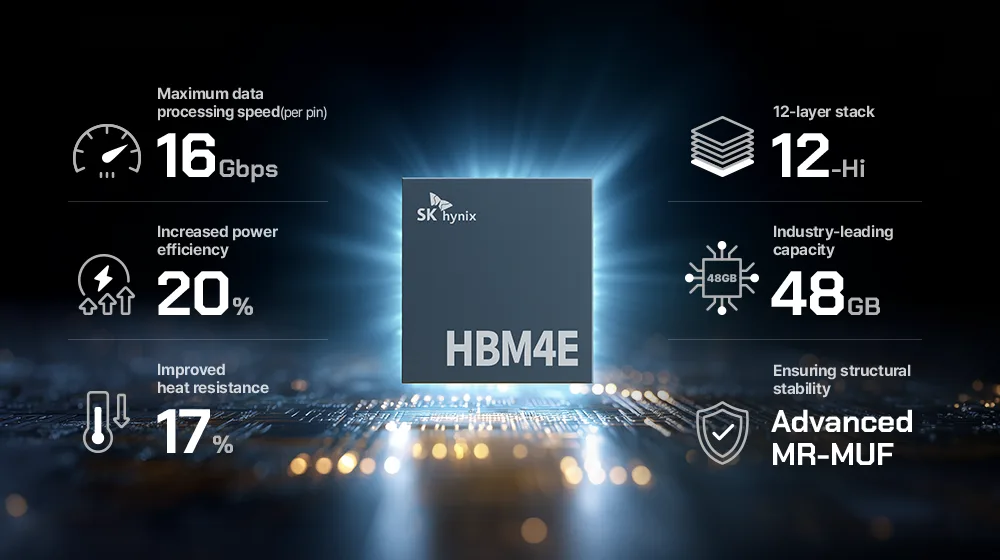
HBM4E อยู่ในขั้นส่งตัวอย่าง SK hynix ส่งตัวอย่าง HBM4E แบบ 12 ชั้นให้ลูกค้าหลักเมื่อ 18 มิถุนายน 2026 ความเร็วสูงสุด 16 Gbps ต่อขา ความจุ 48 GB ประสิทธิภาพพลังงานดีขึ้นกว่า 20% ส่วน Samsung ระบุสเปก HBM4Eสูงสุด 64 GB แบบ 16 ชั้น แบนด์วิดท์ 4 TB/s โดยบริษัทคาดไว้ตั้งแต่กุมภาพันธ์ว่าจะเริ่มส่งตัวอย่าง HBM4E ในครึ่งหลังของปี 2026 และส่งตัวอย่าง custom HBM ที่ออกแบบตามสเปกของลูกค้าแต่ละรายในปี 2027
GPU และชิป AI รุ่นไหนใช้ HBM รุ่นใด
ตารางนี้รวมสเปกหน่วยความจำต่อ GPU หนึ่งตัวจากหน้าผลิตภัณฑ์ของ NVIDIA และ AMD ณ 8 ตุลาคม 2026
| GPU | ชนิด HBM | ความจุต่อ GPU | แบนด์วิดท์ต่อ GPU |
|---|---|---|---|
| NVIDIA A100 80GB (SXM) | HBM2e | 80 GB | 2,039 GB/s |
| NVIDIA H200 | HBM3e | 141 GB | 4.8 TB/s |
| AMD Instinct MI300X | HBM3 | 192 GB | 5.3 TB/s |
| AMD Instinct MI355X | HBM3E | 288 GB | 8 TB/s |
| NVIDIA Rubin | HBM4 | 288 GB | 19.2 TB/s |
| AMD Instinct MI455X | HBM4 (12 stack) | 432 GB | 23.3 TB/s |
แบนด์วิดท์ต่อ GPU คือผลรวมของทุก stack ที่ติดอยู่ AMD แสดงวิธีคิดของ MI300Xไว้ว่าบัสหน่วยความจำกว้าง 8,192 บิต คูณความเร็ว 5.2 Gbps แล้วหารด้วย 8 ได้ 5.325 TB/s ส่วน MI455X ใช้ HBM4 12 stack รวม 432 GB เฉลี่ย stack ละ 36 GB
เมื่อเทียบกับ A100 ที่ใช้ HBM2e แบนด์วิดท์ของ NVIDIA Rubin สูงกว่าราว 9.4 เท่า และของ MI455X สูงกว่าราว 11.4 เท่า ในระดับแร็ก NVIDIA ระบุว่า Vera Rubin NVL72 ซึ่งมี GPU 72 ตัว มี HBM4 รวม 20.7 TB และแบนด์วิดท์รวม 1,400 TB/s

HBM ต่างจาก GDDR7 และ DDR5 อย่างไร
ทั้งสามแบบเป็น DRAM เหมือนกัน แต่ออกแบบมาเพื่องานต่างกัน ตารางนี้เทียบจากมาตรฐานของ JEDEC และสเปกของผู้ผลิต
| ประเด็น | HBM (HBM3E / HBM4) | GDDR7 | DDR5 |
|---|---|---|---|
| แบนด์วิดท์ต่อชิ้น | 1.18–2 TB/s ต่อ stack | สูงสุด 192 GB/s ต่อชิป | ราว 70 GB/s ต่อ module ที่ 8,800 Mbps |
| บัสข้อมูล | 1,024 หรือ 2,048 บิต | 4 ช่องอิสระต่อชิป สัญญาณ PAM3 | 64 บิตต่อ module |
| การติดตั้ง | ซ้อนเป็น stack ข้างชิปบน interposer | ชิปแยกแพ็กเกจ | DIMM บนเมนบอร์ด |
| งานหลัก | ตัวเร่ง AI, HPC, เซิร์ฟเวอร์ | กราฟิก เกม และงาน AI บางส่วน | หน่วยความจำหลักของ CPU |
ที่มา: HBM จาก Samsung และ JEDEC JESD270-4, GDDR7 จาก JEDEC JESD239, DDR5 จาก JEDEC JESD79-5C และ Micron
ตัวเลขของ DDR5 คำนวณจากความเร็ว 8,800 Mbps ที่มาตรฐาน JESD79-5Cรองรับ คูณบัส 64 บิต (1 ใน 16 ของบัส HBM ตามที่ Micron ระบุ) ได้ราว 70.4 GB/s ส่วน GDDR7 เป็น DRAM มาตรฐานแรกของ JEDEC ที่ใช้สัญญาณ PAM3 แบบสามระดับ และมีแบนด์วิดท์สองเท่าของ GDDR6
ข้อแลกเปลี่ยนของ HBM คือต้นทุนและความยืดหยุ่น HBM ติดมากับแพ็กเกจของ GPU จึงเพิ่มความจุภายหลังไม่ได้ ต่างจาก DDR5 ที่เพิ่ม DIMM ได้ องค์กรจึงต้องเลือกความจุให้พอตั้งแต่วันที่ซื้อ
ทำไม HBM ขาดตลาดและดันราคาหน่วยความจำ
ตัวเลขจากผู้ผลิตชี้ว่าความต้องการยังวิ่งนำกำลังผลิต SK hynix รายงานเมื่อ 29 กรกฎาคม 2026ว่าไตรมาส 2/2026 มีรายได้ 79.3187 ล้านล้านวอน และกำไรจากการดำเนินงาน 60.5426 ล้านล้านวอน คิดเป็นอัตรากำไร 76% สูงสุดเป็นประวัติการณ์ บริษัทระบุว่าสินค้าสมรรถนะสูงสำหรับเซิร์ฟเวอร์ AI นำการขึ้นราคา ราคา DRAM และ NAND ขึ้นมากจากไตรมาสก่อน และอยู่ในสภาพตลาดที่ความต้องการของลูกค้าสูงกว่ากำลังผลิต
ข้อมูลที่ผู้ผลิตเปิดเผยชี้ถึงสามปัจจัยที่ทำให้หน่วยความจำตึงตัวทั้งตลาด
- ผู้ผลิตให้น้ำหนักกับสินค้ามูลค่าสูง SK hynix ระบุว่าเน้นขาย HBM, DRAM สำหรับเซิร์ฟเวอร์ AI และ eSSD ขณะที่ความต้องการหน่วยความจำทั่วไปก็โตไปพร้อมกัน
- ความต้องการโตเร็วและถูกจองล่วงหน้า Samsung คาดตั้งแต่กุมภาพันธ์ 2026 ว่ายอดขาย HBM ปีนี้จะมากกว่าปี 2025 เกินสามเท่า ส่วน SK hynix ทำสัญญาระยะยาวหลายปีกับลูกค้าราว 10 ราย
- โรงงานใหม่ต้องใช้เวลา SK hynix เร่งกำหนดผลิตของโรงงาน M15X และจะขยายกำลังผลิตหลังเปิดคลีนรูมเฟสแรกที่ยงอินต้นปี 2027
ผลประกอบการของ Samsung ก็สะท้อนภาพเดียวกัน อ่านต่อได้ที่ข่าวSamsung คาดกำไรไตรมาส 3/2026 ผลของราคาหน่วยความจำต่องบไอทีในประมาณการใช้จ่าย AI ของ Gartner และแนวทางจัดซื้อเซิร์ฟเวอร์กับพีซีช่วงราคาขึ้นในบทวิเคราะห์ Memory Supercycle
องค์กรไทยที่ซื้อเซิร์ฟเวอร์ AI หรือเช่า GPU Cloud ควรดู HBM อย่างไร
- ดูความจุและแบนด์วิดท์ HBM ก่อนตัวเลข TFLOPS ประเมินหน่วยความจำที่โมเดลต้องใช้จากจำนวนพารามิเตอร์คูณจำนวนไบต์ต่อพารามิเตอร์ แล้วเผื่อ KV cache โมเดล 70,000 ล้านพารามิเตอร์แบบ 16 บิตต้องการราว 140 GB เกินความจุของ A100 80GB หนึ่งตัว และเกือบเต็ม H200 ที่มี 141 GB
- ขอสเปกหน่วยความจำให้ชัด ชื่อ GPU เดียวกันมีหลายรุ่นย่อย เช่น A100 80GB แบบ PCIe มีแบนด์วิดท์ 1,935 GB/s ส่วนแบบ SXM มี 2,039 GB/s เมื่อเช่า GPU Cloud ให้ผู้ให้บริการระบุรุ่น GPU ชนิด HBM ความจุ และแบนด์วิดท์ต่อ GPU
- เผื่องบและเวลาส่งมอบ ผู้ผลิตยังรายงานว่าความต้องการเกินกำลังผลิต ราคาเสนอขายเซิร์ฟเวอร์ AI อาจมีอายุสั้น ควรขอยืนราคาเป็นลายลักษณ์อักษรและวางแผนจัดซื้อเป็นระยะ
- รุ่น HBM บอกอายุของแพลตฟอร์ม HBM4 เพิ่งเริ่มส่งมอบจำนวนมากในปี 2026 และ SK hynix จะเร่งผลิตในครึ่งหลังของปี ส่วนระบบที่ใช้ HBM3E ยังเหมาะกับหลายงาน ถ้าโมเดลที่ใช้จริงพอดีกับความจุ ไม่จำเป็นต้องจ่ายเพื่อรุ่นใหม่ที่สุด
- คิดเรื่องไฟฟ้าและความเย็นไปพร้อมกัน H200 แบบ SXM ใช้ไฟสูงสุด 700 วัตต์ และ AMD MI355X มีค่าใช้ไฟของบอร์ด 1,400 วัตต์ ห้องเซิร์ฟเวอร์เดิมอาจรองรับไม่ไหว ดูทิศทางกติกาไฟฟ้าสำหรับดาต้าเซ็นเตอร์ในไทยได้ที่ข่าว กกพ. เตรียมกติกาไฟฟ้า Data Center
สำหรับองค์กรส่วนใหญ่ ตัวเลขที่ควรจำคือความจุ HBM ต่อ GPU และแบนด์วิดท์ต่อ GPU สองค่านี้บอกได้ว่าโมเดลที่จะใช้ลงเครื่องได้หรือไม่และตอบได้เร็วแค่ไหน ติดตามข่าวชิปและเซิร์ฟเวอร์ AI เพิ่มเติมได้ที่หมวดฮาร์ดแวร์
คำถามที่พบบ่อย
HBM คืออะไร แบบสั้นที่สุด?
HBM (High Bandwidth Memory) คือหน่วยความจำ DRAM ที่นำชิปหลายชั้นมาซ้อนกันในแนวตั้ง เชื่อมแต่ละชั้นด้วย TSV แล้ววางไว้ชิด GPU หรือชิป AI ในแพ็กเกจเดียวกัน บัสข้อมูลที่กว้าง 1,024–2,048 บิตทำให้ HBM หนึ่ง stack ส่งข้อมูลได้ตั้งแต่ราว 0.46 ถึง 4 TB/s ขึ้นกับรุ่น
HBM ต่างจาก DDR5 และ GDDR7 อย่างไร?
HBM ใช้บัสกว้างมากและวางชิดชิปประมวลผลบน interposer ส่วน DDR5 และ GDDR7 เป็นชิปแยกแพ็กเกจที่ใช้บัสแคบกว่า ผลคือ HBM3E หนึ่ง stack ให้แบนด์วิดท์ราว 1.18 TB/s เทียบกับ GDDR7 สูงสุด 192 GB/s ต่อชิป และ DDR5-8800 ราว 70 GB/s ต่อ module แต่ HBM แพงกว่าและเพิ่มความจุภายหลังไม่ได้
HBM4 เร็วกว่า HBM3E แค่ไหน?
มาตรฐาน HBM4 ของ JEDEC ขยายบัสจาก 1,024 เป็น 2,048 บิต และกำหนดแบนด์วิดท์สูงสุด 2 TB/s ต่อ stack สินค้าจริงทำได้มากกว่านั้น Samsung ระบุว่า HBM4 ของตนเร็วสูงสุด 3.3 TB/s หรือ 2.7 เท่าของ HBM3E ส่วน Micron ระบุว่ามากกว่า 2.8 TB/s หรือ 2.3 เท่าของ HBM3E
ทำไม HBM ขาดตลาดและทำให้ราคาหน่วยความจำแพงขึ้น?
ความต้องการเซิร์ฟเวอร์ AI สูงกว่ากำลังผลิต SK hynix ระบุเมื่อ 29 กรกฎาคม 2026 ว่าความต้องการของลูกค้าเกินกำลังผลิต บริษัทเน้นขายสินค้ามูลค่าสูงอย่าง HBM และ DRAM สำหรับเซิร์ฟเวอร์ AI ราคา DRAM และ NAND ขึ้นมากจากไตรมาสก่อน และลูกค้ารายใหญ่ทำสัญญาซื้อระยะยาวหลายปี
ซื้อเซิร์ฟเวอร์ AI หรือเช่า GPU Cloud ควรดูสเปก HBM อะไรบ้าง?
ดูสามค่า ได้แก่ ความจุ HBM ต่อ GPU ว่าพอเก็บน้ำหนักโมเดลและ KV cache หรือไม่ แบนด์วิดท์ต่อ GPU ซึ่งมีผลกับความเร็วในการสร้างคำตอบของโมเดลภาษา และรุ่นของ HBM ซึ่งบอกอายุของแพลตฟอร์ม เช่น NVIDIA H200 มี HBM3e 141 GB ที่ 4.8 TB/s ส่วน NVIDIA Rubin มี HBM4 288 GB ที่ 19.2 TB/s
แหล่งอ้างอิง
- JEDEC and Industry Leaders Collaborate to Release JESD270-4 HBM4 Standard — JEDEC
- JEDEC Publishes HBM3 Update to High Bandwidth Memory (HBM) Standard — JEDEC
- Samsung Ships Industry-First Commercial HBM4 With Ultimate Performance for AI Computing — Samsung Electronics
- SK hynix Ships Samples of 12-Layer Next-Gen HBM4E — SK hynix
- High-bandwidth memory (HBM) — Micron Technology
- NVIDIA Vera Rubin NVL72 — NVIDIA
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ