
Meta Commercial Terms ฉบับใหม่มีผล 30 ต.ค. ขอสิทธิ์ crawl เว็บไซต์ธุรกิจไปฝึก AI
Meta Commercial Terms ฉบับใหม่มีผล 30 ต.ค. 2026 ให้ Meta ใช้ crawler เก็บเนื้อหาเว็บไซต์ของธุรกิจที่ใช้ Facebook และ Instagram ไปฝึก AI ได้ สื่อกังวล
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
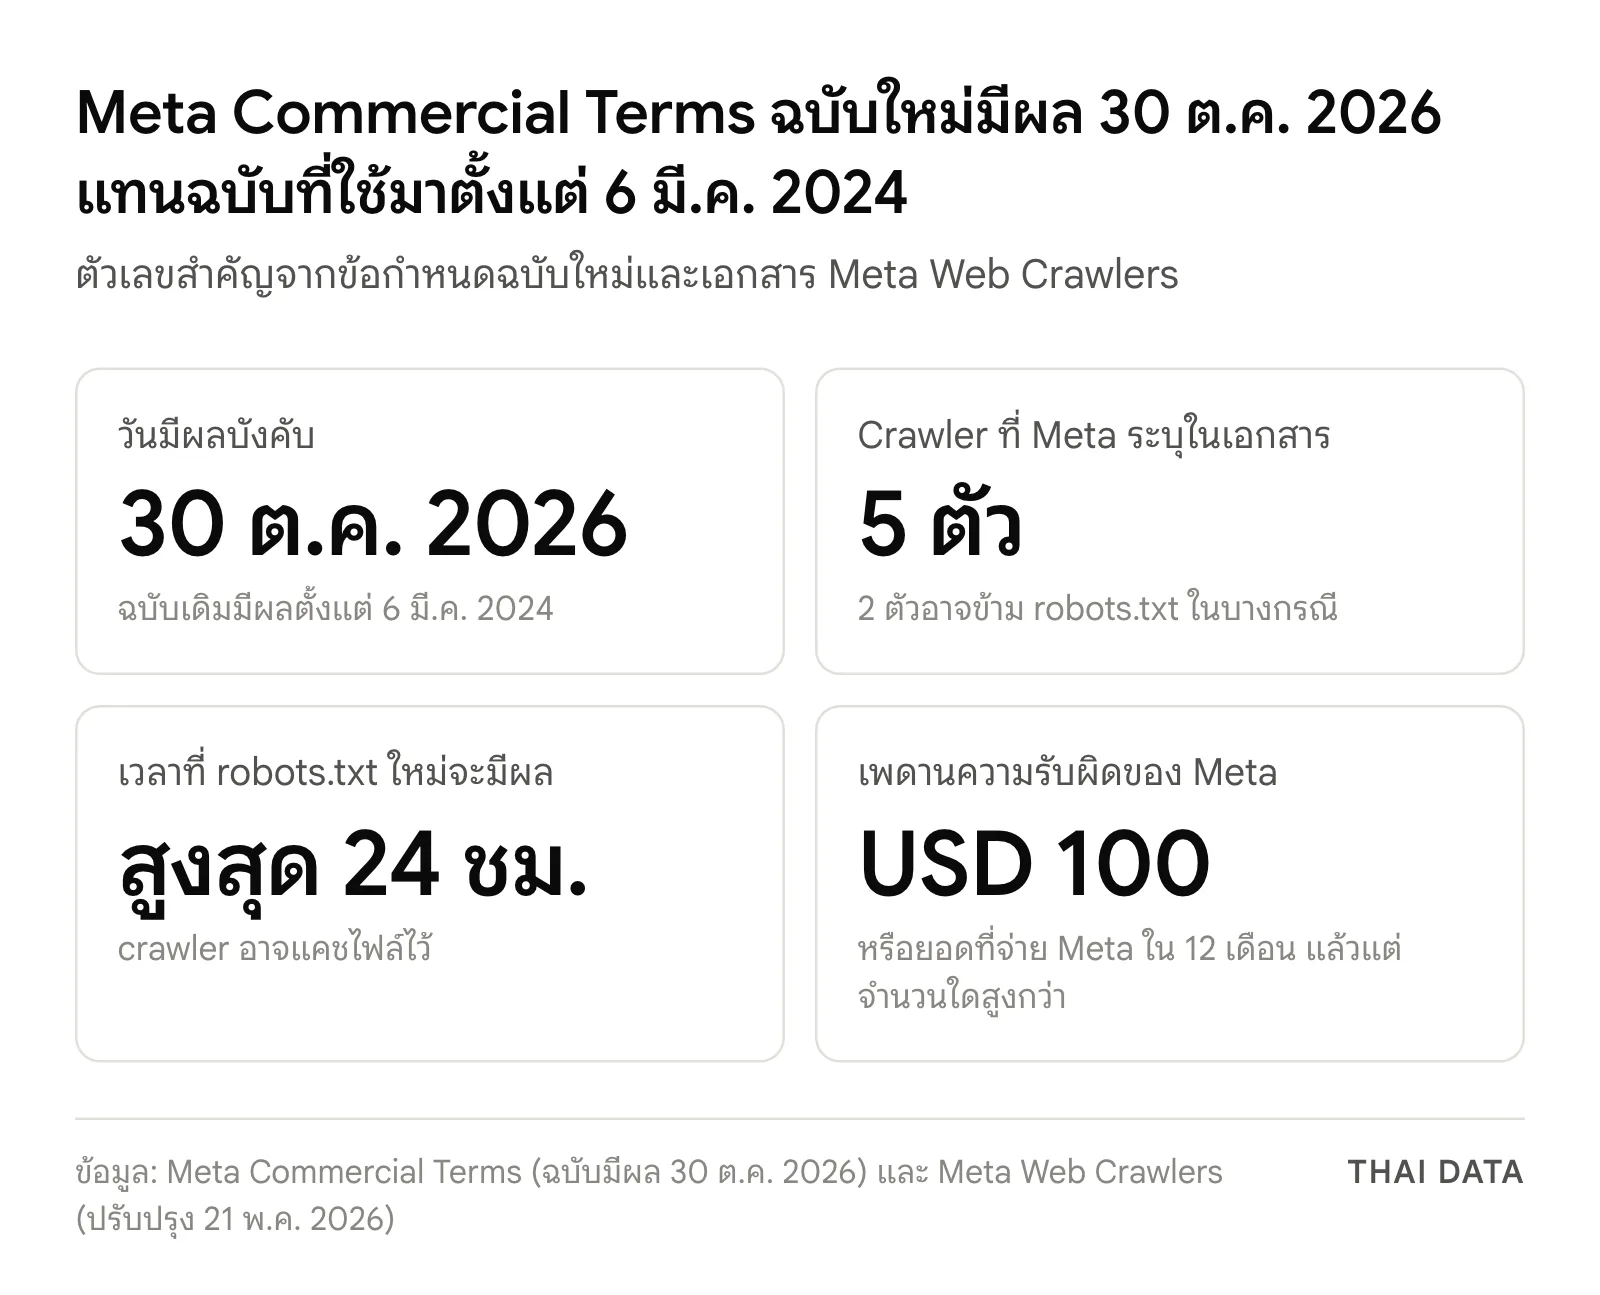
- Meta Commercial Terms ฉบับใหม่มีผล 30 ตุลาคม 2026 แทนฉบับที่ใช้ตั้งแต่ 6 มีนาคม 2024 และใช้กับทุกคนที่ใช้ผลิตภัณฑ์ของ Meta เพื่อธุรกิจ ตั้งแต่ลงโฆษณา ขายสินค้า ไปจนถึงดูแลเพจ
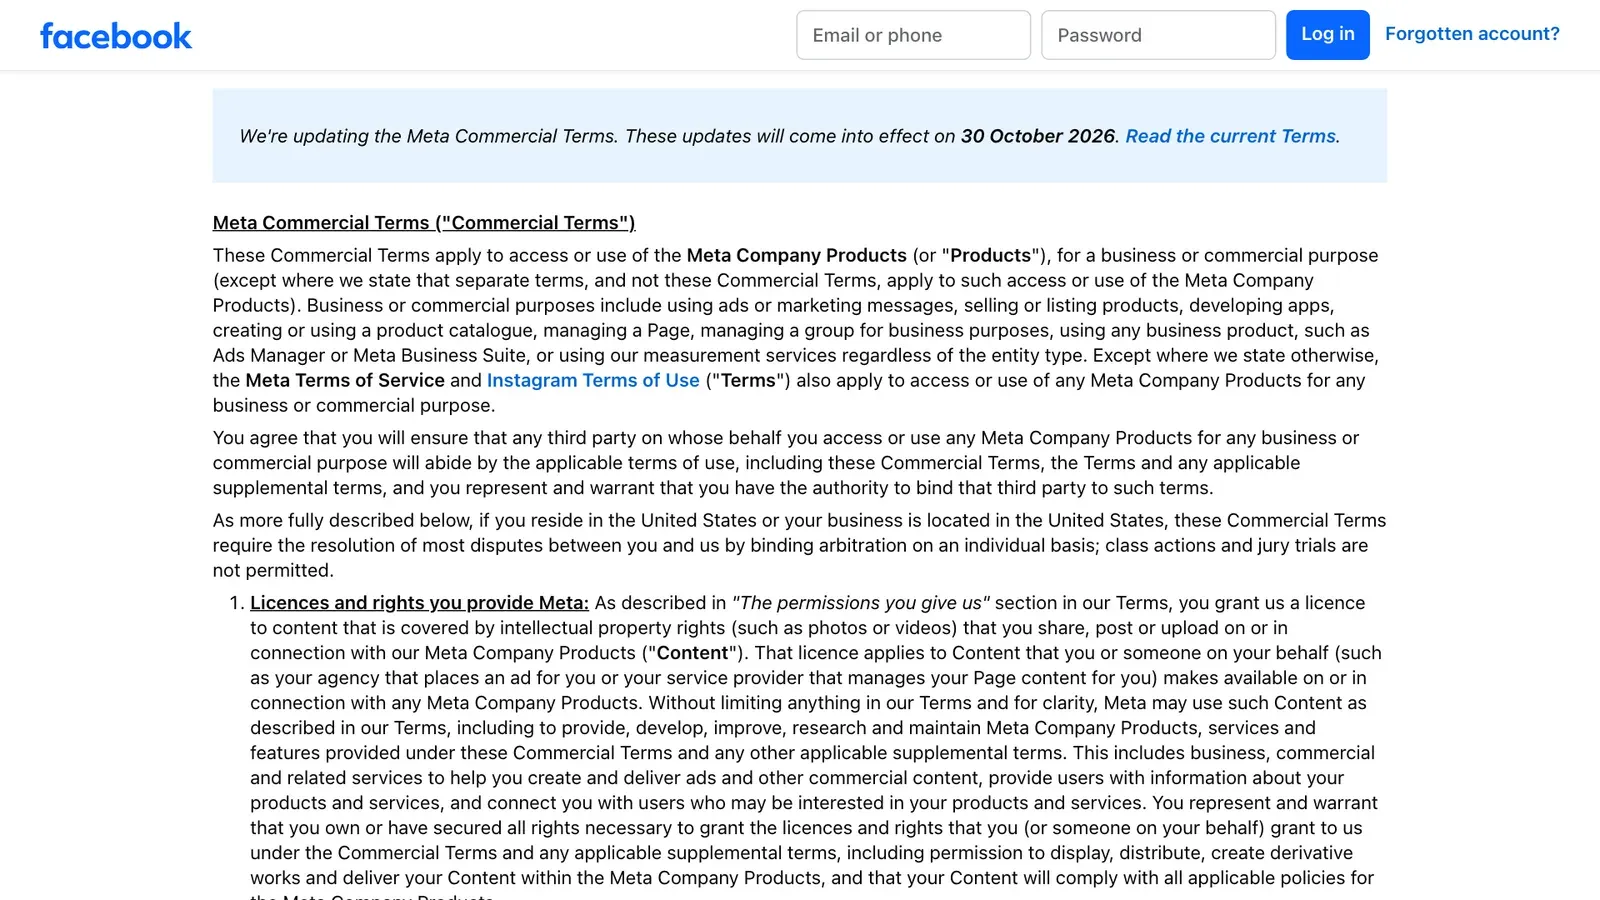
- ข้อใหม่ใน Meta Commercial Terms ที่มีผล 30 ต.ค. ให้ Meta ใช้ web scraper, bot และ crawler เก็บเนื้อหาจากโดเมนที่ เกี่ยวข้องกับสินค้าหรือบริการ ของธุรกิจ และนำไปใช้ ฝึก (train) และพัฒนาผลิตภัณฑ์ของ Meta
- โฆษก Meta ยืนยันกับ The Verge เมื่อ 16 ต.ค. 2026 ว่า ไม่มีการเปลี่ยนวิธีใช้ crawler และเจ้าของเว็บยังใช้ robots.txt ได้ ขณะที่ผู้เชี่ยวชาญกฎหมายที่ Nieman Lab สัมภาษณ์มองว่าเปิดทางให้ใช้เนื้อหาเว็บข่าว
- เอกสารของ Meta ระบุ crawler 5 ตัว โดย Meta-ExternalAgent ใช้ฝึกโมเดล AI และ crawler 2 ตัว อาจข้าม robots.txt ในบางกรณี
Meta ปรับ Meta Commercial Terms ฉบับใหม่ที่จะมีผลวันที่ 30 ตุลาคม 2026 โดยเพิ่มข้อที่ให้บริษัทใช้ crawler เก็บเนื้อหาจากเว็บไซต์ของธุรกิจที่ใช้ Facebook, Instagram, WhatsApp และ Messenger แล้วนำไปฝึกและพัฒนาผลิตภัณฑ์ของ Meta ได้ สื่อต่างประเทศเริ่มรายงานความกังวลของผู้เชี่ยวชาญกฎหมายตั้งแต่ 15–16 ตุลาคม ว่าจะเปิดทางให้ Meta ใช้เนื้อหาเว็บข่าวฝึก AI โดยไม่ต้องจ่ายค่าลิขสิทธิ์
ข้อกำหนดนี้ใช้กับทุกคนที่ใช้ผลิตภัณฑ์ของ Meta เพื่อธุรกิจ ไม่ว่าเป็นองค์กรประเภทใด หน้าข้อกำหนดฉบับใหม่ระบุว่ารวมถึงการลงโฆษณาหรือข้อความการตลาด การขายหรือลงรายการสินค้า การสร้างแค็ตตาล็อก การดูแลเพจหรือกลุ่มเพื่อธุรกิจ และการใช้ Ads Manager หรือ Meta Business Suite
Meta Commercial Terms ข้อใหม่เรื่อง crawler เขียนว่าอะไร
ข้อที่เป็นประเด็นอยู่ใต้หัวข้อสิทธิ์และใบอนุญาตที่ธุรกิจให้กับ Meta สาระสำคัญมีสามส่วน
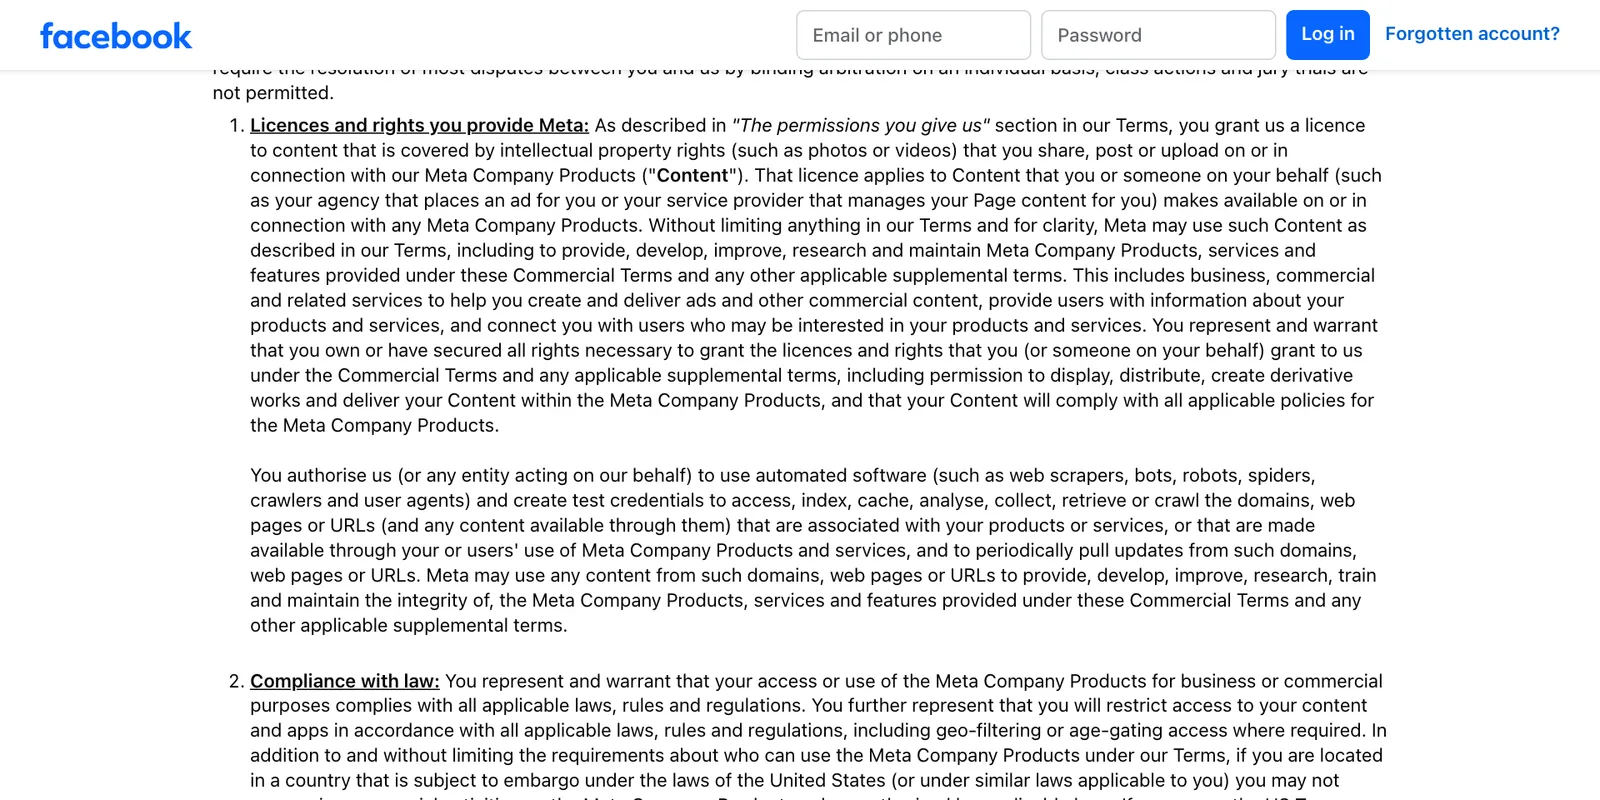
- อนุญาตให้ใช้ซอฟต์แวร์อัตโนมัติ เช่น web scraper, bot, spider และ crawler รวมถึงสร้าง test credential เพื่อเข้าถึง จัดทำดัชนี แคช วิเคราะห์ และเก็บข้อมูลจากโดเมน หน้าเว็บ หรือ URL
- ขอบเขตคือเว็บที่ "เกี่ยวข้องกับสินค้าหรือบริการ" ของธุรกิจ หรือที่ถูกเปิดผ่านการใช้ผลิตภัณฑ์ของ Meta และให้ดึงข้อมูลอัปเดตเป็นระยะ
- นำเนื้อหาไปใช้ได้ เพื่อให้บริการ พัฒนา ปรับปรุง วิจัย ฝึก (train) และรักษาความถูกต้องของผลิตภัณฑ์และบริการของ Meta
ฉบับใหม่ยังขยายข้อความเรื่องใบอนุญาตเนื้อหาที่ธุรกิจโพสต์ ให้รวมสิทธิ์สร้างงานดัดแปลง (derivative works) และระบุชัดว่า Meta ใช้เนื้อหาเพื่อพัฒนาและวิจัยผลิตภัณฑ์ได้
Meta ชี้แจงว่า Meta Commercial Terms ไม่ได้เปลี่ยนวิธีใช้ crawler
The Verge รายงานเมื่อ 16 ตุลาคม 2026 ว่า Daniel Roberts โฆษกของ Meta ระบุว่าบริษัทเพียง "รวม" ข้อกำหนดเชิงพาณิชย์กับข้อกำหนดโฆษณาแบบบริการตนเองเข้าด้วยกัน และยืนยันว่า "ไม่มีการเปลี่ยนแปลงวิธีที่ Meta ใช้ web crawler" เจ้าของเนื้อหายังใช้ robots.txt แสดงความต้องการได้ตามเอกสารสำหรับนักพัฒนา
Andy Stone รองประธานฝ่ายสื่อสารของ Meta โพสต์บน X ตามที่ The Verge อ้าง ว่าการแก้ไขนี้มีไว้ดึงข้อมูลสินค้าที่ขายบนเว็บไซต์ภายนอกให้ถูกต้องเพื่อแนะนำโฆษณาและเนื้อหาบนแพลตฟอร์ม ไม่ได้มีเป้าหมายที่เว็บข่าว
อีกฝั่ง ผู้เชี่ยวชาญกฎหมายที่ Nieman Lab สัมภาษณ์มองว่า Meta อาจใช้ข้อกำหนดนี้อ้างว่ามีน้ำหนักเหนือคำสั่งบล็อกอย่าง robots.txt James Grimmelmann ศาสตราจารย์ด้านกฎหมายดิจิทัลของ Cornell ระบุว่าสำหรับสำนักข่าว ข้อนี้ชัดเจนว่าเป็นการอนุญาตให้ Meta ฝึก AI ด้วยเนื้อหาทุกอย่างบนเว็บ
เปลี่ยนอะไรอีกใน Meta Commercial Terms
| ประเด็น | ฉบับ 6 มี.ค. 2024 | ฉบับ 30 ต.ค. 2026 |
|---|---|---|
| crawler เก็บเนื้อหาเว็บธุรกิจ | ไม่มีข้อนี้ | อนุญาต และใช้ฝึกผลิตภัณฑ์ได้ |
| ฟีเจอร์ AI | ไม่มีหัวข้อเฉพาะ | ธุรกิจรับความเสี่ยงของเนื้อหาที่ AI สร้างเอง ห้ามลบลายน้ำหรือ metadata ยืนยันที่มาของเนื้อหา AI |
| ข้อกำหนดเสริม | แยกเป็นหลายฉบับ | รวม Self-serve Ad Terms, Business Tools Terms, Seller Agreement และข้อกำหนด Business Agents ไว้ในฉบับเดียว |
| การหยุดให้บริการ | ไม่ระบุ | Meta ปรับ จำกัด ระงับ หรือเลิกบริการเชิงพาณิชย์ได้โดยไม่ต้องแจ้งล่วงหน้า |
| เพดานความรับผิดของ Meta | 100 ดอลลาร์สหรัฐ หรือยอดที่จ่ายใน 12 เดือน | เท่าเดิม เพิ่มคำว่า "เท่าที่กฎหมายอนุญาต" |
Business Tools Terms ที่ถูกรวมเข้ามาครอบคลุมเครื่องมือเก็บข้อมูลอย่าง Meta Pixel และ Conversions API ซึ่งเว็บไซต์ธุรกิจจำนวนมากติดตั้งไว้เพื่อวัดผลโฆษณา
crawler ของ Meta และ robots.txt หลัง Meta Commercial Terms มีผล
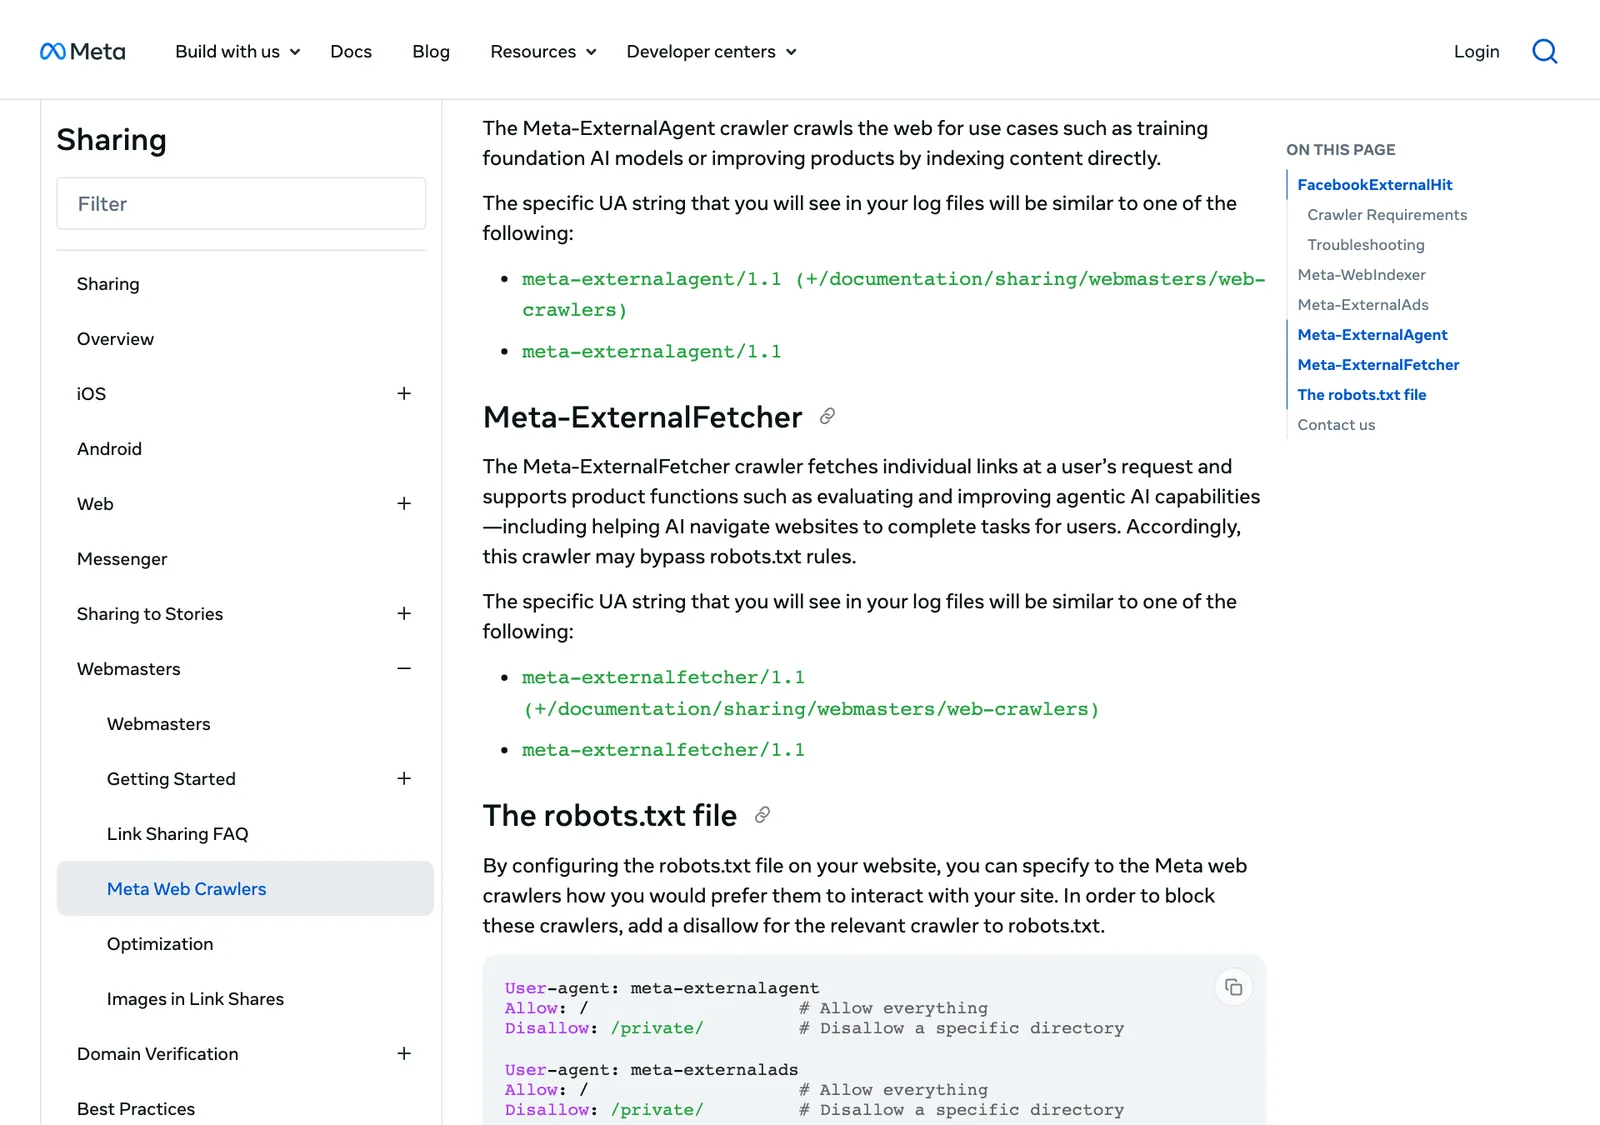
เอกสาร Meta Web Crawlers (ปรับปรุง 21 พฤษภาคม 2026) ระบุ crawler 5 ตัวพร้อมหน้าที่ ได้แก่ FacebookExternalHit ดึงตัวอย่างลิงก์ที่ถูกแชร์, Meta-WebIndexer ปรับผลค้นหาของ Meta AI, Meta-ExternalAds ใช้กับโฆษณาและบริการธุรกิจ, Meta-ExternalAgent ใช้ "ฝึกโมเดล AI พื้นฐาน" และ Meta-ExternalFetcher ดึงลิงก์ตามคำขอของผู้ใช้
เจ้าของเว็บบล็อกได้ด้วยการใส่ Disallow ใน robots.txt และอาจต้องรอถึง 24 ชั่วโมงกว่าจะมีผล แต่เอกสารยอมรับว่า Meta-ExternalFetcher อาจข้าม robots.txt เพราะทำงานตามคำขอของผู้ใช้ และ FacebookExternalHit อาจข้ามเมื่อตรวจความปลอดภัยหรือหามัลแวร์
ทำไมเรื่องนี้สำคัญ
ผู้พัฒนา AI ต้องการข้อมูลจำนวนมาก และหลายรายเลือกทำสัญญาอนุญาตใช้เนื้อหากับสำนักข่าว The Verge ระบุว่า Meta เองก็มีดีลลักษณะนี้กับ CNN, Fox News, USA Today และ People Inc. การเขียนสิทธิ์เก็บเนื้อหาลงใน Meta Commercial Terms ซึ่งธุรกิจต้องยอมรับเพื่อใช้แพลตฟอร์ม จึงเปลี่ยนคำถามจาก "จะขายเนื้อหาหรือไม่" เป็น "ยอมรับข้อกำหนดหรือเลิกใช้แพลตฟอร์ม" สำหรับธุรกิจที่พึ่ง Facebook และ Instagram ในการหาลูกค้า
สิ่งที่องค์กรไทยควรทำ
- ให้ฝ่ายกฎหมายอ่าน Meta Commercial Terms ฉบับใหม่ก่อน 30 ต.ค. 2026 โดยเฉพาะข้อ crawler ข้อฟีเจอร์ AI และข้อที่ Meta ระงับบริการได้โดยไม่แจ้งล่วงหน้า
- ตรวจ robots.txt ของเว็บไซต์องค์กร ตัดสินใจว่าจะอนุญาตหรือบล็อก meta-externalagent และ meta-externalads แล้วตรวจ log ว่า crawler เข้ามาเก็บหน้าไหนบ้าง
- สำนักข่าวและผู้ผลิตเนื้อหา ประเมินว่าเนื้อหาส่วนใดควรอยู่หลังระบบสมาชิก และทบทวนสัญญาอนุญาตใช้เนื้อหากับแพลตฟอร์ม AI
- ทบทวนข้อมูลบนหน้าเว็บสาธารณะ ที่ crawler เข้าถึงได้ เช่น รายชื่อหรือข้อมูลติดต่อบุคคล ว่าเปิดเผยเกินความจำเป็นตาม PDPA หรือไม่
- ทีมการตลาดที่ใช้ฟีเจอร์ AI ของ Meta ตั้งขั้นตอนตรวจเนื้อหาก่อนเผยแพร่ และห้ามลบลายน้ำหรือ metadata ของภาพที่ AI สร้าง
ติดตามข่าวธุรกิจสื่อ โฆษณา และแพลตฟอร์มโซเชียลเพิ่มเติมได้ที่หมวด Media และอ่านประเด็นที่ใกล้กันได้ในข่าว Meta เปิดเครื่องมือ AI ใหม่ใน Ads Manager
คำถามที่พบบ่อย
Meta Commercial Terms ฉบับใหม่เปลี่ยนอะไร?
Meta Commercial Terms ฉบับที่มีผล 30 ตุลาคม 2026 เพิ่มข้อที่ให้ Meta ใช้ crawler เก็บเนื้อหาจากเว็บไซต์ที่เกี่ยวข้องกับสินค้าหรือบริการของธุรกิจ และนำไปใช้พัฒนาและฝึกผลิตภัณฑ์ของ Meta ได้ พร้อมเพิ่มข้อรับผิดชอบเรื่องฟีเจอร์ AI และรวมข้อกำหนดโฆษณา Business Tools และ Seller Agreement ไว้ในฉบับเดียว
ธุรกิจไทยที่ใช้ Facebook หรือ Instagram อยู่ภายใต้ Meta Commercial Terms หรือไม่?
Meta Commercial Terms ใช้กับการใช้ผลิตภัณฑ์ของ Meta เพื่อธุรกิจทุกประเภท เช่น ลงโฆษณา ขายหรือลงรายการสินค้า สร้างแค็ตตาล็อก ดูแลเพจ หรือใช้ Ads Manager และ Meta Business Suite ธุรกิจไทยที่ทำสิ่งเหล่านี้จึงอยู่ภายใต้ข้อกำหนดใหม่เมื่อใช้งานต่อหลัง 30 ตุลาคม 2026
ป้องกันไม่ให้ Meta นำเนื้อหาเว็บไซต์ไปฝึก AI ได้อย่างไร?
แม้ Meta Commercial Terms ฉบับใหม่จะให้สิทธิ์ crawl แต่เอกสาร Meta Web Crawlers ยังแนะนำให้ใส่ Disallow สำหรับ user agent meta-externalagent ซึ่งใช้ฝึกโมเดล AI และ meta-externalads ใน robots.txt โดยการเปลี่ยนแปลงอาจใช้เวลาถึง 24 ชั่วโมง ทั้งนี้ Meta-ExternalFetcher และ FacebookExternalHit อาจข้าม robots.txt ในบางกรณี
ถ้าไม่ยอมรับข้อกำหนดใหม่ต้องทำอย่างไร?
Meta Commercial Terms ระบุว่าการใช้ผลิตภัณฑ์ของ Meta เพื่อธุรกิจต่อหลังได้รับแจ้งการแก้ไขถือว่ายอมรับข้อกำหนดใหม่ ส่วนผู้ที่ไม่เห็นด้วยสามารถหยุดใช้ผลิตภัณฑ์ของ Meta เพื่อธุรกิจได้
แหล่งอ้างอิง
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ