
llama.cpp v1.0.0 ออกเมื่อ 13 พ.ย. 2026 พร้อม ggml v1.0.0 ลบฟังก์ชัน API เก่า 35 ตัว เพิ่ม FP8 KV cache, MoE cache และแก้ช่องโหว่ llama-server ตามโครงการ
โดย กองบรรณาธิการ THAI DATA อ่าน 3 นาที
สรุปประเด็นสำคัญ
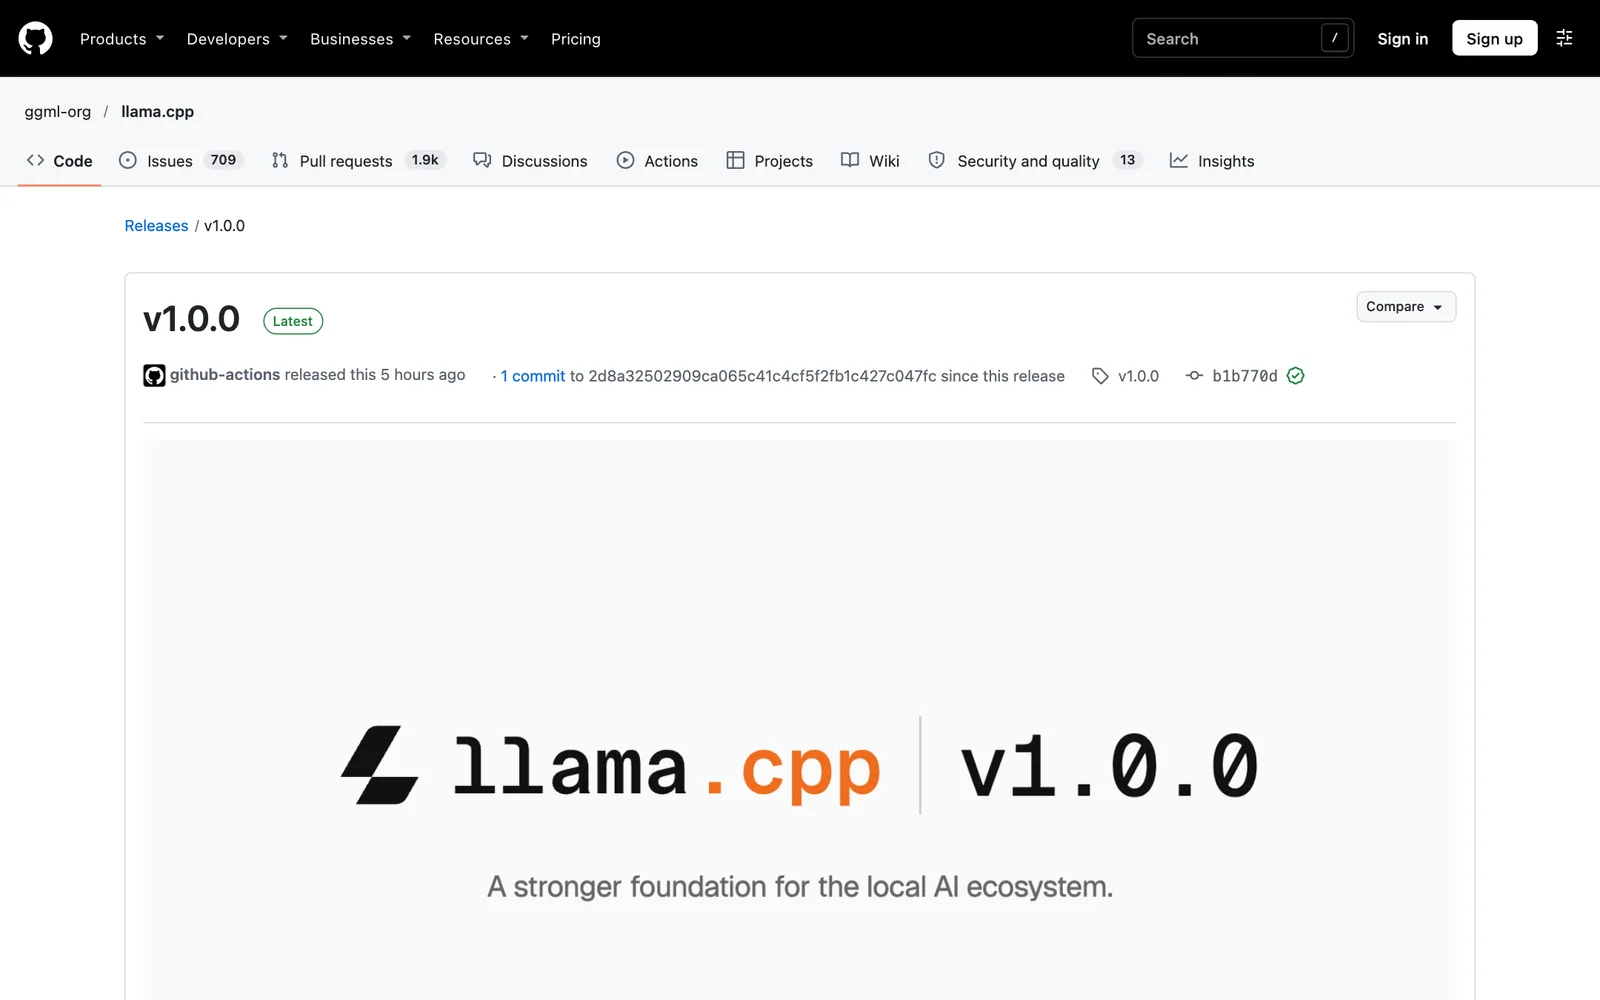
- ทีม ggml-org ปล่อย llama.cpp v1.0.0 และ ggml v1.0.0 เมื่อ 13 พฤศจิกายน 2026 ตามหน้าปล่อยเวอร์ชันบน GitHub และบล็อกของ Hugging Face
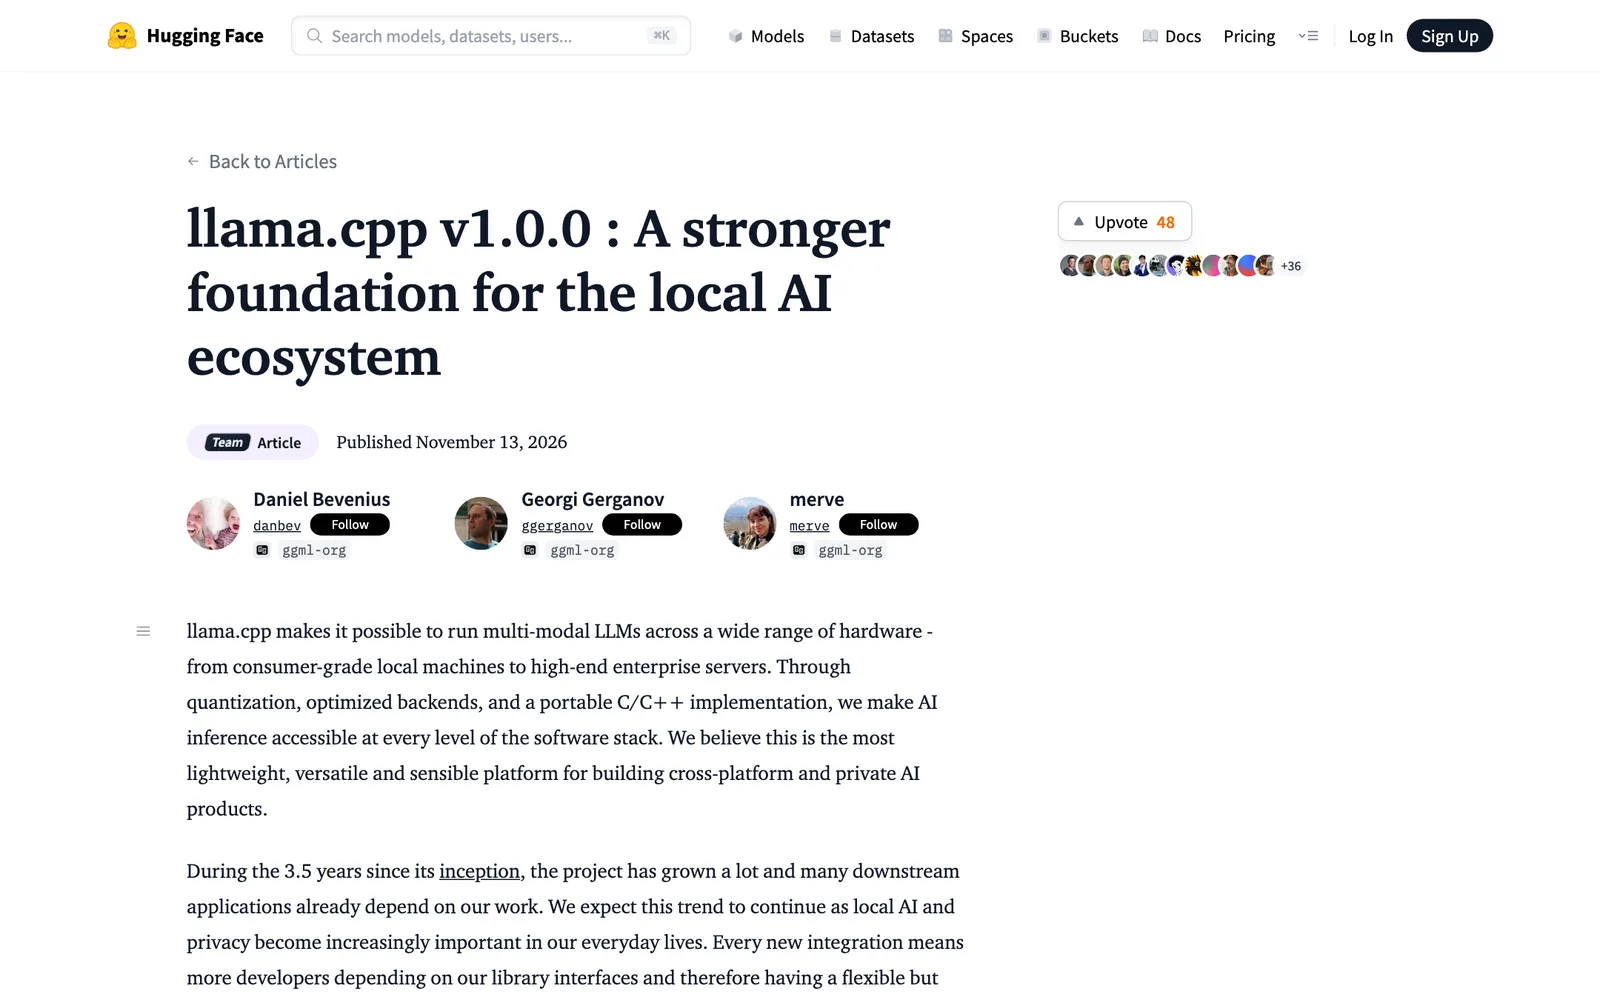
- นับจากนี้ทั้ง llama.cpp และ ggml จะใช้ เวอร์ชันหลัก (major) บอกการเปลี่ยน API/ABI ที่ไม่เข้ากัน ส่วน MINOR คือฟีเจอร์หรือโมเดลใหม่ที่เข้ากันได้ย้อนหลัง
- v1.0.0 ลบ API ที่เลิกใช้แล้ว รวม 35 ฟังก์ชันใน llama.h และตัวเลือก --defrag-thold ผู้ที่เรียกใช้ไลบรารีต้องตรวจโค้ดก่อนอัปเกรด
- เพิ่ม FP8 KV cache (f8_e4m3), MoE expert cache ในหน่วยความจำโฮสต์, สถาปัตยกรรมใหม่ 3 แบบ และเสียง TTS drama-3
- ฝั่ง llama-server แก้ช่องโหว่ CORS, DNS rebinding, SSRF และการเข้าถึงอินสแตนซ์ลูก พร้อมออปชันเปิดเฉพาะเมื่อต้องการ เช่น --allow-unauthenticated-tools
llama.cpp v1.0.0 ออกเมื่อ 13 พฤศจิกายน 2026 พร้อม ggml v1.0.0 ซึ่งเป็นไลบรารีเครื่องมือรัน AI บนเครื่องตัวเองที่นักพัฒนาใช้กันแพร่หลาย ตามหน้าปล่อยเวอร์ชันบน GitHub ของ ggml-org รุ่นนี้ลบ API ที่เลิกใช้แล้ว เพิ่ม FP8 KV cache และ MoE cache รองรับโมเดลและเสียงใหม่ และอุดช่องโหว่ของ llama-server ส่วนบล็อกบน Hugging Face ระบุว่านับจากนี้การเปลี่ยน API/ABI ที่ไม่เข้ากันจะขึ้นเวอร์ชันหลักทุกครั้ง
llama.cpp v1.0.0 เปลี่ยนกติกาเวอร์ชันอย่างไร
ทีมโครงการระบุว่า 3.5 ปีที่ผ่านมา llama.cpp มีแอปปลายทางจำนวนมากพึ่งพาอยู่ จึงต้องทำให้อินเทอร์เฟซของไลบรารีเสถียรและชัดเจน กติกา semantic versioning ที่ใช้กับทุกโครงการของ ggml-org มีดังนี้
| ชนิดการเปลี่ยนแปลง | เพิ่มเลข |
|---|---|
| เปลี่ยน public C API ใน ./include แบบไม่เข้ากันย้อนหลัง | MAJOR |
| ฟีเจอร์ แบ็กเอนด์ โมเดล หรือ API ใหม่ที่เข้ากันได้ย้อนหลัง | MINOR |
| แก้บั๊กโดยไม่เปลี่ยน API | PATCH |
รุ่นนี้ปล่อยไลบรารี 2 ตัว คือ llama.cpp v1.0.0 (libllama ส่วนหัวอยู่ใน llama.cpp/include/) และ ggml v1.0.0 (libggml ส่วนหัวอยู่ใน ggml/include/)
llama.cpp v1.0.0 ลบและย้าย API อะไร
- ลบ
llama_set_warmupและฟังก์ชันที่เลิกใช้แล้วอีก 35 ตัวใน llama.h รวมทั้งdefrag_tholdและตัวเลือก--defrag-thold - ย้าย NextN API จาก
llama-ext.hขึ้นเป็นllama.hและเปลี่ยนชื่อllama_set_embd_state_srcเป็นllama_set_ctx_state_src - เพิ่ม
moe_cache_sizeและmoe_cache_cpu_shareในllama_context_params - ลบ
clip.hและรวมโครงสร้างโมเดลและ subcontext เข้าmtmd
ผู้ที่คอมไพล์โปรแกรมเทียบกับ llama.cpp v1.0.0 ควรเช็กการลบเหล่านี้ก่อน เพราะโค้ดที่ยังเรียกฟังก์ชันที่เลิกใช้จะคอมไพล์ไม่ผ่าน
ความสามารถใหม่ใน llama.cpp v1.0.0
- FP8 KV cache ตัวเลือก
-ctk/-ctv f8_e4m3พร้อมสเกลแบบ per-tensor แบบกำหนดเองได้ - MoE cache แคชผู้เชี่ยวชาญของโมเดล MoE ในหน่วยความจำโฮสต์ ตั้งสัดส่วนที่ใช้ CPU ได้ และมีนโยบายแทนที่แบบ LRFU/ClassLRU
- โมเดลใหม่ Kimi-K3.1-Pro, Ripple-65B-Preview และ xing4_0 รวมเสียงสังเคราะห์ drama-3 ของ fishaudio
- มัลติโมดัล รองรับอินพุตเสียงสตรีมของ Gemma 4 และภาพของ MageVL-Cowork กับ Kimi-K3.1
- เว็บ UI ใหม่ มีกลุ่มแชต ตัวแก้ markdown แบบดูตัวอย่างสด และเลย์เอาต์บนมือถือ
- ggml v1.0.0 ลบ API เก่า เพิ่มรองรับ FP8 และปรับประสิทธิภาพหลายแบ็กเอนด์ เช่น CUDA, Metal, Vulkan, SYCL, OpenCL, WebGPU และ Hexagon
บล็อกของทีมระบุว่า llama.cpp รองรับสถาปัตยกรรมโมเดลกว่า 150 แบบ และวิธีเผยแพร่มีทั้งไบนารีล่วงหน้า (Linux, macOS, Windows, Android, iOS), Docker, Debian, Homebrew, conda-forge, MacPorts, Winget และ XCFramework
แก้ช่องโหว่ใน llama-server ของ llama.cpp v1.0.0
หน้าปล่อยเวอร์ชันระบุว่าส่วนเซิร์ฟเวอร์ได้รับการเสริมความปลอดภัยหลายจุด
- แก้
--cors-originsการโจมตี DNS rebinding ช่อง SSRF ของ CORS proxy และการเข้าถึงอินสแตนซ์ลูก - เพิ่มออปชัน
--allow-unauthenticated-toolsและ--media-allow-private-urlsที่ต้องเปิดเองจึงใช้ได้ - จำกัด
HF_TOKENให้ส่งเฉพาะโฮสต์ huggingface.co - ยกเลิกการเรียกเครื่องมือ MCP เมื่อไคลเอนต์ตัดการเชื่อมต่อหรือหมดเวลา
หน้าปล่อยเวอร์ชันไม่ได้ให้หมายเลข CVE หรือระดับความรุนแรงของช่องโหว่เหล่านี้ ผู้ที่เปิด llama-server ให้เครือข่ายอื่นเข้าถึงได้จึงควรอัปเกรดและตรวจการตั้งค่าตามรายการข้างต้น
ทำไม llama.cpp v1.0.0 สำคัญกับองค์กรไทย
สำหรับ llama.cpp v1.0.0 ประเด็นหลักของทีมไอทีคือการวางแผนอัปเกรด องค์กรที่ต้องการรันโมเดลภายในเครื่องหรือภายในเครือข่ายตัวเอง เช่น เพื่อให้ข้อมูลไม่ออกนอกองค์กร มักใช้ llama.cpp หรือซอฟต์แวร์ที่สร้างบนมัน การที่โครงการกำหนดกติกาเวอร์ชันชัดเจนช่วยให้ทีมไอทีวางแผนอัปเกรดได้ง่ายขึ้น เพราะเวอร์ชันหลักบอกล่วงหน้าว่า API เปลี่ยน ขณะที่การอุดช่องโหว่ของ llama-server เป็นเหตุผลให้ทีมที่เปิดเซิร์ฟเวอร์นี้ให้ผู้ใช้ภายในหลายคนรีบทดสอบและอัปเกรด ผู้ที่ตามเรื่องรันโมเดลเองอ่านเพิ่มได้ที่Self-hosted Claude Managed Agents
บริการของ THAI DATA CLOUD ที่เกี่ยวข้อง
องค์กรไทยที่ต้องการรันโมเดลเปิดบนเซิร์ฟเวอร์ของตัวเองต้องมีผู้ดูแลระบบ อัปเดตซอฟต์แวร์ และเฝ้าระวังช่องโหว่อย่างต่อเนื่อง THAI DATA CLOUD มี Managed Cloud Services ที่ดูแลตั้งแต่ติดตั้ง บริหาร ไปจนถึง Monitoring ระบบคลาวด์ตลอด 24 ชั่วโมง ให้ทีมไอทีภายในโฟกัสงานหลัก (THAI DATA CLOUD เป็นผู้ดำเนินงานเว็บไซต์นี้)
ติดตามข่าว llama.cpp v1.0.0 และซอฟต์แวร์โอเพนซอร์สที่องค์กรไทยใช้ได้ที่หมวดซอฟต์แวร์
คำถามที่พบบ่อย
llama.cpp v1.0.0 ออกเมื่อไร?
llama.cpp v1.0.0 ออกเมื่อวันที่ 13 พฤศจิกายน 2026 บน GitHub ของ ggml-org พร้อม ggml v1.0.0 และบล็อกประกาศจากทีม llama.cpp ที่ Hugging Face ตามเวลาของหน้าปล่อยเวอร์ชัน
llama.cpp v1.0.0 ต่างจากเวอร์ชันก่อนอย่างไร?
llama.cpp v1.0.0 ลบ API ที่เลิกใช้แล้ว (รวม 35 ฟังก์ชันใน llama.h) เพิ่ม FP8 KV cache และ MoE expert cache รองรับสถาปัตยกรรมใหม่ และอุดช่องโหว่ใน llama-server ตามหน้าปล่อยเวอร์ชัน นอกจากนี้ยังเริ่มใช้กติกา semantic versioning ที่ชัดเจน
อัปเกรดเป็น llama.cpp v1.0.0 ต้องระวังอะไร?
ผู้ที่เขียนโค้ดเรียกใช้ libllama ต้องตรวจการลบฟังก์ชันและการย้าย NextN API ไป llama.h เพราะการเปลี่ยนที่ไม่เข้ากันจะเพิ่มเวอร์ชันหลักตามกติกาใหม่ ผู้ที่รัน llama-server ควรตรวจออปชันความปลอดภัยใหม่ที่ปิดไว้เป็นค่าเริ่มต้น
llama.cpp ใช้ทำอะไร?
ทีมโครงการอธิบายว่า llama.cpp ช่วยให้รันโมเดลภาษาแบบหลายโหมดบนฮาร์ดแวร์ตั้งแต่เครื่องผู้ใช้ทั่วไปจนถึงเซิร์ฟเวอร์ระดับองค์กร ด้วยการทำ quantization แบ็กเอนด์ที่ปรับแต่ง และโค้ด C/C++ ที่พกพาได้
แหล่งอ้างอิง
- llama.cpp v1.0.0 release — ggml-org (GitHub)
- llama.cpp v1.0.0: A stronger foundation for the local AI ecosystem — Hugging Face (ทีม ggml-org)
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- GitHub116Hugging Face24Ripple4
- ผลิตภัณฑ์และเทคโนโลยี
- Gemma7Linux151macOS65Windows135Android94Docker57Debian75Model Context Protocol46
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ