
robots.txt ห้ามเทรน AI ด้วยสัญญาณเดียว OpenAI, Google, Anthropic และ Bing เตรียมรองรับ
robots.txt ห้ามเทรน AI กำลังมีสัญญาณกลาง __usage_ai-training OpenAI ประกาศรองรับ 30 ต.ค. 2026 และ Google ตั้งเป้าปี 2027 แต่ยังเป็นร่างและไม่ใช่การบล็อกบอต
โดย กองบรรณาธิการ THAI DATA อ่าน 4 นาที
สรุปประเด็นสำคัญ
- OpenAI ประกาศเมื่อ 30 ตุลาคม 2026 ว่าจะรองรับสัญญาณกลางใน robots.txt สำหรับการเทรน AI ภายในไม่กี่เดือนข้างหน้า โดยเป็นความสมัครใจ
- ร่าง IETF ฉบับ -00 กำหนด token ชื่อ __usage_ai-training ทำให้เจ้าของเว็บแสดงความต้องการต่อผู้ให้บริการหลายรายได้ในจุดเดียว และร่างนี้หมดอายุ 3 พฤษภาคม 2027 ถ้าไม่มีการต่อ
- Search Engine Roundtable รายงานว่า Google, Bing, OpenAI และ Anthropic วางแผนรองรับ โดย Google ตั้งเป้าปี 2027
- สัญญาณนี้แสดงความต้องการ ไม่ใช่คำสั่งห้ามเก็บข้อมูล และกฎ
User-Agent: *เดิมไม่นับเป็นการแสดงความต้องการเรื่องการเทรน AI - ความต้องการที่มีผลคือค่าใน robots.txt ขณะดึงเนื้อหา กฎที่เพิ่มวันนี้จึงไม่ได้ย้อนไปถึงเนื้อหาที่ถูกดึงก่อนหน้า
OpenAI ประกาศเมื่อวันที่ 30 ตุลาคม 2026 ว่าจะรองรับสัญญาณกลางใน robots.txt ห้ามเทรน AI ทำให้เจ้าของเว็บแสดงความต้องการต่อผู้ให้บริการหลายรายได้ในจุดเดียว ไม่ต้องไล่เขียนกฎทีละบอต ระบบยังไม่เริ่มทำงาน และตัวกำหนดเป็นเพียงร่างมาตรฐานของ IETF ที่ส่งเข้ามาในวันเดียวกัน
robots.txt ห้ามเทรน AI แบบใหม่เขียนอย่างไร
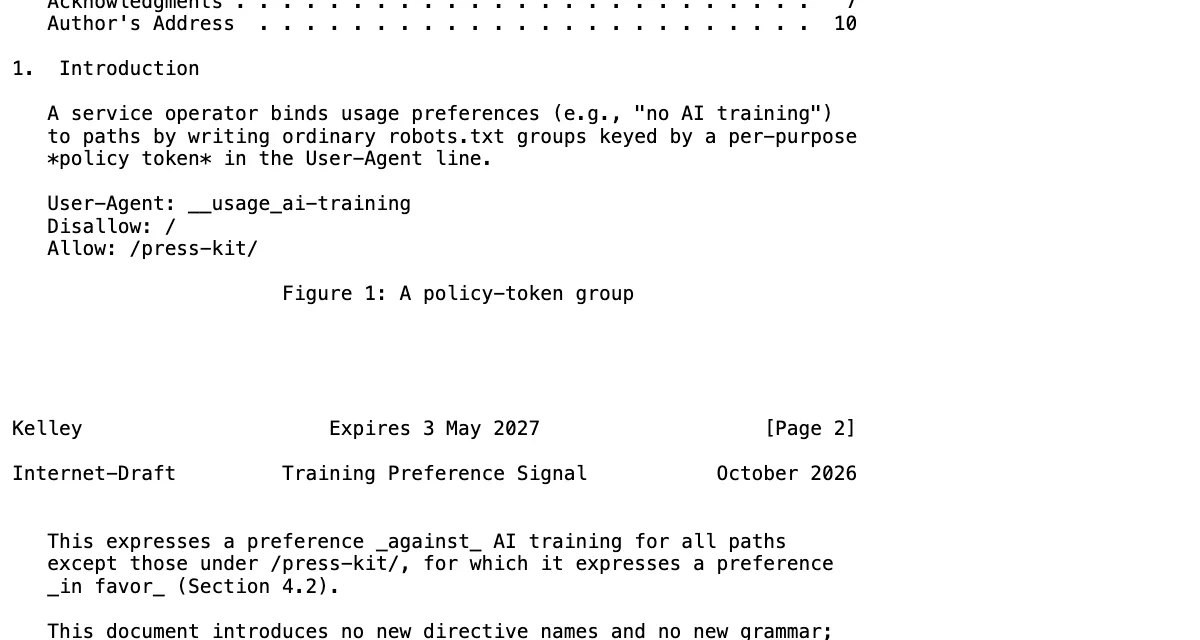
ร่าง Machine-Readable Training Preference Signal ฉบับ -00 เขียนโดย K. Kelley จาก Anthropic ไม่ได้สร้างคำสั่งใหม่ แต่ใช้กลุ่ม robots.txt แบบเดิมกับ token ชื่อ __usage_ai-training
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
ตัวอย่างนี้จากร่างหมายความว่า ไม่ต้องการให้เนื้อหาทั้งเว็บถูกใช้เทรน AI ยกเว้นเส้นทาง /press-kit/ เจ้าของเว็บจึงแยกตามโฟลเดอร์ได้ ไม่ต้องเลือกทั้งเว็บ
robots.txt ห้ามเทรน AI มีผลแค่ไหน
จุดที่ต้องอ่านให้ละเอียดคือ robots.txt ห้ามเทรน AI แบบใหม่บอกความต้องการ ไม่ได้กันบอตออกจากเว็บ
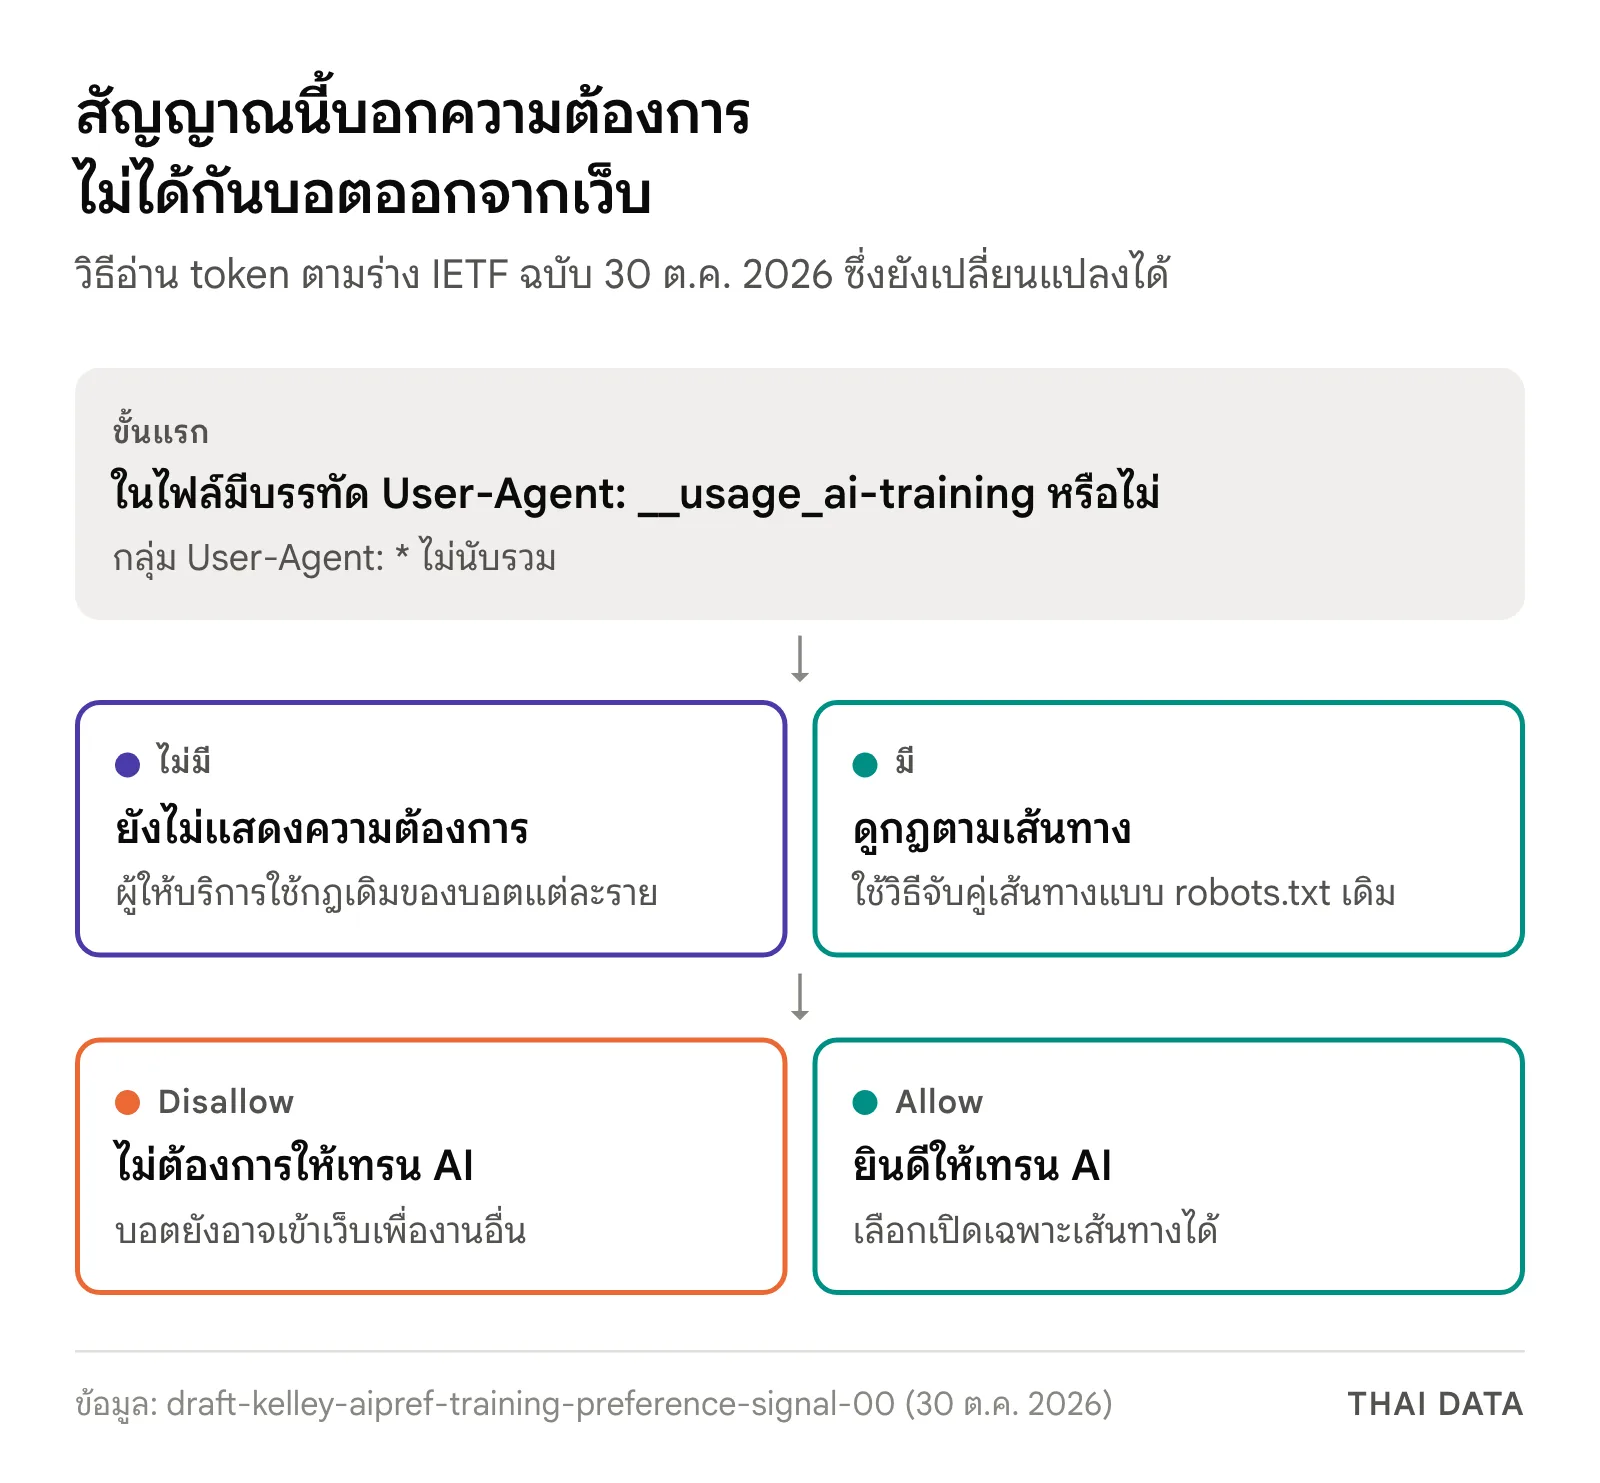
| กรณีในไฟล์ robots.txt | ความหมายตามร่าง |
|---|---|
ไม่มีบรรทัด User-Agent: __usage_ai-training |
ยังไม่แสดงความต้องการ |
มีเฉพาะ User-Agent: * |
ไม่นับ เพราะ wildcard ต้องไม่ตรงกับ token นี้ |
| เส้นทางถูก Disallow ในกลุ่ม token | ไม่ต้องการให้ใช้เทรน AI |
| เส้นทางถูก Allow ในกลุ่ม token | ยินดีให้ใช้เทรน AI |
| มีกฎของบอตเฉพาะราย | ยังมีผลกับการเก็บข้อมูลของบอตนั้นตามเดิม |
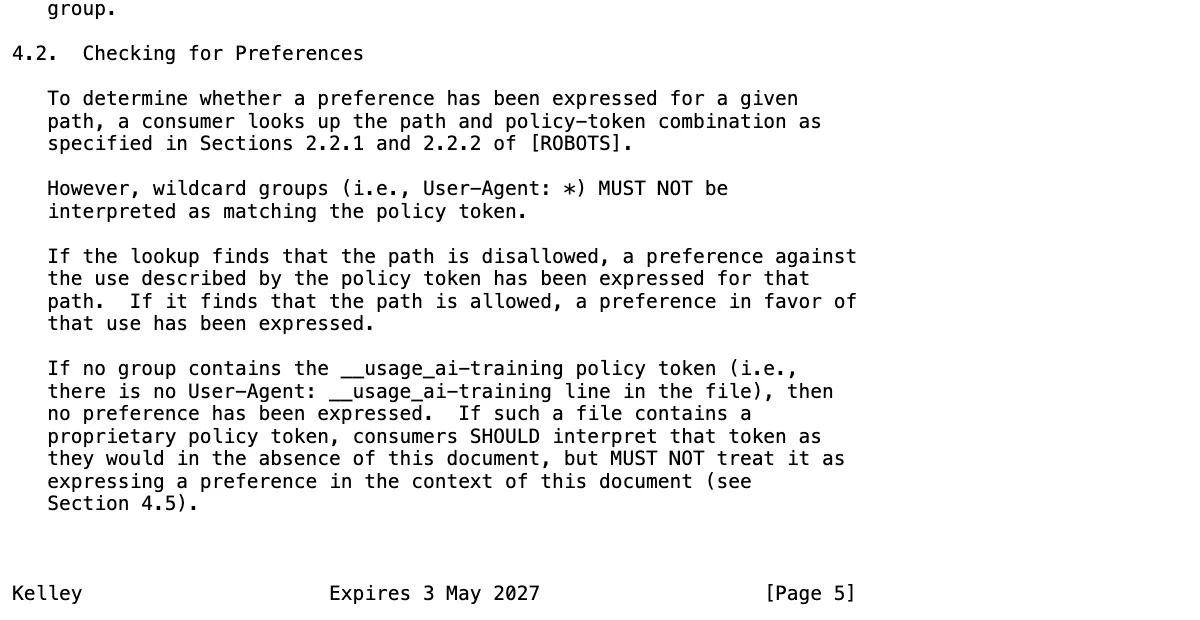
ร่างยังระบุอีก 3 เรื่อง คือคำว่า AI training หมายถึงโมเดล generative ไม่รวมโมเดลที่ใช้เฉพาะการจัดประเภท จัดอันดับ หรือให้คะแนน ข้อตกลงส่วนตัวระหว่างเจ้าของเนื้อหากับผู้ให้บริการอาจมีผลเหนือสัญญาณนี้ และความต้องการที่ใช้คือค่าในไฟล์ขณะดึงเนื้อหา กฎที่เพิ่มวันนี้จึงไม่ได้ย้อนไปถึงเนื้อหาที่ถูกดึงไปก่อนแล้ว
ใครจะรองรับ robots.txt ห้ามเทรน AI และเมื่อไร
| ผู้ให้บริการ | สถานะ ณ 31 ตุลาคม 2026 | กำหนดเวลา |
|---|---|---|
| OpenAI | ประกาศเองว่าจะรองรับ | อีกไม่กี่เดือน และจะแจ้งรายละเอียดอีกครั้ง |
| Search Engine Roundtable อ้างคำชี้แจงของ Google | ตั้งเป้าปี 2027 | |
| Anthropic | พนักงานเป็นผู้เขียนร่าง และ Search Engine Roundtable รายงานว่าร่วมรองรับ | ยังไม่พบกำหนดเวลาในแหล่งที่เราเปิดอ่าน |
| Bing | Search Engine Roundtable รายงานว่าร่วมรองรับ | ยังไม่พบกำหนดเวลาในแหล่งที่เราเปิดอ่าน |
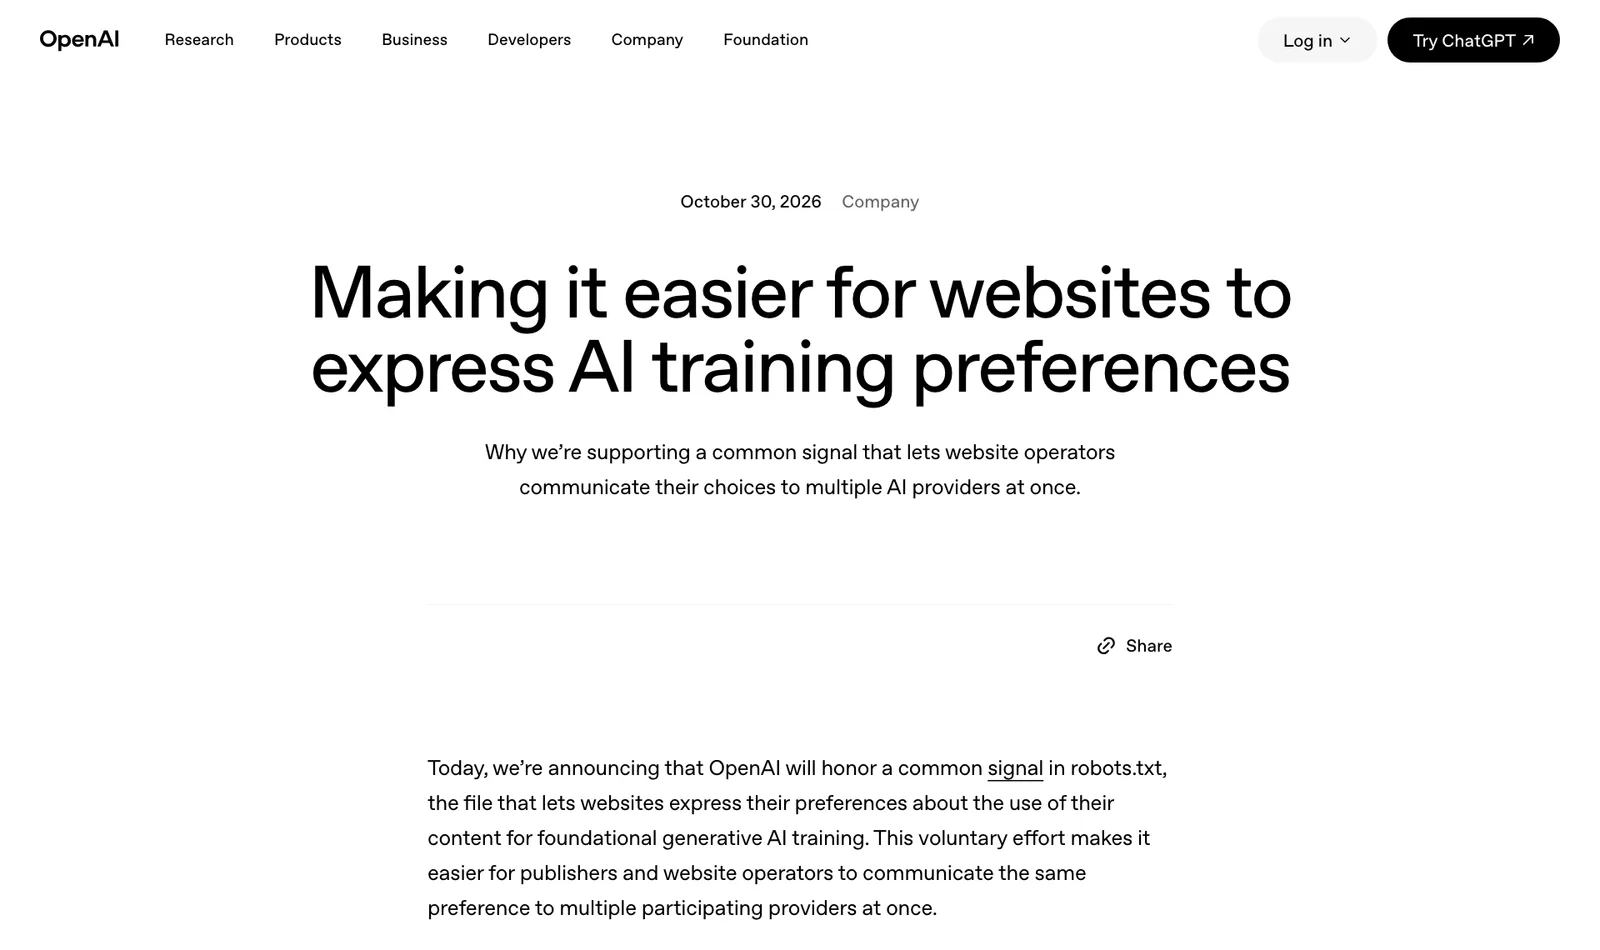
OpenAI ระบุว่าการควบคุมเดิมผ่าน robots.txt ยังใช้ต่อ เช่นเดียวกับ Google ที่ยืนยันว่า Google-Extended ยังทำงานคู่กัน ตามข้อความของ John Mueller ที่ Search Engine Roundtable อ้างถึง ถ้าเว็บห้ามผ่าน token กลางและไม่ได้ระบุ Google-Extended ไว้ Google มีแผนตีความเหมือนห้าม Google-Extended
ข้อความเดียวกันยังระบุว่าเว็บที่อนุญาต Google-Extended อย่างชัดเจนมีสิทธิ์ปรากฏในคำตอบและรับคลิกผ่าน grounding ใน Gemini Apps เจ้าของเว็บจึงควรชั่งน้ำหนักผลต่อการมองเห็นด้วย ไม่ใช่ดูแค่การห้ามเทรน
ทำไมเรื่องนี้สำคัญ
เดิมการตั้ง robots.txt ห้ามเทรน AI ต้องตามรายชื่อบอตของแต่ละบริษัท และไฟล์ก็ยาวขึ้นเรื่อย ๆ เรื่องนี้ใกล้ตัวขึ้นเมื่อ Meta Commercial Terms ฉบับใหม่ทำให้เจ้าของเว็บธุรกิจต้องทบทวนว่าเนื้อหาของตนถูกเก็บไปใช้อย่างไร
ฝั่งกำกับดูแลก็เกี่ยวข้อง ข้อความของ Google ที่ Search Engine Roundtable อ้างถึงระบุว่าแนวทางนี้สอดคล้องกับ EU Code of Practice สำหรับผู้ให้บริการโมเดล GPAI ซึ่งยอมรับ robots.txt เป็นวิธีหลักในการแสดงความต้องการแบบเครื่องอ่านได้ องค์กรที่มีผู้อ่านหรือคู่ค้าในยุโรปจึงควรติดตามเรื่องนี้
ข้อจำกัดคือ robots.txt ห้ามเทรน AI ยังเป็นความสมัครใจ สัญญาณไม่ได้บังคับใช้ทางเทคนิค และผู้ให้บริการที่ไม่เข้าร่วมก็ไม่ต้องทำตาม ร่างฉบับนี้ยังเป็นงานระหว่างทาง จึงไม่ควรนับเป็นมาตรฐานจนกว่า IETF จะเห็นชอบ
ผลต่อองค์กรไทย
- ตัดสินใจเป็นรายโฟลเดอร์ ฝ่ายคอนเทนต์ กฎหมาย และ SEO ควรกำหนดร่วมกันว่าจะใช้ robots.txt ห้ามเทรน AI กับส่วนใด เช่น บทความสมาชิก และส่วนใดเปิด เช่น ข่าวประชาสัมพันธ์
- คงกฎเดิมไว้ก่อน ถ้าใช้กฎ GPTBot หรือ Google-Extended อยู่ อย่าเพิ่งลบ จนกว่าผู้ให้บริการจะประกาศว่าเริ่มใช้ token นี้จริง
- เพิ่มกลุ่มใหม่ได้โดยไม่กระทบระบบเดิม ร่างระบุว่า parser ที่ไม่รู้จัก token จะข้ามกลุ่มนี้ไป แต่ต้องกลับมาตรวจเมื่อร่างเปลี่ยนฉบับ
- ตรวจทุกโดเมนย่อย ไฟล์ robots.txt อยู่ที่รากของแต่ละบริการ เว็บหลัก ร้านค้า และบล็อกจึงต้องตั้งแยกกัน
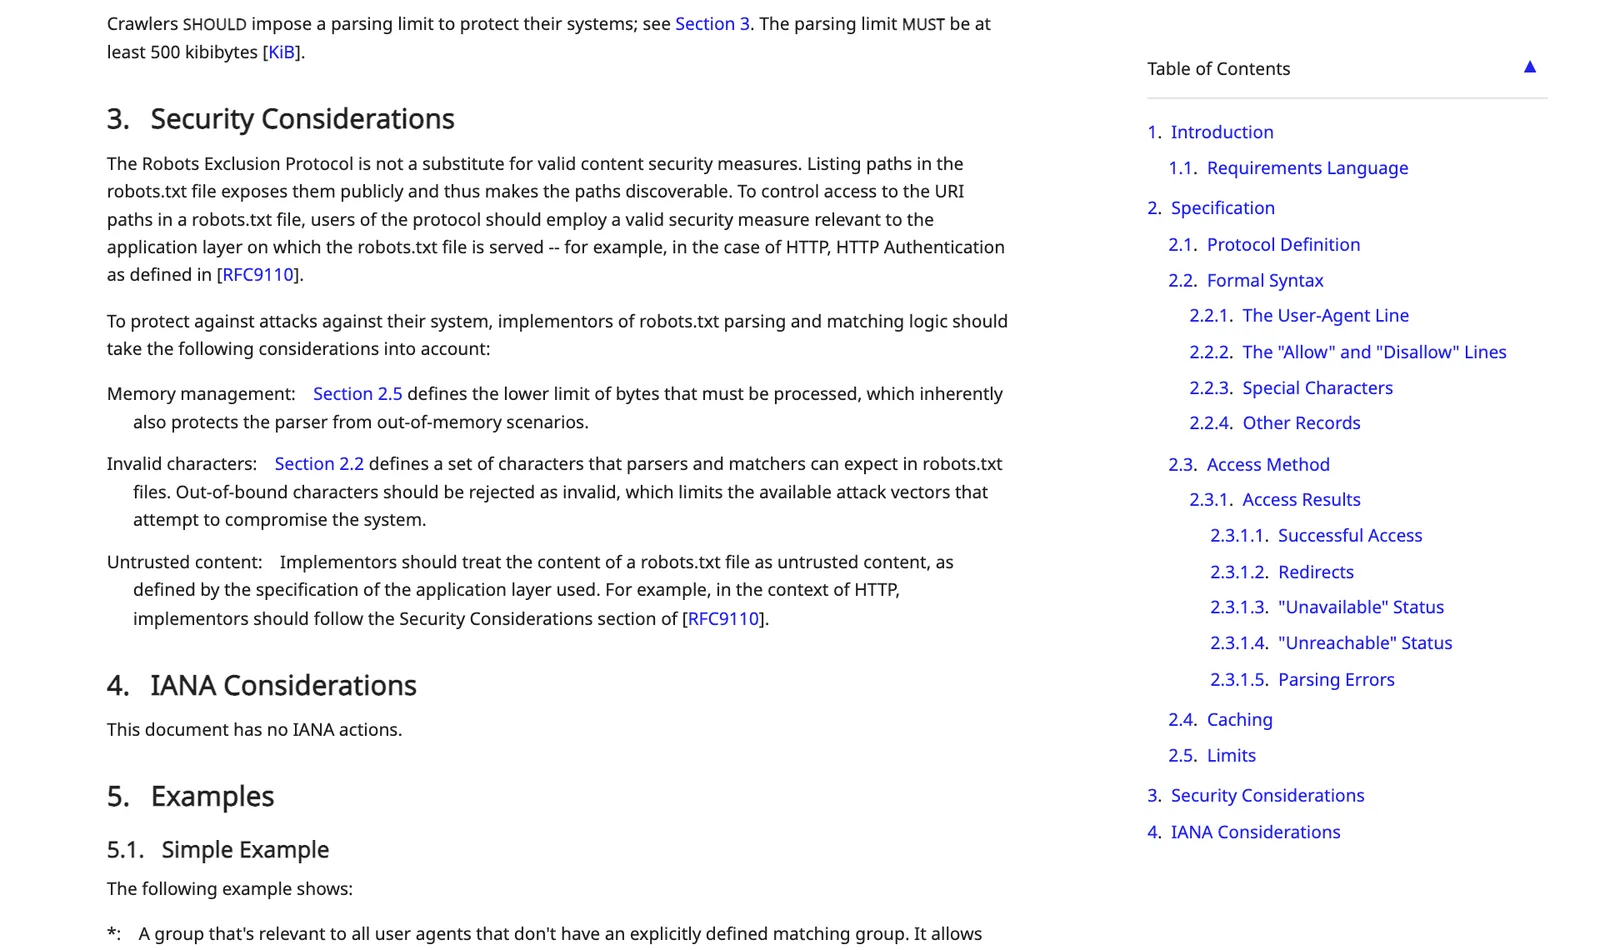
- อย่าใช้ robots.txt ปกป้องข้อมูลส่วนบุคคล RFC 9309 ระบุว่าไฟล์นี้ไม่ใช่มาตรการความปลอดภัย และการระบุเส้นทางยังเปิดเผยเส้นทางนั้นต่อสาธารณะ ข้อมูลที่ไม่ควรเปิดต้องอยู่หลังระบบยืนยันตัวตน
ติดตามความคืบหน้าของ robots.txt ห้ามเทรน AI และข่าวอื่นได้ที่หมวดปัญญาประดิษฐ์
คำถามที่พบบ่อย
robots.txt ห้ามเทรน AI เขียนอย่างไร?
ตามร่าง IETF ฉบับ 30 ตุลาคม 2026 ให้เพิ่มกลุ่ม User-Agent: __usage_ai-training ตามด้วย Disallow: / ถ้าไม่ต้องการให้นำเนื้อหาไปเทรน AI และใช้ Allow กับเส้นทางที่ยินดีให้ใช้ ร่างนี้ยังเปลี่ยนแปลงได้และผู้ให้บริการยังไม่เริ่มใช้จริง
robots.txt ห้ามเทรน AI ใช้ได้เลยหรือยัง?
ยังไม่มีผลจริง OpenAI บอกว่าจะเริ่มใช้ในอีกไม่กี่เดือนข้างหน้า ส่วน Google ตั้งเป้าปี 2027 เจ้าของเว็บเพิ่มกลุ่มนี้ได้เพราะ parser ที่ไม่รู้จักจะข้ามไป แต่ต้องคงกฎเดิมของแต่ละบอตไว้จนกว่าผู้ให้บริการจะประกาศรองรับ
ใส่ User-Agent: * และ Disallow: / ถือว่าห้ามเทรน AI ด้วยหรือไม่?
ไม่ถือ ร่าง IETF ระบุว่ากลุ่ม wildcard ต้องไม่ถูกตีความว่าตรงกับ token นี้ ถ้าไฟล์ไม่มีบรรทัด User-Agent: __usage_ai-training ก็ถือว่ายังไม่ได้แสดงความต้องการผ่านกลไก robots.txt ห้ามเทรน AI แบบใหม่
สัญญาณ robots.txt ห้ามเทรน AI จะบล็อกบอตไม่ให้เข้าเว็บไหม?
ไม่บล็อก ร่างระบุชัดว่า token นี้ไม่ใช่คำสั่งควบคุมการเก็บข้อมูล บอตยังอาจเข้าเว็บเพื่อใช้งานอื่นได้ ถ้าต้องการจำกัดการเข้าถึงต้องตั้งกฎแยกตามชื่อบอต และข้อมูลลับต้องป้องกันด้วยระบบยืนยันตัวตน
Google-Extended กับสัญญาณกลางใช้ร่วมกันอย่างไร?
Search Engine Roundtable อ้างข้อความของ John Mueller จาก Google ว่า ถ้าเว็บใช้ token นี้ห้ามเทรนและไม่ได้ระบุ Google-Extended ไว้ Google มีแผนตีความเหมือนห้าม Google-Extended ส่วนการตั้งค่าเฉพาะของแต่ละบริษัทยังใช้ต่อได้
แหล่งอ้างอิง
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- OpenAI79Google161Anthropic51สหภาพยุโรป81
- ประเทศและสถานที่
- ยุโรป289
- ผลิตภัณฑ์และเทคโนโลยี
- Gemini58
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ