
llm-d 1.0 ออกแล้ว ระบบรัน LLM บน Kubernetes ใต้ CNCF แยกคิวผู้เช่า อัปเกรดไม่หยุดบริการ
llm-d 1.0 รุ่นเสถียรของโครงการโอเพนซอร์สใต้ CNCF สำหรับรัน LLM แบบกระจายบน Kubernetes ออกเมื่อ 20 ต.ค. 2026 เพิ่มคิวแยกผู้เช่า อัปเกรดไม่หยุดบริการ และ API v1
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
- ผู้ร่วมพัฒนาโครงการ llm-d ประกาศ llm-d 1.0 เมื่อ 20 ตุลาคม 2026 โครงการก่อตั้งปี 2025 โดย Red Hat, IBM, Google Cloud, CoreWeave และ NVIDIA ปัจจุบันเป็นโครงการ sandbox ของ CNCF
- ความสามารถใหม่แบ่งเป็น 4 กลุ่ม คือ QoS แบบหลายผู้เช่า, การอัปเกรดแบบ zero-downtime, configuration API v1 และการรับงานแบบรู้จัก session ของ AI Agent
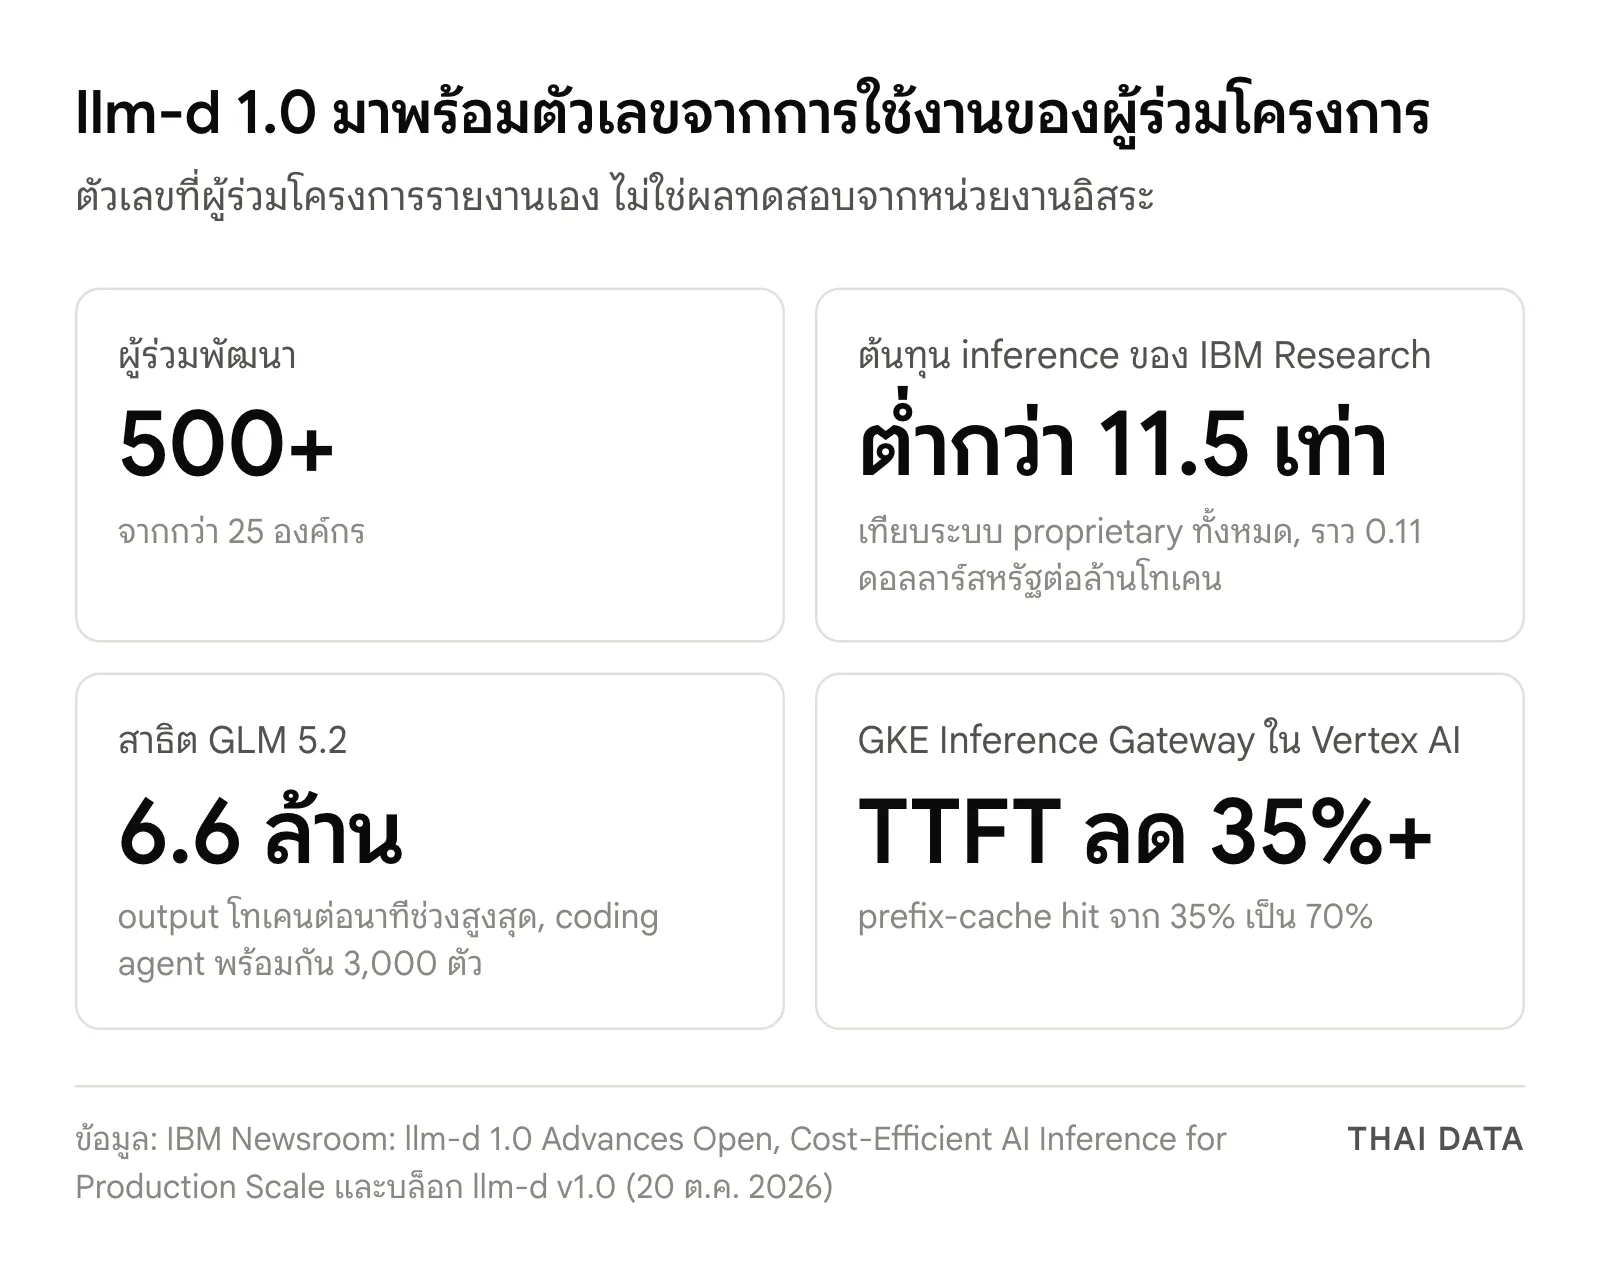
- โครงการมีผู้ร่วมพัฒนามากกว่า 500 คนจากกว่า 25 องค์กร รันบน GPU ของ NVIDIA, AMD, Intel และ Google TPU ผ่าน model server อย่าง vLLM และ SGLang
- Google Cloud กำลังผนวก llm-d 1.0 เข้า GKE และระบุว่า GKE Inference Gateway ที่สร้างบน Endpoint Picker ของ llm-d ลด time-to-first-token ใน Vertex AI ได้มากกว่า 35%
- คู่มือ prefill/decode disaggregation ในรุ่นนี้ต้องใช้ LeaderWorkerSet v0.11.1 ขึ้นไปที่เปิด DisaggregatedSet API และอิมเมจ llm-d-rocm ถูกเลิกพัฒนา
ผู้ร่วมพัฒนาโครงการ llm-d ประกาศรุ่น llm-d 1.0 เมื่อ 20 ตุลาคม 2026 เป็นรุ่นเสถียรแรกของซอฟต์แวร์โอเพนซอร์สสำหรับรัน large language model (LLM) แบบกระจายหลายเครื่องบน Kubernetes จุดเน้นของรุ่นนี้คืองาน "Day 2" หรือการดูแลระบบที่ให้บริการจริง ได้แก่ การแบ่งเครื่องให้หลายผู้เช่า การอัปเกรดโดยไม่หยุดบริการ และการรับงานของ AI Agent
ประกาศที่เผยแพร่ผ่าน IBM Newsroom ระบุว่า llm-d ก่อตั้งปี 2025 โดย Red Hat, IBM, Google Cloud, CoreWeave และ NVIDIA ปัจจุบันอยู่ภายใต้การกำกับของ Cloud Native Computing Foundation (CNCF) ในฐานะโครงการ sandbox มีผู้ร่วมพัฒนามากกว่า 500 คนจากกว่า 25 องค์กร Chris Aniszczyk ซีทีโอของ CNCF กล่าวว่า "AI inference is quickly becoming a core cloud native workload" หรือการรันโมเดล AI กำลังกลายเป็นงานหลักของระบบ cloud native
llm-d 1.0 เพิ่มอะไรสำหรับงาน Day 2
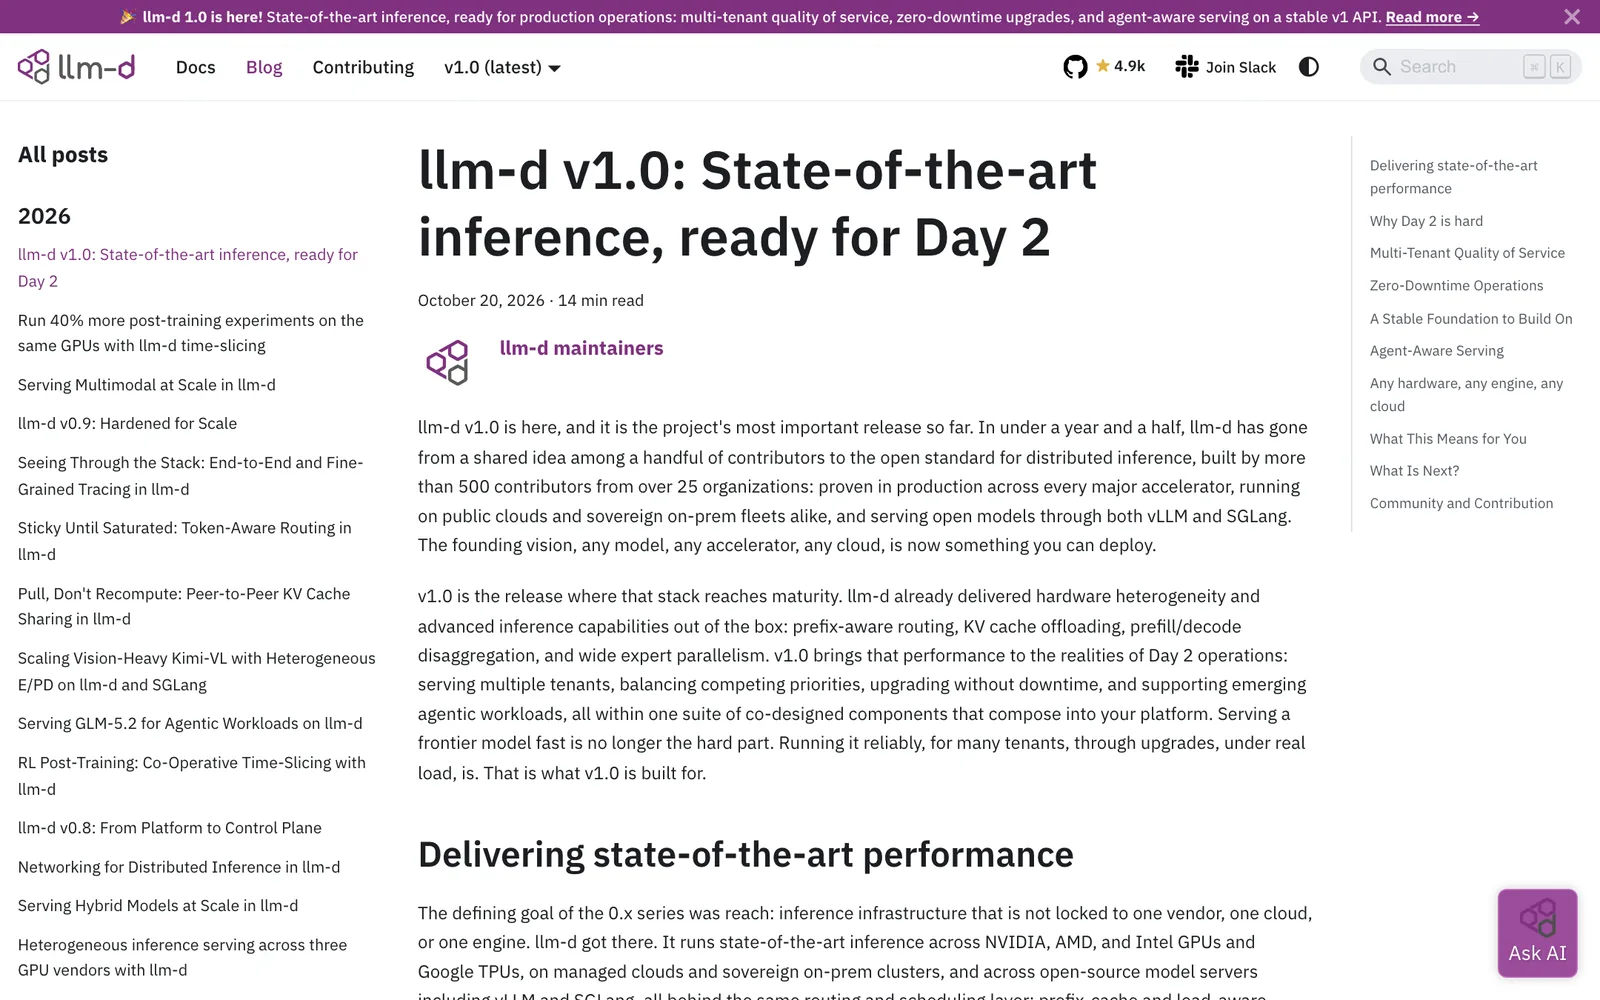
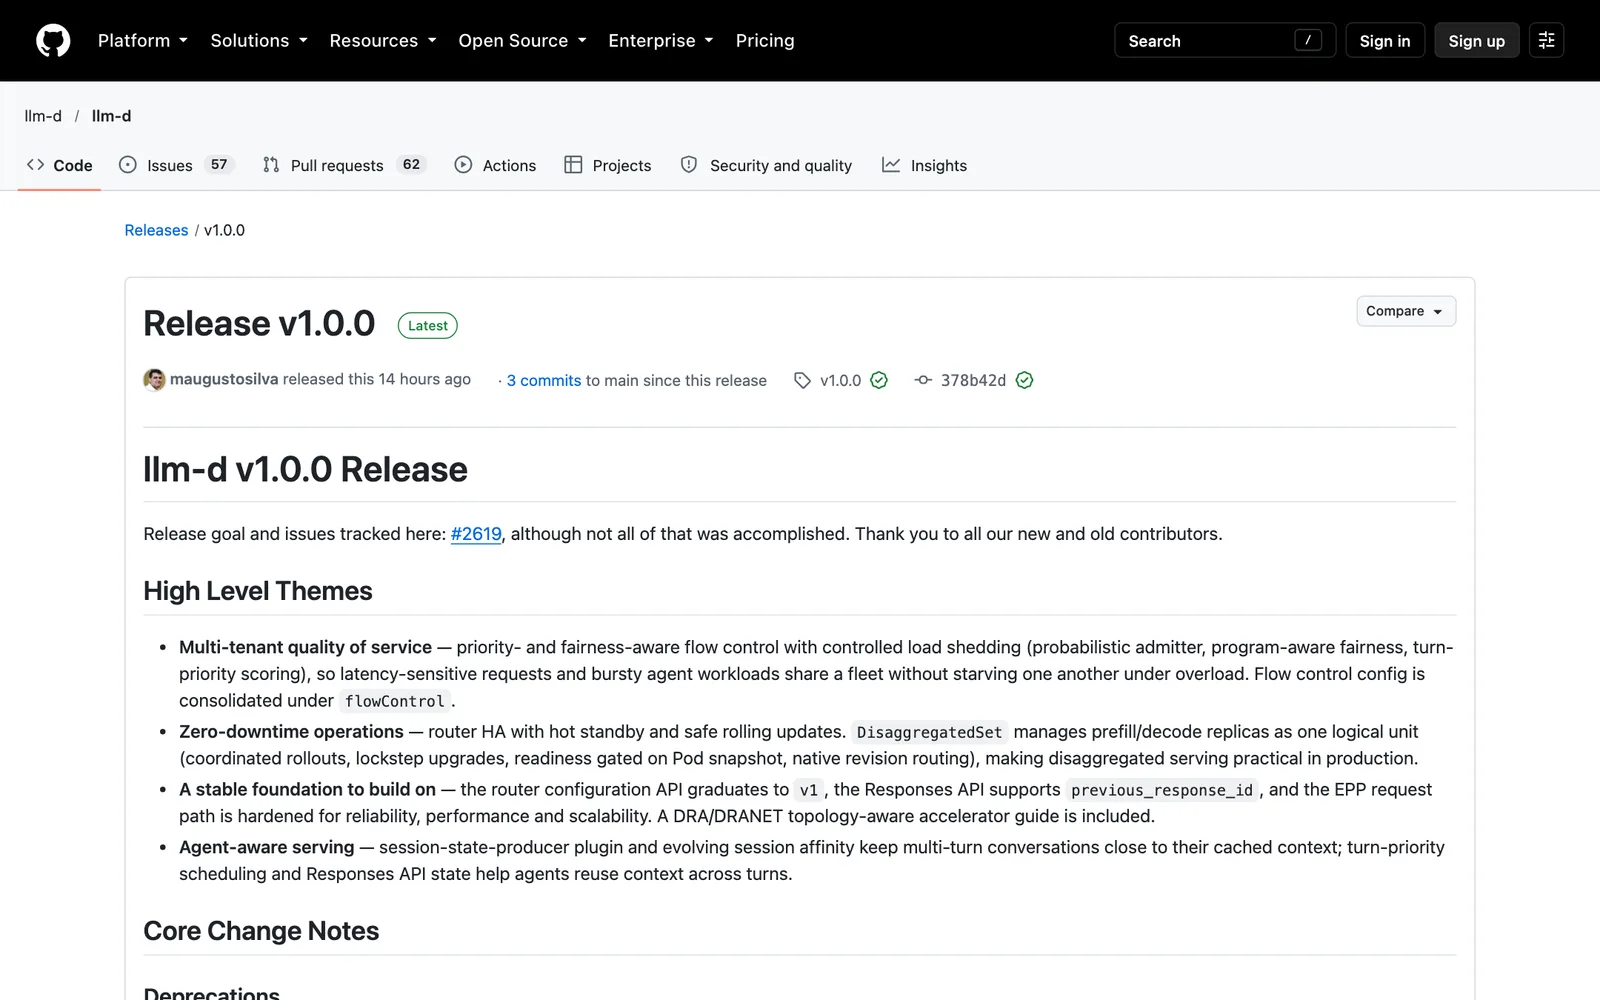
บล็อกของโครงการอธิบายว่ารุ่น 0.x มุ่งให้ llm-d รันได้ทุกฮาร์ดแวร์และทุกคลาวด์ ส่วน llm-d 1.0 มุ่งให้ระบบที่รันอยู่แล้วดูแลได้จริง ความสามารถใหม่แบ่งเป็น 4 กลุ่ม
- QoS แบบหลายผู้เช่า flow control แยกคิวตามผู้เช่าและระดับความสำคัญ จ่ายงานตามลำดับความสำคัญก่อนแล้ววนให้ผู้เช่าในระดับเดียวกันอย่างเป็นธรรม เมื่อเครื่องเต็มจะพักคำขอไว้ที่ router แทนการโยนเข้าคิวที่ล้นอยู่แล้ว และค่าเริ่มต้นยังเป็นแบบมาก่อนได้ก่อน ระบบเดิมจึงไม่เปลี่ยนจนกว่าผู้ดูแลจะเปิดนโยบาย
- อัปเกรดแบบ zero-downtime router มี hot standby รับหน้าที่ต่อทันทีเมื่อตัวหลักถูกแทนหรือล่ม และ DisaggregatedSet ดูแลเครื่อง prefill กับ decode เป็นหน่วยเดียว อัปเกรดพร้อมกันได้โดยไม่ต้องตั้งชุดเครื่องคู่ขนาน
- API ที่เสถียร configuration API ขึ้นเป็น v1 ให้ทีมแพลตฟอร์มสร้างระบบต่อได้โดยไม่ต้องไล่แก้ทุกรุ่น และมีแนวทางจัดวางงานตามตำแหน่งอุปกรณ์ผ่าน Dynamic Resource Allocation (DRA)
- รู้จัก session ของเอเจนต์ routing ส่งคำขอต่อเนื่องของบทสนทนาเดิมกลับไปเครื่องที่มี KV cache อยู่ และรองรับ previous_response_id ของ Responses API เพื่อไม่ต้องส่งประวัติทั้งหมดซ้ำ
llm-d 1.0 รันบนคลาวด์และฮาร์ดแวร์ใดบ้าง
โครงการระบุว่า llm-d 1.0 รันบน GPU ของ NVIDIA, AMD และ Intel และบน Google TPU ทั้งบนคลาวด์สาธารณะและคลัสเตอร์ในองค์กร ผ่าน model server อย่าง vLLM และ SGLang ตัวอย่างการใช้งานที่บล็อกของโครงการรายงานมีดังนี้
| ผู้ให้บริการ | การใช้ llm-d ตามที่โครงการรายงาน |
|---|---|
| Google Cloud | GKE Inference Gateway สร้างบน Endpoint Picker ของ llm-d ลด time-to-first-token ใน Vertex AI มากกว่า 35% และเพิ่ม prefix-cache hit จาก 35% เป็น 70% กำลังผนวก llm-d 1.0 เข้า GKE ทั้ง TPU และ NVIDIA GPU |
| AWS | รัน disaggregated inference บน Amazon SageMaker HyperPod รายงานจำนวนโทเคนต่อวินาทีเพิ่มสูงสุด 70% เทียบกับ vLLM ปกติ |
| DigitalOcean | ใช้เป็นฐานของระบบ inference แบบกระจาย รันโมเดล Kimi K3 บนทั้ง AMD และ NVIDIA |
| Oracle Cloud Infrastructure | รันบนเครื่อง bare-metal AMD MI300X และพัฒนาคู่มือการติดตั้งบน AMD |
| Red Hat | ใช้ llm-d เป็นชั้น inference แบบกระจายใน Red Hat AI ใช้งานทั่วไปบน OpenShift และ Kubernetes แบบ managed รวม Microsoft Azure และ CoreWeave |
ในฝั่งฮาร์ดแวร์ คู่มือของ NVIDIA ครอบคลุม H100, H200, B200, GB200 NVL72 และ GB300 ส่วน AMD มีคู่มือสำหรับ Instinct MI355X และบน Google Cloud TPU ใช้ TorchTPU ภายใน vLLM และ SGLang
ตัวเลขที่ผู้ร่วมโครงการรายงานเอง
ตัวเลขประสิทธิภาพในประกาศมาจากผู้ร่วมโครงการเอง ไม่ใช่ผลทดสอบจากหน่วยงานอิสระ ประกาศของ IBM ระบุว่า IBM Research ใช้ llm-d กับโมเดลเปิดในงานสำรวจฮาร์ดแวร์แก้ข้อผิดพลาดของควอนตัม ได้ต้นทุน inference ต่ำกว่าระบบที่เป็น proprietary ทั้งหมด 11.5 เท่า อัตรา prefix-cache hit ราว 98% และต้นทุนเฉลี่ยราว 0.11 ดอลลาร์สหรัฐต่อล้านโทเคน
การสาธิตอีกชุดใช้ llm-d รันโมเดล GLM 5.2 ขนาดราว 753,000 ล้านพารามิเตอร์ ได้ output สูงสุดกว่า 6.6 ล้านโทเคนต่อนาที รองรับ coding agent พร้อมกันสูงสุด 3,000 ตัวโดยไม่มีการ preempt ประกาศคำนวณว่าด้วยค่าเช่าคลาวด์ปัจจุบัน ต้นทุนต่อโทเคนต่ำกว่าราคา API เชิงพาณิชย์ที่เทียบเท่ากัน 5–10 เท่า ส่วนบล็อกของโครงการระบุว่า IBM Research รัน coding agent พร้อมกันสูงสุด 3,000 ตัวบน NVIDIA H100 จำนวน 544 ตัว
ก่อนอัปเกรดเป็น llm-d 1.0 ต้องรู้อะไร
release notes ของ llm-d 1.0 บน GitHub เผยแพร่เมื่อ 20 ตุลาคม 2026 และมีประเด็นที่ทีมแพลตฟอร์มต้องดูก่อนอัปเกรด
- เลขรุ่นตรงกันทุกคอมโพเนนต์ โครงการใช้โอกาสขึ้น v1.0.0 จัดเลขรุ่นของทุกคอมโพเนนต์ให้ตรงกัน เช่น endpoint picker จาก v0.11.0 เป็น v1.0.0
- LeaderWorkerSet ต้อง v0.11.1 ขึ้นไป คู่มือ prefill/decode disaggregation ต้องเปิด DisaggregatedSet API release notes เตือนว่าคู่มือเกือบทั้งหมดจะใช้ไม่ได้ถ้าต่ำกว่ารุ่นนี้ และแนะนำให้อัปเกรด LeaderWorkerSet เป็น v1.0.0
- เลิกสร้างอิมเมจเอง โครงการทยอยย้ายไปใช้อิมเมจของ vLLM, SGLang และ TRT-LLM โดยตรง และอิมเมจ ghcr.io/llm-d/llm-d-rocm ถูกเลิกพัฒนา
- แยก registry ตามความเชื่อถือ อิมเมจจาก main และรุ่นทางการอยู่บน ghcr.io และลงลายเซ็นด้วย cosign ส่วนอิมเมจจาก pull request อยู่บน quay.io และไม่ได้ลงลายเซ็น (ใช้กับอิมเมจที่สร้างใน repository llm-d/llm-d)
ทำไมเรื่องนี้สำคัญ
ประกาศของ IBM ชี้ว่างานของ AI Agent ใช้และนำ context จำนวนมากกลับมาใช้ซ้ำ การจัดการ context จึงมักกินทรัพยากรมากกว่าการสร้างคำตอบสุดท้าย ต้นทุนการรันโมเดลจึงกลายเป็นโจทย์หลักเมื่อองค์กรนำ AI ขึ้นใช้งานจริง llm-d 1.0 ตอบโจทย์นี้ที่ชั้น Kubernetes ซึ่งทีมแพลตฟอร์มคุ้นเคยอยู่แล้ว แทนการผูกกับบริการของผู้ให้บริการรายเดียว
ผู้ให้บริการหลายรายทั้ง Google Cloud, AWS, Oracle, DigitalOcean และ Red Hat รายงานการใช้ซอฟต์แวร์ชุดเดียวกัน และประกาศระบุว่าการกำกับแบบ CNCF ร่วมกับผู้เข้าร่วมจากทั้งอุตสาหกรรม มุ่งให้ llm-d 1.0 เป็นทางเลือกแบบเปิดสำหรับจัดการโครงสร้าง AI ที่ซับซ้อนขึ้น ส่วนข่าวเครื่องมือ inference โอเพนซอร์สอีกค่ายอ่านได้ที่ DeepSeek DeepInfer
ผลต่อองค์กรไทย
- ทางเลือกสำหรับข้อมูลที่ต้องเก็บเอง องค์กรที่ไม่อยากส่ง prompt ออกไปยัง API ภายนอกรันโมเดลเปิดบน Kubernetes ของตัวเองหรือคลาวด์ที่เลือกได้ สอดคล้องกับแนวทาง PDPA ด้าน AI ของ สคส. ที่ชี้ว่า Prompt และ Log อาจเป็นข้อมูลส่วนบุคคล
- อย่าใช้ตัวเลขในประกาศเป็นงบประมาณ ตัวเลข 5–10 เท่าและ 11.5 เท่ามาจากงานของผู้ร่วมโครงการ ควรวัดกับ traffic และโมเดลของตัวเองบนคลัสเตอร์ทดลองก่อนเทียบกับค่า API ที่จ่ายอยู่
- เตรียมทักษะ Kubernetes เพิ่ม การใช้ llm-d 1.0 ต้องเข้าใจ Gateway API, LeaderWorkerSet และ DRA ทีมที่เริ่มจากศูนย์อ่านพื้นฐานได้ที่ Kubernetes คืออะไร
- ตรวจ GPU ใน region ที่ใช้ คู่มือของ llm-d 1.0 ผูกกับรุ่น GPU และ TPU ที่ทดสอบแล้ว ก่อนวางแผนควรตรวจว่า region ที่ใช้มีเครื่องรุ่นนั้นให้เช่าหรือไม่
- ใช้อิมเมจที่ลงลายเซ็นเท่านั้น ตั้งนโยบายให้คลัสเตอร์ดึงอิมเมจของ llm-d จาก ghcr.io ที่ลงลายเซ็น และติดตามข่าวคลาวด์อื่นได้ที่หมวดคลาวด์
คำถามที่พบบ่อย
llm-d 1.0 คืออะไร?
llm-d 1.0 คือรุ่นเสถียรแรกของ llm-d ซอฟต์แวร์โอเพนซอร์สสำหรับรัน large language model แบบกระจายหลายเครื่องบน Kubernetes ทำหน้าที่ route คำขอ จัดคิว และแยกขั้น prefill กับ decode ไว้หน้า model server อย่าง vLLM และ SGLang ปัจจุบันเป็นโครงการ sandbox ของ CNCF
llm-d 1.0 มีอะไรใหม่บ้าง?
llm-d 1.0 เพิ่ม flow control ที่จัดคิวตามผู้เช่าและระดับความสำคัญ, router แบบ high availability ที่มี hot standby, DisaggregatedSet สำหรับอัปเกรด prefill และ decode พร้อมกัน, configuration API v1 และ routing ที่ส่งคำขอต่อเนื่องของ session เดิมกลับไปเครื่องที่มี KV cache อยู่แล้ว
llm-d 1.0 ใช้กับคลาวด์และฮาร์ดแวร์ใดได้บ้าง?
บล็อกของโครงการระบุว่า llm-d 1.0 รันบน GPU ของ NVIDIA, AMD, Intel และ Google TPU ทั้งบนคลาวด์และคลัสเตอร์ในองค์กร ผู้ให้บริการที่รายงานการใช้งานมี Google Cloud (GKE), AWS (SageMaker HyperPod), DigitalOcean, Oracle Cloud Infrastructure, CoreWeave และ Red Hat OpenShift รวมถึง Azure
ควรอัปเกรดเป็น llm-d 1.0 ทันทีหรือไม่?
ควรทดสอบก่อน เพราะ release notes ของ llm-d 1.0 เตือนว่าคู่มือเกือบทั้งหมดใช้ไม่ได้ถ้า LeaderWorkerSet ต่ำกว่า v0.11.1 และแนะนำให้ใช้ LeaderWorkerSet v1.0.0 อีกทั้งอิมเมจ llm-d-rocm ถูกเลิกพัฒนา องค์กรจึงควรตรวจ release matrix และลองกับ traffic จริงในคลัสเตอร์ทดลองก่อน
แหล่งอ้างอิง
- llm-d 1.0 Advances Open, Cost-Efficient AI Inference for Production Scale — IBM Newsroom
- llm-d v1.0: State-of-the-art inference, ready for Day 2 — llm-d
- Release v1.0.0 · llm-d/llm-d — llm-d (GitHub)
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ