
Recursive Flint โมเดลเขียนโค้ดรันบนแล็ปท็อป 40B ใช้จริง 2.5B แจกน้ำหนัก Apache 2.0
Recursive Flint เปิดตัว 21 ต.ค. 2026 เป็นโมเดล MoE 40B ใช้จริง 2.5B ต่อโทเคน รันบนแล็ปท็อปได้กว่า 125 โทเคนต่อวินาที แจกน้ำหนักบน Hugging Face แบบ Apache 2.0
โดย กองบรรณาธิการ THAI DATA อ่าน 4 นาที
สรุปประเด็นสำคัญ
- สตาร์ตอัป Recursive เปิดตัว Recursive Flint และปล่อยน้ำหนักบน Hugging Face เมื่อ 21 ตุลาคม 2026 ภายใต้สัญญาอนุญาต Apache 2.0
- Flint เป็นโมเดลแบบ mixture-of-experts พารามิเตอร์รวม 39.8 พันล้าน แต่ใช้งานจริงราว 2.5 พันล้าน ต่อโทเคน และรองรับ context ได้ถึง 512k โทเคน (แนะนำไม่เกิน 256k)
- Recursive รายงานคะแนน 74.2% บน SWE-bench Verified, 89.7% บน SWE-bench Pro v2 และ 54.9% บน Terminal-Bench 2.1
- บน MacBook Pro ชิป M4 Pro หน่วยความจำ 48 GB Flint สร้างข้อความได้ 131.22 โทเคนต่อวินาที ผ่าน MLX ส่วนบน NVIDIA RTX Spark ได้ 155.82 โทเคนต่อวินาที ในรูปแบบ NVFP4
- บริษัทบอกว่าทีมเล็กร่วมกับระบบวิจัยอัตโนมัติ Eureka Machine สร้าง Flint ตั้งแต่ศูนย์ภายใน ไม่ถึง 4 เดือน
สตาร์ตอัป Recursive เปิดตัว Recursive Flint เมื่อวันที่ 21 ตุลาคม 2026 เป็นโมเดลเขียนโค้ดแบบ mixture-of-experts (MoE) ที่ออกแบบให้รันบนแล็ปท็อปของนักพัฒนา มีพารามิเตอร์รวมราว 40 พันล้านแต่ใช้งานจริงเพียง 2.5 พันล้านต่อโทเคน บน MacBook Pro ชิป M4 Pro สร้างข้อความได้กว่า 125 โทเคนต่อวินาที และแจกน้ำหนักบน Hugging Face ภายใต้สัญญาอนุญาต Apache 2.0
จุดที่ทำให้ข่าวนี้ได้รับความสนใจมี 2 เรื่อง เรื่องแรกคือโมเดลที่รันในเครื่องได้เร็วระดับนี้ทำให้ทีมพัฒนาเขียนโค้ดด้วย AI ได้โดยไม่ต้องส่งโค้ดออกนอกเครื่องและไม่ต้องจ่ายค่า API อีกเรื่องคือ Recursive บอกว่าระบบวิจัยอัตโนมัติของบริษัทช่วยพัฒนาแทบทุกส่วนของโมเดล
สเปกของ Recursive Flint
ตารางในหน้า model card บน Hugging Face ระบุรายละเอียดดังนี้
| รายการ | ค่า |
|---|---|
| สถาปัตยกรรม | Transformer แบบ decoder-only ชนิด mixture-of-experts |
| พารามิเตอร์รวม | 39.8 พันล้าน (เรียกแบบปัดเศษว่า 40B-A2.5B) |
| พารามิเตอร์ที่ใช้งานต่อโทเคน | ราว 2.5 พันล้าน รวมส่วน output head |
| เลเยอร์ | 49 ชั้น: dense 2 ชั้นและ MoE 47 ชั้น |
| Experts ต่อเลเยอร์ | 256 ตัว เลือกใช้ 6 ตัวต่อโทเคน และมี shared expert ทำงานตลอด |
| Context | บล็อกระบุรองรับถึง 512k โทเคน แนะนำไม่เกิน 256k ส่วน model card ระบุค่าที่ตั้งไว้ 262,144 โทเคน |
| ข้อมูลความรู้ถึง | มิถุนายน 2026 |
| สัญญาอนุญาต | Apache 2.0 |
Flint รองรับข้อความเข้าและออก การให้เหตุผล (reasoning) และการเรียกเครื่องมือหลายรอบในรูปแบบที่เข้ากับ API ของ OpenAI บริษัทวางให้ใช้สำรวจโค้ดเบส แก้บั๊ก เพิ่มฟีเจอร์ และเขียนเทสต์ ตามหน้า model card โมเดลถูกฝึกตั้งแต่ศูนย์ ผ่านทั้งขั้น pretraining, mid-training, supervised fine-tuning และ reinforcement learning ด้วยข้อมูลข้อความ โค้ด การทำตามคำสั่ง และงานแบบเอเจนต์
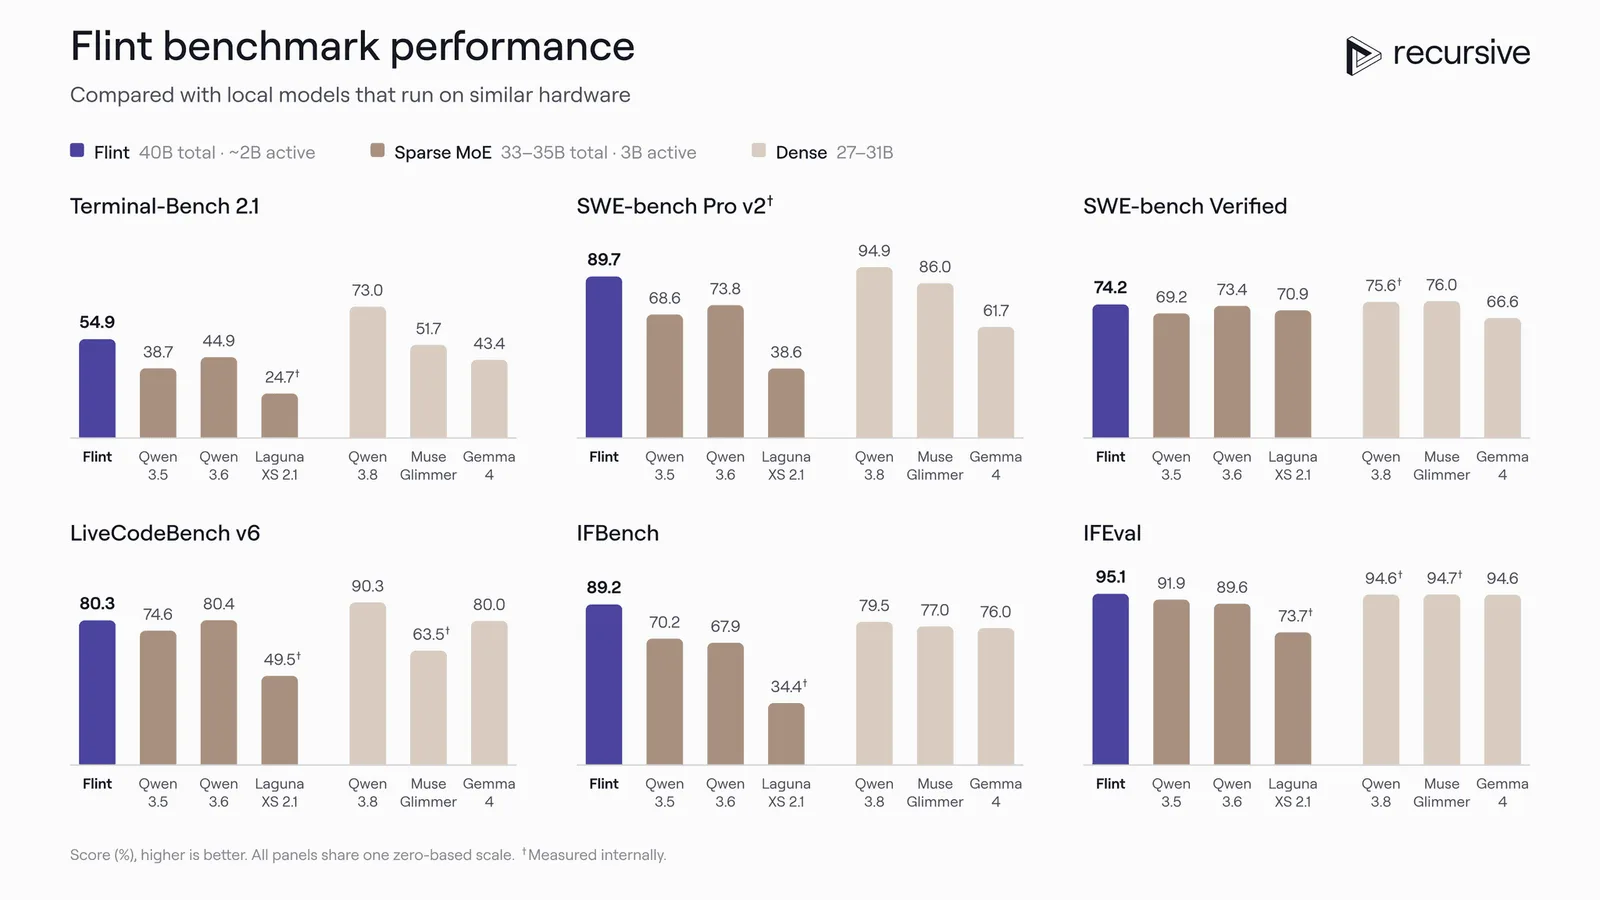
คะแนนของ Recursive Flint เทียบโมเดลที่รันในเครื่อง
Recursive เทียบ Flint กับโมเดลที่รันบนฮาร์ดแวร์ระดับเดียวกัน ทั้งโมเดล MoE ขนาด 33–35 พันล้าน และโมเดล dense ขนาด 27–31 พันล้าน
| ชุดทดสอบ | Flint | Qwen 3.6 (MoE) | Qwen 3.8 (dense) |
|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 44.9 | 73.0 |
| SWE-bench Pro v2 | 89.7 | 73.8 | 94.9 |
| SWE-bench Verified | 74.2 | 73.4 | 75.6 |
| LiveCodeBench v6 | 80.3 | 80.4 | 90.3 |
| IFBench | 89.2 | 67.9 | 79.5 |
| IFEval | 95.1 | 89.6 | 94.6 |
ตัวเลขชุดนี้บอกตรง ๆ ว่า Flint นำโมเดล MoE ขนาดใกล้กันในหลายชุดทดสอบ แต่โมเดล dense บางตัวยังทำคะแนนงานเขียนโค้ดได้สูงกว่า ทั้งหมดเป็นผลวัดของ Recursive เอง และ model card เตือนว่าวิธีวัดของแต่ละแหล่งต่างกัน เช่น คะแนน Terminal-Bench ของ Flint นับคำตอบที่ได้จากการค้นเว็บว่าไม่ผ่าน ขณะที่ตัวเลขที่ผู้พัฒนาอื่นรายงานอาจไม่ได้หักแบบเดียวกัน
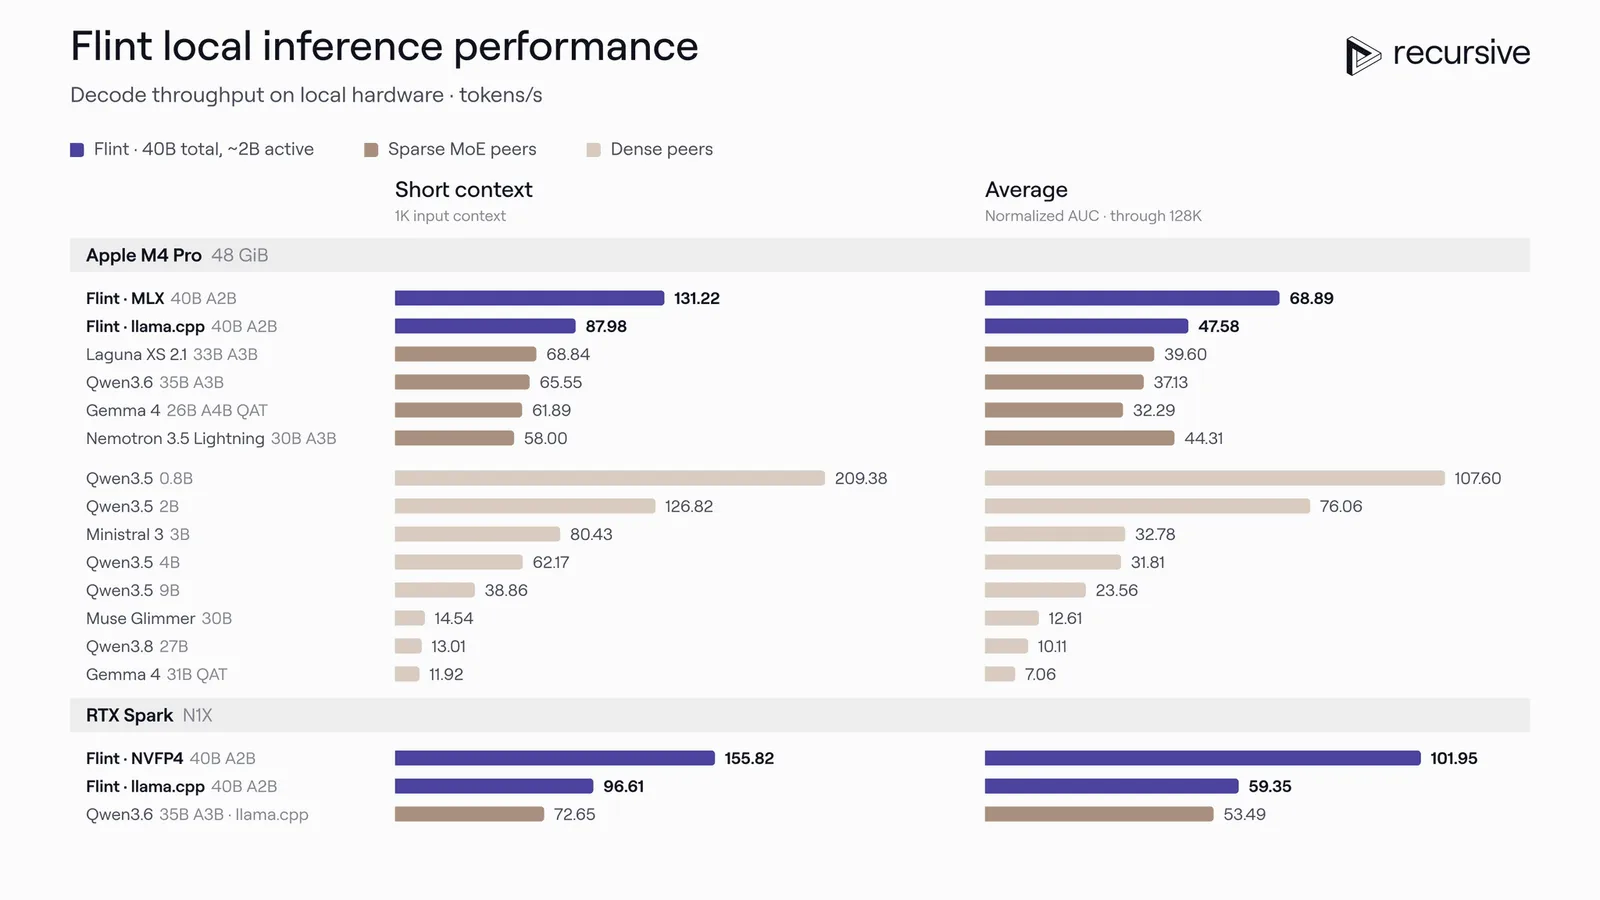
Recursive Flint เร็วแค่ไหนบนเครื่องจริง
จุดขายหลักคือความเร็ว Recursive บอกว่า Flint เร็วกว่าโมเดลในกลุ่มเดียวกันได้ถึง 2 เท่า และเร็วกว่าโมเดล dense ที่คะแนนใกล้กันมากกว่า 5 เท่า กราฟของบริษัทวัดความเร็วการสร้างข้อความที่ context สั้น 1k โทเคนไว้ดังนี้
- MacBook Pro ชิป M4 Pro หน่วยความจำ 48 GB Flint ผ่าน MLX ได้ 131.22 โทเคนต่อวินาที และผ่าน llama.cpp ได้ 87.98 เทียบกับ Qwen 3.8 ขนาด 27B ที่ได้ 13.01
- NVIDIA RTX Spark Flint ในรูปแบบ NVFP4 ได้ 155.82 โทเคนต่อวินาที และผ่าน llama.cpp ได้ 96.61
ความเร็วนี้มาจากการลดจำนวนพารามิเตอร์ที่ใช้ต่อโทเคน การบีบน้ำหนักเป็นรูปแบบ NVFP4 ซึ่งบริษัทบอกว่าคะแนนต่างจากรุ่น 16 บิตไม่เกิน 0.7 คะแนน และ kernel ที่เขียนเฉพาะสำหรับ Apple Silicon กับ RTX Spark Flint ใช้กับ llama.cpp, Ollama, Unsloth, LM Studio, vLLM และ SGLang ได้ และบริษัทเปิดเอนจิน rec สำหรับชิป M4 Pro และ M5 Pro/Max ด้วย
Eureka Machine กับการให้ AI ช่วยสร้างโมเดล
Recursive เป็นบริษัทที่ตั้งเป้าสร้าง AI ที่พัฒนาตัวเองได้ หน้าเว็บของบริษัทระบุว่า Richard Socher เป็น CEO Recursive เรียก Flint ว่าเป็นการทดสอบในงานจริงของ Eureka Machine ระบบที่บริษัทใช้ทำวิจัยอัตโนมัติ ตั้งแต่เสนอไอเดีย ลงมือทำ ทดสอบ แล้วใช้ผลลัพธ์ตัดสินว่าจะลองอะไรต่อ
บริษัทยกตัวอย่างว่า Eureka Machine ค้นโครงสร้าง experts ที่สมดุลระหว่างความเร็วกับคะแนน และเลือกบีบ output layer ลงเหลือ 4 บิตซึ่งต่างจากแนวทางทั่วไป จากนั้นเพิ่มขั้นกลั่นความรู้ (distillation) เพื่อกู้ความแม่นยำ ทีมเล็กของบริษัทใช้ระบบนี้สร้าง Flint ตั้งแต่ศูนย์ภายในไม่ถึง 4 เดือน
ผลต่อองค์กรไทยและทีมพัฒนา
- ทางเลือกสำหรับงานที่ไม่อยากส่งโค้ดออกนอกเครื่อง Recursive Flint รันในเครื่องและใช้ Apache 2.0 จึงเหมาะกับการทดลองในทีมที่มีข้อกำหนดเรื่องข้อมูลหรือสัญญากับลูกค้า แต่ควรทดสอบกับโค้ดของตัวเองก่อนเชื่อตัวเลขของบริษัท
- เริ่มจากเครื่องที่มีอยู่ ทีมที่ใช้ MacBook Pro ชิป M4 Pro หรือเครื่อง RTX Spark ลองผ่าน Ollama หรือ LM Studio ได้ ส่วนไฟล์ BF16 ราว 80 GB ที่ใช้กับชุด SGLang ในหน้า Hugging Face ต้องใช้ GPU ระดับ B300 หรือ H200
- แบ่งงานให้เล็กลง บล็อกของ Recursive แนะนำเองว่า Flint อาจต้องการคำสั่งที่ชัดกว่าโมเดลปิดขนาดใหญ่ งานซับซ้อนควรแตกเป็นงานย่อย
- ตั้งขอบเขตสิทธิ์ของเอเจนต์ model card เตือนว่าโมเดลอาจสร้างโค้ดผิดหรือเรียกเครื่องมือไม่เหมาะสม แอปที่ใช้เครื่องมือต้องกำหนดสิทธิ์และขอบเขตการรันเอง และควรรีวิวการเปลี่ยนแปลงสำคัญก่อนใช้ ติดตามข่าวเครื่องมือนักพัฒนาอื่นได้ที่หมวดการพัฒนาซอฟต์แวร์
คำถามที่พบบ่อย
Recursive Flint คืออะไร?
Recursive Flint คือโมเดลภาษาสำหรับงานเขียนโค้ดแบบเอเจนต์ที่บริษัท Recursive เปิดตัวเมื่อ 21 ตุลาคม 2026 ออกแบบให้รันบนเครื่องของนักพัฒนาเอง เช่น แล็ปท็อปชิป Apple M4 Pro หรือเครื่อง NVIDIA RTX Spark มีพารามิเตอร์รวม 39.8 พันล้านแต่ใช้งานจริงราว 2.5 พันล้านต่อโทเคน และแจกน้ำหนักแบบ Apache 2.0
Recursive Flint ใช้เชิงพาณิชย์ได้ไหม?
น้ำหนักของ Recursive Flint บน Hugging Face ใช้สัญญาอนุญาต Apache 2.0 ซึ่งอนุญาตให้นำไปใช้และดัดแปลงในงานเชิงพาณิชย์ได้ โดยต้องเก็บประกาศลิขสิทธิ์และเงื่อนไขของสัญญาไว้ องค์กรควรให้ฝ่ายกฎหมายตรวจเงื่อนไขก่อนฝังในผลิตภัณฑ์
ต้องใช้เครื่องแบบไหนรัน Recursive Flint?
Recursive ทดสอบความเร็วบน MacBook Pro ชิป M4 Pro หน่วยความจำ 48 GB และ NVIDIA RTX Spark รุ่น 64 GB และบอกว่าใช้กับ llama.cpp, Ollama, LM Studio, vLLM และ SGLang ได้ ส่วนไฟล์ BF16 เต็มขนาดราว 80 GB ที่ใช้กับชุด SGLang ในหน้า Hugging Face ต้องใช้ GPU ระดับ B300 หรือ H200 หนึ่งตัวต่อชุด
Recursive Flint เก่งกว่าโมเดลอื่นที่รันในเครื่องหรือไม่?
ในกราฟของ Recursive Flint ทำคะแนนสูงกว่าโมเดล MoE ขนาดใกล้กันอย่าง Qwen 3.6 ในหลายชุดทดสอบ แต่โมเดล dense ขนาด 27–31 พันล้านบางตัวยังได้คะแนนสูงกว่าในบางชุด จุดเด่นของ Flint คือความเร็ว ซึ่งบริษัทอ้างว่าเร็วกว่าโมเดล dense ที่คะแนนใกล้กันมากกว่า 5 เท่า ตัวเลขทั้งหมดเป็นผลวัดของบริษัทเอง
แหล่งอ้างอิง
- Introducing Flint — Recursive
- RecursiveSI/flint — model card — Hugging Face (Recursive)
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Hugging Face12NVIDIA58Apple47OpenAI57
- ผลิตภัณฑ์และเทคโนโลยี
- MacBook5RTX Spark10vLLM9Qwen6
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ