
Cloudflare เผยเหตุ KV cache รั่วบน Workers AI: GLM-5.3 ตอบปนข้อมูลลูกค้าอื่น 155 ครั้ง
Cloudflare เผย 26 ต.ค. 2026 ว่าเกิด KV cache รั่วในโมเดล GLM-5.3 บน Workers AI ช่วง 27 ส.ค. ถึง 9 ก.ย. คำตอบ 155 ครั้งปนข้อมูลลูกค้าอื่น แก้ด้วยแพตช์ SGLang
โดย กองบรรณาธิการ THAI DATA อ่าน 7 นาที
สรุปประเด็นสำคัญ
- Cloudflare เผยแพร่รายงานเมื่อ 26 ตุลาคม 2026 ว่าโมเดล GLM-5.3 บน Workers AI ส่งคำตอบที่มีข้อมูลจากคำขอของลูกค้ารายอื่นปนอยู่ 155 ครั้ง ระหว่าง 27 สิงหาคมถึง 9 กันยายน 2026
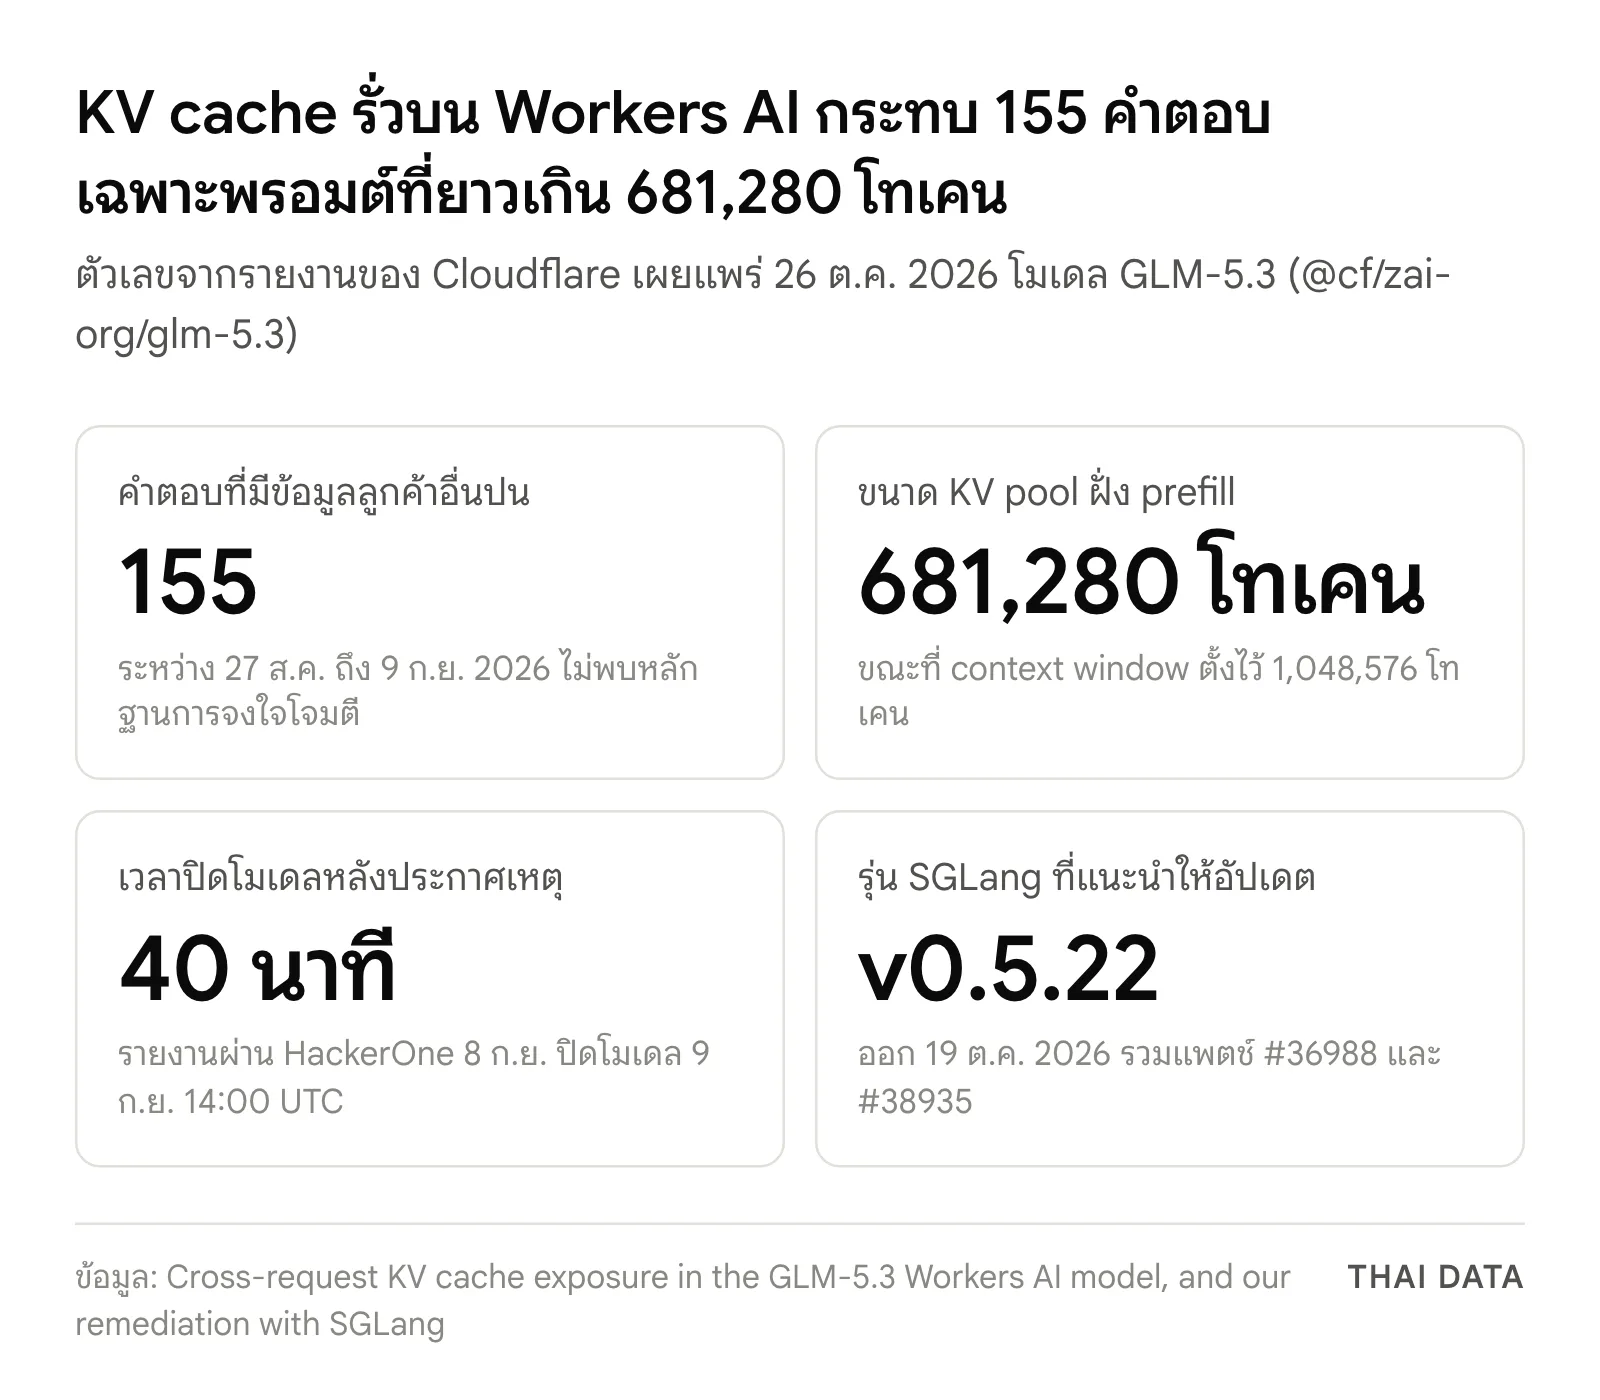
- KV cache รั่วเกิดเฉพาะกับพรอมต์ที่ยาวเกิน 681,280 โทเคน ซึ่งเป็นขนาด KV cache pool ของเครื่อง prefill ขณะที่โมเดลตั้ง context window ไว้ 1,048,576 โทเคน
- นักวิจัย Gadi Evron จาก Knostic แจ้งผ่าน HackerOne เมื่อ 8 กันยายน Cloudflare ปิดโมเดลภายใน 40 นาทีหลังประกาศเหตุ และเปิดให้ใช้ใหม่ในวันเดียวกันเวลา 19:40 UTC
- SGLang ออกแพตช์ในรุ่น v0.5.20, v0.5.21 (2 ต.ค.) และ v0.5.22 (19 ต.ค.) Cloudflare และทีม SGLang แนะนำให้ผู้ที่รันแบบ disaggregated prefill/decode อัปเดตเป็น v0.5.22 ขึ้นไป
- Cloudflare ระบุว่าไม่พบหลักฐานการจงใจใช้ช่อง KV cache รั่วนี้โจมตี และไม่มีโมเดลอื่นบน Workers AI ได้รับผลกระทบ เพราะทุกโมเดลอื่นมี KV pool ใหญ่กว่า context length
Cloudflare เผยแพร่รายงานเมื่อ 26 ตุลาคม 2026 ว่าเกิดเหตุ KV cache รั่วข้ามคำขอในโมเดล GLM-5.3 บน Workers AI ระหว่าง 27 สิงหาคมถึง 9 กันยายน 2026 คำตอบ 155 ครั้งมีข้อมูลจากคำขอของลูกค้ารายอื่นที่ส่งเข้ามาก่อนหน้าไม่นานปนอยู่ ทั้งหมดเป็นพรอมต์ที่ยาวเกิน 681,280 โทเคน บริษัทระบุว่าไม่พบหลักฐานการจงใจโจมตี และไม่มีโมเดลอื่นบน Workers AI ได้รับผลกระทบ
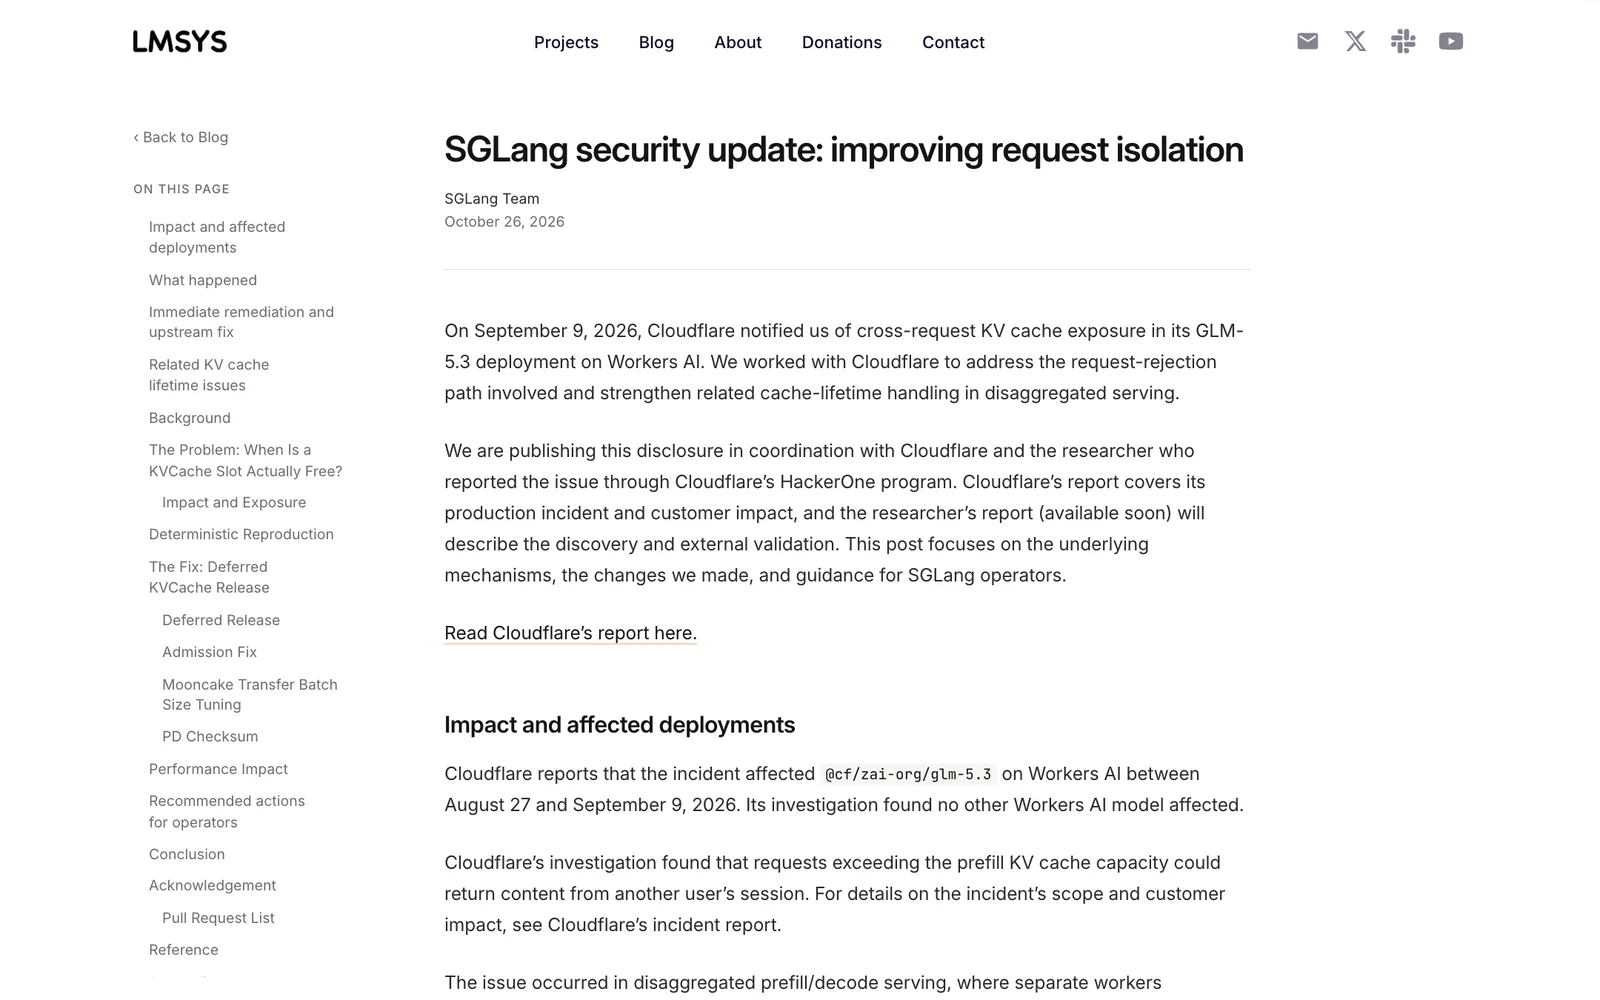
รายงานเหตุ KV cache รั่วนี้เผยแพร่พร้อมกับบทความของทีม SGLang ซึ่งเป็น inference engine โอเพนซอร์สที่ Cloudflare ใช้ เป็นการเปิดเผยแบบประสานงานร่วมกับนักวิจัยผู้แจ้งเหตุ Cloudflare เล่าทั้งสาเหตุ ไทม์ไลน์ และการแก้ไขที่ส่งกลับเข้าโครงการต้นน้ำ ซึ่งเป็นบทเรียนตรงสำหรับทุกองค์กรที่รันโมเดลภาษาขนาดใหญ่แบบหลายผู้เช่าบน GPU ร่วมกัน
เหตุ KV cache รั่วเกิดขึ้นได้อย่างไร
Gadi Evron นักวิจัยจาก Knostic ส่งรายงานผ่านโครงการ HackerOne ของ Cloudflare เมื่อ 8 กันยายน 2026 ว่าพรอมต์ที่ยาวมากซึ่งส่งไปยัง @cf/zai-org/glm-5.3 บางครั้งได้ข้อความที่เป็นของเซสชันผู้ใช้รายอื่นกลับมา Cloudflare ทำซ้ำได้ในเช้าวันถัดไป และนำโมเดลออกจากระบบภายใน 40 นาทีหลังประกาศเหตุ จากนั้นติดตั้งคอนฟิกที่แก้แล้วพร้อม engine ที่แพตช์ และเปิดบริการคืนในวันเดียวกัน
Workers AI รัน GLM-5.3 ด้วย SGLang ในโหมด disaggregated คือมี GPU กลุ่มหนึ่งทำหน้าที่ prefill ประมวลผลพรอมต์แล้วสร้าง KV cache ก่อนส่งผ่าน RDMA ไปยัง GPU อีกกลุ่มที่ทำหน้าที่ decode สร้างคำตอบ KV cache บน GPU เป็นพูลของหน้าหน่วยความจำขนาดคงที่ที่ใช้ร่วมกัน คำขอใหม่จะเขียนทับหน้าเดิมโดยไม่ล้างค่าก่อน engine จึงต้องติดตามความเป็นเจ้าของหน้าหน่วยความจำให้ถูกต้องเสมอ
สาเหตุของ KV cache รั่ว: คอนฟิกไม่ตรงและบั๊กใน SGLang
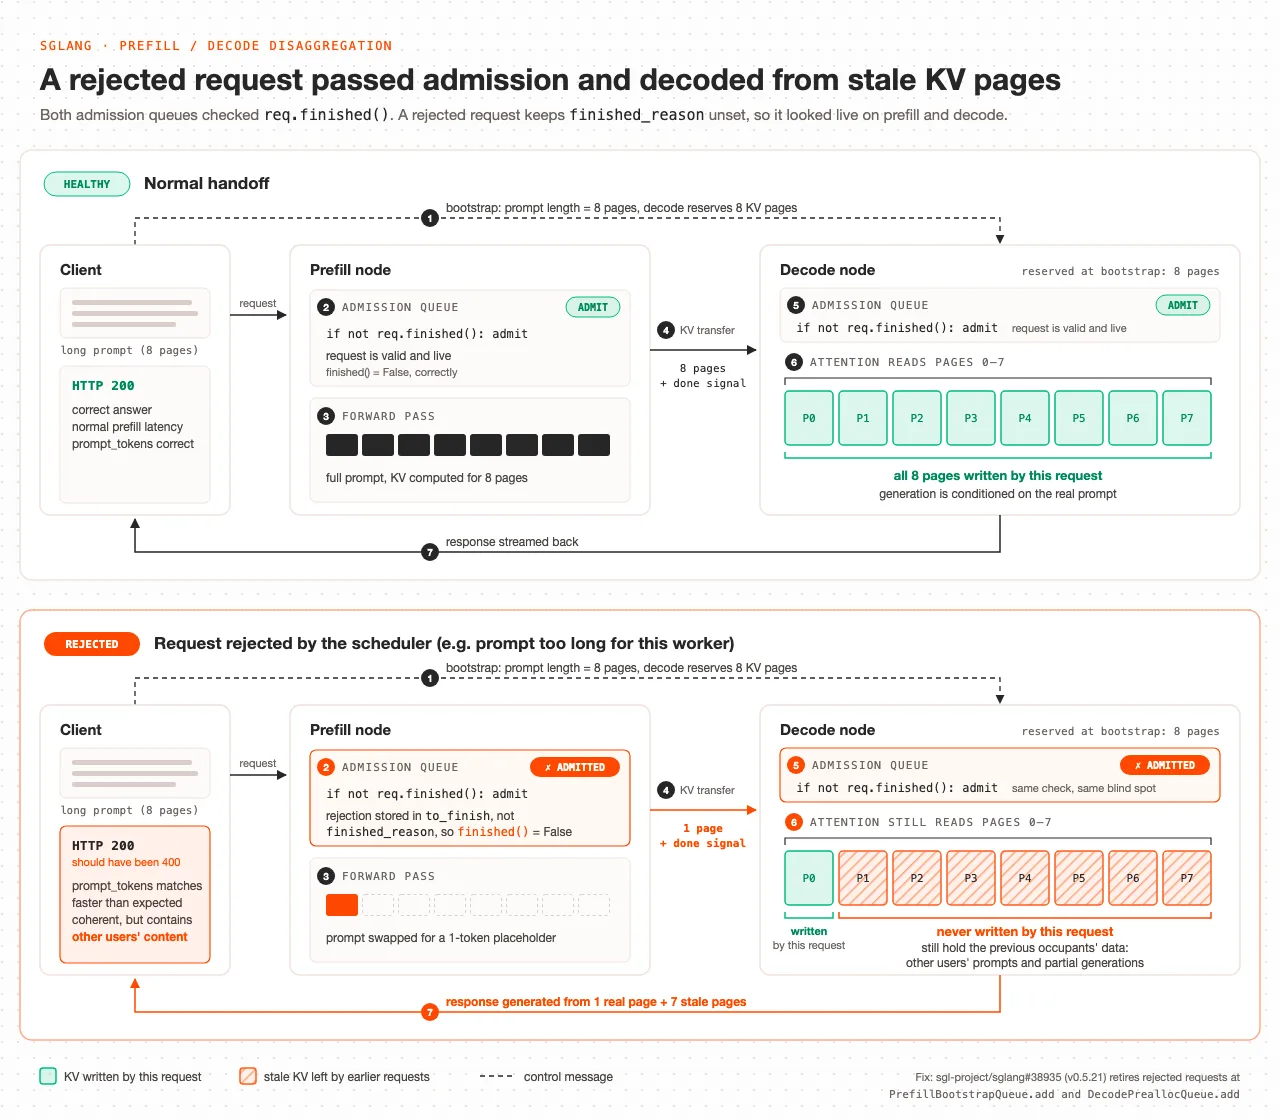
ต้นตอของ KV cache รั่วชั้นแรกเป็นการตั้งค่าของ Cloudflare เอง GLM-5.3 ถูกตั้ง context window ไว้ 1,048,576 โทเคน แต่ KV cache pool บนเครื่อง prefill มีที่ว่างเพียง 681,280 โทเคน ขนาดพูลนี้ไม่ใช่ค่าที่ตั้งได้โดยตรง SGLang คำนวณตอนเริ่มระบบจากหน่วยความจำ GPU ที่เหลือหลังโหลดน้ำหนักโมเดล ทีมงานรู้ว่าตัวเลขไม่ตรงกันตั้งแต่ก่อนเปิดใช้ แต่การทดสอบพรอมต์ยาวได้รหัสตอบกลับสำเร็จ จึงเข้าใจว่า engine จัดการส่วนต่างได้เอง Cloudflare ยอมรับว่าช่องว่างสำคัญของการทดสอบคือตรวจแค่รหัส HTTP และประสิทธิภาพ ไม่ได้ตรวจเนื้อหาคำตอบ
ชั้นที่สองคือบั๊กของ SGLang ในโหมด disaggregated เมื่อพรอมต์ยาวเกินพูล ตัวจัดคิวจะทำเครื่องหมายว่าปฏิเสธและแทนพรอมต์ด้วย placeholder ขนาด 1 โทเคน บนเครื่องเดียวกระบวนการนี้จบด้วยการส่ง error กลับผู้ใช้ตามปกติ แต่ในโหมดแยกเครื่อง คิวรับเข้าของทั้ง prefill และ decode ตรวจว่าคำขอ "เสร็จแล้วหรือยัง" ไม่ได้ตรวจว่า "ถูกปฏิเสธหรือไม่" คำขอที่ถูกปฏิเสธจึงผ่านเข้าไป prefill ส่ง KV cache เพียง 1 หน้าแล้วแจ้งว่าโอนเสร็จ ส่วน decode ซึ่งจองหน้าไว้ตามความยาวพรอมต์จริงจึงอ่านหน้าที่เหลือซึ่งยังมีพรอมต์และคำตอบบางส่วนของผู้ใช้รายอื่นค้างอยู่ ผู้ใช้ได้ HTTP 200 แทน 400 พร้อมคำตอบที่อ่านรู้เรื่องแต่มีข้อมูลคนอื่นปน
Cloudflare พบระหว่างสอบสวนว่าบั๊กที่ทำให้ KV cache รั่วนี้เคยมีผู้ใช้รายอื่นรายงานต่อ SGLang ไว้แล้วเป็น issue #30233 เมื่อ 6 กรกฎาคม 2026 และระบุว่า GLM-5.3 เป็นโมเดลเดียวที่ได้รับผลกระทบ เพราะโมเดลอื่นทุกตัวบน Workers AI มี KV pool ใหญ่กว่า context length ทั้งฝั่ง prefill และ decode
ไทม์ไลน์เหตุ KV cache รั่วจากเปิดโมเดลถึงเปิดเผยร่วมกัน
| วันเวลา (UTC) | เหตุการณ์ |
|---|---|
| 27 ส.ค. 2026 | เปิด GLM-5.3 บน Workers AI โดย KV pool ฝั่ง prefill เล็กกว่า context window |
| 8 ก.ย. 23:11 | ได้รับรายงานผ่าน HackerOne |
| 9 ก.ย. 13:22 | ประกาศเหตุด้านความปลอดภัย ทีม Product Security ทำซ้ำได้ด้วยสองบัญชีภายใน 25 นาที |
| 9 ก.ย. 14:00 | ปิด GLM-5.3 เป็นส่วนตัว คำขอได้ HTTP 400 และอัปเดตหน้าสถานะ |
| 9 ก.ย. 14:35 | ระบุสาเหตุว่า pool ฝั่ง prefill เล็กกว่า context length |
| 9 ก.ย. 19:40 | เปิดโมเดลคืนหลังติดตั้งคอนฟิกใหม่และแพตช์ engine ที่ทดสอบกับสคริปต์ของนักวิจัยแล้ว |
| 10 ก.ย. | ประชุมกับผู้ดูแล SGLang (RadixArk) ตกลงแนวทางแก้ต้นน้ำ |
| 2 ต.ค. และ 19 ต.ค. | SGLang ออก v0.5.21 และ v0.5.22 |
| 26 ต.ค. 2026 | เผยแพร่รายงานพร้อมกันกับนักวิจัยและ RadixArk |
Cloudflare ปิดช่อง KV cache รั่วอย่างไร
Cloudflare ปิดช่อง KV cache รั่วสองทาง ทางแรกปรับคอนฟิก GLM-5.3 ให้เหมือน GLM-5.2 ซึ่งคืนหน่วยความจำ GPU จน KV pool ฝั่ง prefill รองรับได้ราว 2.04 ล้านโทเคน ประมาณสองเท่าของ context length พรอมต์ที่อยู่ในกรอบจึงอยู่ในพูลเสมอ ทางที่สองแพตช์ engine ให้คำขอที่ถูกปฏิเสธถูกยุติที่คิวรับเข้าพร้อม error เดิม ก่อนจะมีการจองหรือโอน KV ใด ๆ และให้ฝั่ง decode ตรวจว่าจำนวนโทเคนที่โอนมาตรงกับที่จองไว้
ในฝั่งโครงการต้นน้ำ SGLang รวมการแก้ไขไว้ในหลายรุ่น #36988 ใน v0.5.20 ยุติคำขอที่ถูกยกเลิกก่อนผลไปถึง decode ซึ่งหยุด KV cache รั่วในเหตุนี้โดยตรง #38935 ใน v0.5.21 ปฏิเสธคำขอตั้งแต่ขั้นรับเข้าตามแนวทางของ Cloudflare และมีการแก้ race condition เรื่องการคืนหน้า KV ก่อนการโอนผ่าน RDMA เสร็จ รวมถึงเปิด deferred KV release เป็นค่าเริ่มต้น บทความของทีม SGLang ระบุว่า v0.5.21 ซึ่งออก 2 ตุลาคม 2026 คุ้มครองการติดตั้งแบบ Mooncake และ NIXL โดยค่าเริ่มต้น ส่วน MORI ต้องใช้รุ่นที่มี #37077 และ #41128 คือ v0.5.22 และระบุว่าไม่มีการ backport ไปรุ่นเก่า
เวอร์ชัน SGLang ที่ต้องอัปเดตและคำแนะนำสำหรับผู้รันเอง
คำแนะนำสำหรับผู้ที่รัน SGLang แบบ disaggregated เพื่อกัน KV cache รั่วจากทั้งสองฝ่ายสรุปได้ดังนี้
- วัดขนาด KV pool จาก log ตอนเริ่มระบบเทียบกับ context length บนทุกเครื่อง prefill และ decode ทุกครั้งที่เปลี่ยนน้ำหนักโมเดล quantization หรือการแบ่งขนาน ถ้าพูลเล็กกว่าให้ลด context length ลง
- อัปเดตเป็นรุ่นที่มี #36988 และ #38935 คือ v0.5.22 ขึ้นไป เพื่อให้คำขอที่ยาวเกินถูกปฏิเสธก่อนส่งต่อ
- เปิด deferred KV release ทั้งสองฝั่ง และจำกัดขนาด batch ของการโอนผ่าน Mooncake ผู้ที่ยังอยู่ v0.5.19 หรือ v0.5.20 ตั้ง SGLANG_DISAGGREGATION_DEFERRED_DECODE_KV_RELEASE=1 ได้ชั่วคราวแต่ไม่ทดแทนการอัปเดต
- เปิดการตรวจ checksum ของ KV ที่โอน (--disaggregation-enable-kv-checksum) และ KV canary เมื่อสถาปัตยกรรมโมเดลรองรับ แล้วตรวจ log ว่าคำขอถูกตรวจจริง
- ตั้งค่า load balancer ไม่ให้ยกเลิกคำขอกลางทางเมื่อผู้ใช้ตัดการเชื่อมต่อ เพื่อลดการ abort ที่ต้องประสานข้ามเครื่อง
ทำไมเหตุ KV cache รั่วครั้งนี้สำคัญ
Cloudflare จัดบั๊ก KV cache รั่วนี้อยู่ในกลุ่มปัญหาความปลอดภัยหน่วยความจำของ KV cache ที่บริษัททำงานร่วมกับ SGLang มาหลายเดือน แก่นของปัญหาคือหน้าหน่วยความจำถูกคืน นำกลับมาใช้ หรือถูกอ่านขณะที่ยังมีผู้ถืออยู่ ไม่ว่าจะเป็นงานหลายอย่างบนเครื่อง decode ที่ถือหน้าเดียวกัน หรือการยกเลิกคำขอขณะ prefill ยังเขียนผ่าน RDMA ไม่เสร็จ ผลที่ตามมาคือ KV cache รั่วแบบเดียวกัน คำตอบเพี้ยนหรือมีข้อมูลผู้ใช้อื่นปนโดยไม่มี error แจ้ง
สิ่งที่บริษัทมองว่าเป็นคำตอบระยะยาวคือให้ engine ตรวจตอนอ่านว่าคำขอกำลังจะอ่านหน้าที่ตัวเองไม่ได้เป็นเจ้าของหรือไม่ แล้วทำให้คำขอนั้นล้มเหลวแทนที่จะส่งข้อมูลคนอื่นออกไป Cloudflare สร้างต้นแบบที่ติดป้ายกำกับทุกหน้า KV ซึ่งเสียประสิทธิภาพต่ำกว่า 1% ในการทดสอบ แต่ยังผูกกับ backend เฉพาะจึงทำงานร่วมกับทีม SGLang เพื่อทำเป็นเวอร์ชันโปรดักชันที่ใช้ได้ทุกโมเดล และเริ่มใช้วิธีพิสูจน์เชิงรูปนัย (formal verification) กับโปรโตคอลโอน KV cache ผ่าน RDMA เช่นเดียวกับที่เคยใช้กับระบบ DNS ของบริษัท
เหตุการณ์นี้ยังสะท้อนว่าการแบ่งเครื่อง prefill และ decode เพื่อประสิทธิภาพ ซึ่งเป็นแนวทางที่ระบบ inference สมัยใหม่ใช้กันรวมถึง llm-d บน Kubernetes ทำให้ขอบเขตความเป็นเจ้าของหน่วยความจำกระจายไปหลายเครื่อง และต้องการการตรวจสอบที่เข้มกว่าการรันบนเครื่องเดียว
ผลต่อองค์กรไทยและสิ่งที่ควรทำ
- ผู้ใช้ Workers AI ที่เรียก GLM-5.3 ด้วยพรอมต์ยาวมากในช่วง 27 สิงหาคมถึง 9 กันยายน 2026 ควรทบทวนว่าคำตอบในช่วงนั้นถูกนำไปใช้ต่อที่ใด เพราะอาจมีข้อความของผู้ใช้รายอื่นปน และตรวจว่าพรอมต์ของตนเองมีข้อมูลส่วนบุคคลหรือความลับทางธุรกิจที่อาจไปปรากฏในคำตอบของผู้อื่นหรือไม่ เพื่อประเมินหน้าที่แจ้งเหตุตามนโยบายขององค์กร
- องค์กรที่รัน SGLang เอง โดยเฉพาะแบบ disaggregated prefill/decode ควรอัปเดตเป็น v0.5.22 ขึ้นไปทันทีเพื่อปิดช่อง KV cache รั่ว และเพิ่มการตรวจขนาด KV pool เทียบ context length เข้าไปในขั้นตอนปล่อยระบบทุกครั้ง
- ทีมที่ทดสอบระบบ AI ควรเพิ่มการตรวจเนื้อหาคำตอบที่พรอมต์ยาวสุด ไม่ใช่ตรวจเพียงรหัส HTTP และเวลาตอบ ซึ่งเป็นช่องว่างที่ Cloudflare ระบุเอง
- ผู้ซื้อบริการ AI แบบหลายผู้เช่า ควรถามผู้ให้บริการว่าใช้ engine รุ่นใด มีการตรวจความถูกต้องของ KV cache หรือไม่ และมีกระบวนการเปิดเผยเหตุ KV cache รั่วแบบที่ Cloudflare ทำครั้งนี้หรือไม่
การเปิดเผยเหตุ KV cache รั่วครั้งนี้ต่างจากเหตุขัดข้องทั่วไปตรงที่ไม่มีระบบล่ม แต่มีข้อมูลข้ามไปมาระหว่างลูกค้าโดยไม่มีสัญญาณเตือน ติดตามข่าวความปลอดภัยของบริการคลาวด์และ AI ได้ที่หมวด Cloud
คำถามที่พบบ่อย
KV cache รั่วบน Workers AI ของ Cloudflare คืออะไร?
คือเหตุการณ์ที่โมเดล GLM-5.3 บน Workers AI ของ Cloudflare สร้างคำตอบโดยอ่านหน่วยความจำ KV cache บน GPU ที่ยังมีข้อมูลจากคำขอของผู้ใช้รายอื่นค้างอยู่ ทำให้คำตอบ 155 ครั้งระหว่าง 27 สิงหาคมถึง 9 กันยายน 2026 มีข้อความของลูกค้ารายอื่นปน Cloudflare เรียกเหตุนี้ว่า KV cache รั่วข้ามคำขอ (cross-request KV cache exposure) และเผยแพร่รายงานเมื่อ 26 ตุลาคม 2026
ใครได้รับผลกระทบจากเหตุ KV cache รั่วครั้งนี้?
Cloudflare ระบุว่าเหตุ KV cache รั่วกระทบเพียงลูกค้าที่เรียกโมเดล @cf/zai-org/glm-5.3 ด้วยพรอมต์ยาวเกิน 681,280 โทเคนในช่วง 27 สิงหาคมถึง 9 กันยายน 2026 เท่านั้น รวม 155 คำตอบ ไม่มีโมเดลอื่นบน Workers AI ได้รับผลกระทบ และบริษัทไม่พบหลักฐานว่ามีผู้จงใจใช้ช่องโหว่นี้
สาเหตุของ KV cache รั่วคืออะไร?
สาเหตุของ KV cache รั่วมีสองปัจจัยซ้อนกัน หนึ่งคือ Cloudflare ตั้ง context window ของ GLM-5.3 ไว้ 1,048,576 โทเคน แต่ KV cache pool บน GPU prefill รองรับได้ 681,280 โทเคน สองคือบั๊กใน SGLang แบบ disaggregated ที่คำขอซึ่งถูกปฏิเสธยังถูกส่งต่อไปยังเครื่อง decode และ decode อ่านหน้าหน่วยความจำเก่าที่ยังมีข้อมูลของคำขออื่น
องค์กรที่รัน SGLang เองต้องทำอะไร?
เพื่อปิดช่อง KV cache รั่ว Cloudflare และทีม SGLang แนะนำให้อัปเดตเป็น v0.5.22 ขึ้นไป วัดขนาด KV pool เทียบกับ context length บนทุกเครื่อง prefill และ decode จาก log ตอนเริ่มระบบ เปิด deferred KV release ทั้งสองฝั่ง จำกัดขนาด batch ของการโอนผ่าน Mooncake และเปิดการตรวจ checksum หรือ KV canary เมื่อโมเดลรองรับ
แหล่งอ้างอิง
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Cloudflare14HackerOne7RadixArk2
- ผลิตภัณฑ์และเทคโนโลยี
- Workers AI2SGLang8
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ