
Google เปิดซอร์ส TorchTPU รัน PyTorch บน TPU แบบเนทีฟ พัฒนาร่วมกับ Meta มาแทน PyTorch/XLA
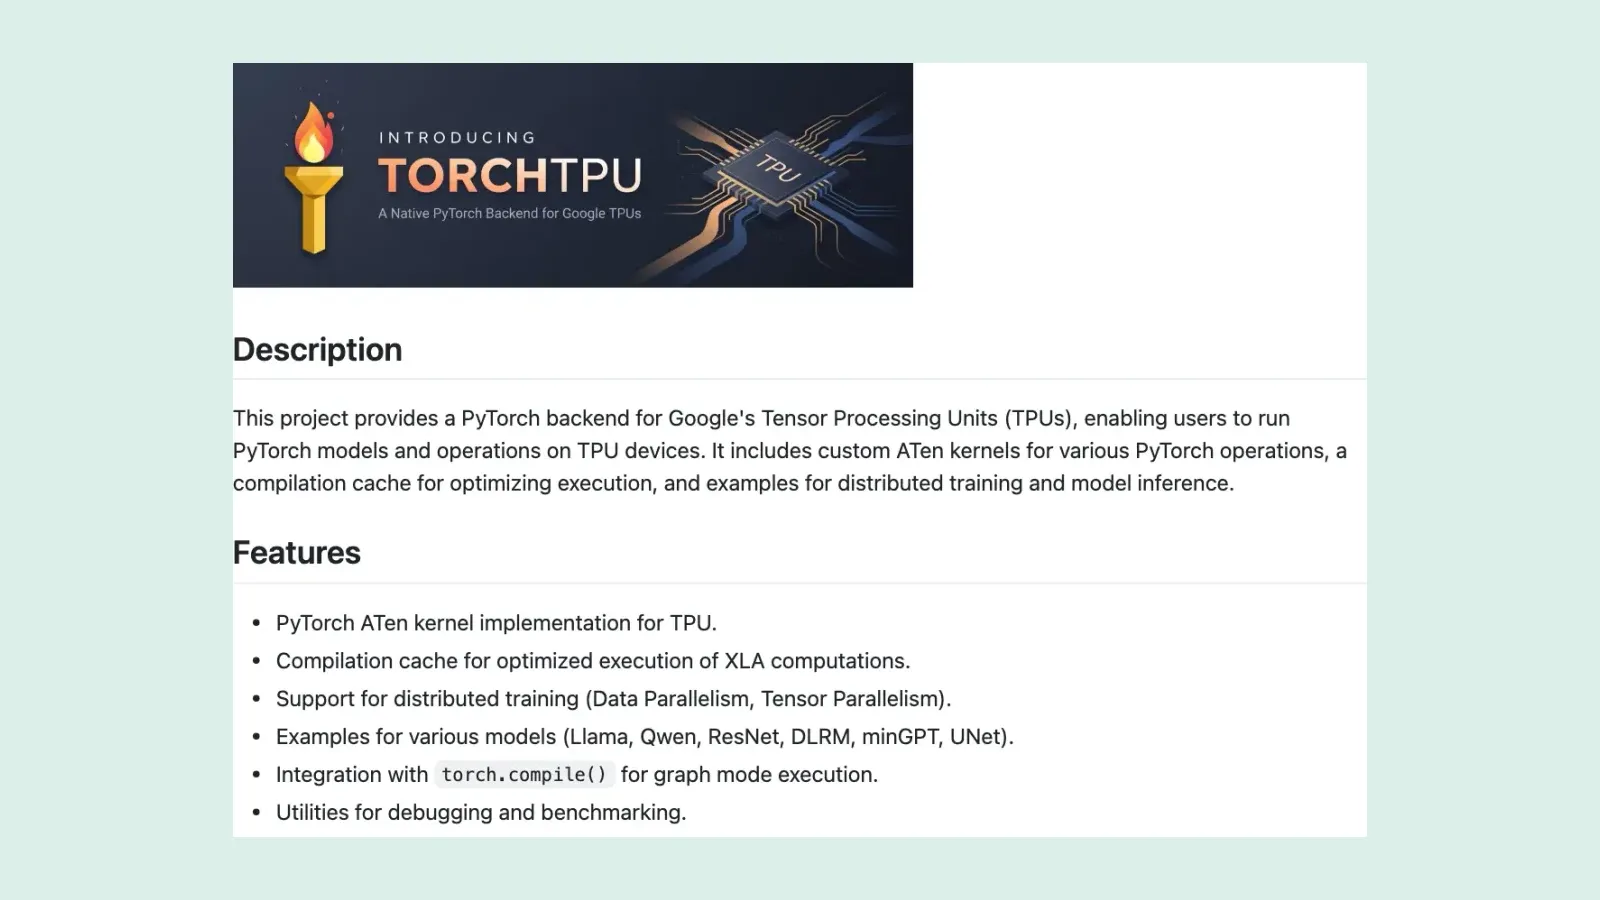
Google เปิดซอร์ส TorchTPU บน GitHub 20 ต.ค. 2026 ให้รัน PyTorch บน TPU แบบเนทีฟด้วย torch.device('tpu') พัฒนาร่วมกับ Meta และให้ย้ายงาน PyTorch/XLA มาใช้แทน
โดย กองบรรณาธิการ THAI DATA อ่าน 5 นาที
สรุปประเด็นสำคัญ
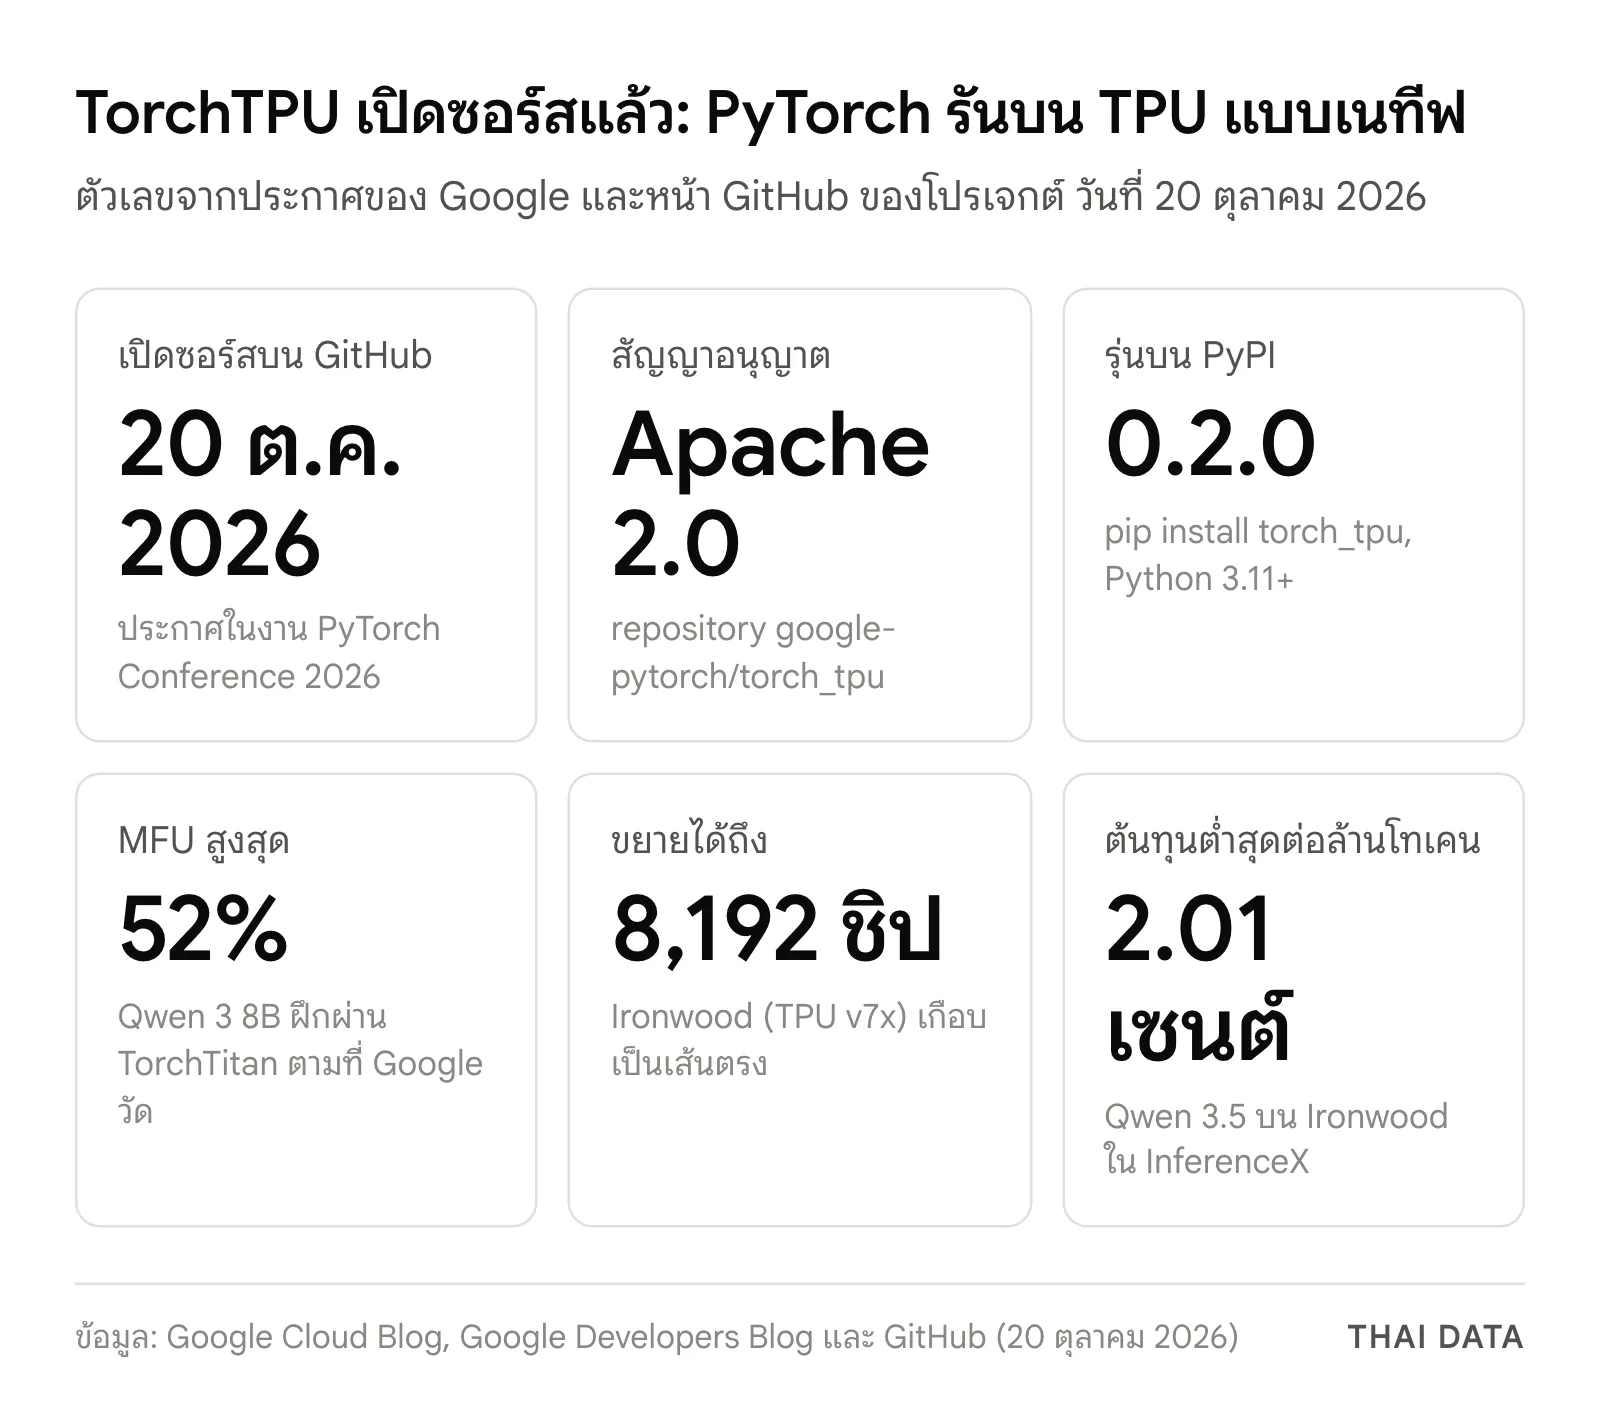
- 20 ตุลาคม 2026 ในงาน PyTorch Conference 2026 Google ประกาศว่า TorchTPU ชุดซอฟต์แวร์สำหรับรัน PyTorch บน TPU แบบเนทีฟ เปิดเป็นโอเพนซอร์สบน GitHub แล้ว ใช้สัญญาอนุญาต Apache 2.0
- เอกสาร Google Cloud ระบุว่า TorchTPU มาแทน PyTorch/XLA แนะนำให้เริ่มงานใหม่ด้วย TorchTPU และย้ายงาน PyTorch/XLA เดิมมาใช้ ติดตั้งด้วย
pip install torch_tpuรุ่นบน PyPI ล่าสุดคือ 0.2.0 รองรับ Python 3.11 ขึ้นไป - Google ระบุว่าการฝึกโมเดลผ่าน TorchTitan บน TorchTPU ได้ MFU สูงสุด 52% กับ Qwen 3 8B และขยายได้เกือบเป็นเส้นตรงถึง 8,192 ชิป Ironwood
- Hugging Face Transformers v5 ส่งโมเดลขึ้น TPU ได้ด้วย
device_map="tpu"และมี vLLM กับ SGLang รุ่นที่ทำงานบน TorchTPU ซึ่ง Google บอกว่าใช้งานจริงกับลูกค้ากลุ่มพรีวิวแล้ว - Google เปิดเผย TorchTPU ครั้งแรกในบล็อกนักพัฒนาเมื่อ 7 เมษายน 2026 ก่อนเปิดซอร์สในวันเดียวกับที่ AWS เปิดตัว TorchNeuron สำหรับชิป Trainium
Google เปิดซอร์ส TorchTPU บน GitHub เมื่อวันที่ 20 ตุลาคม 2026 ในงาน PyTorch Conference 2026 ทำให้รัน PyTorch บน TPU ได้แบบเนทีฟ เรียกอุปกรณ์ด้วย torch.device("tpu") เหมือน GPU และ CPU ชุดนี้พัฒนาร่วมกับทีม PyTorch ของ Meta และเอกสารของ Google Cloud ระบุว่าจะมาแทน PyTorch/XLA
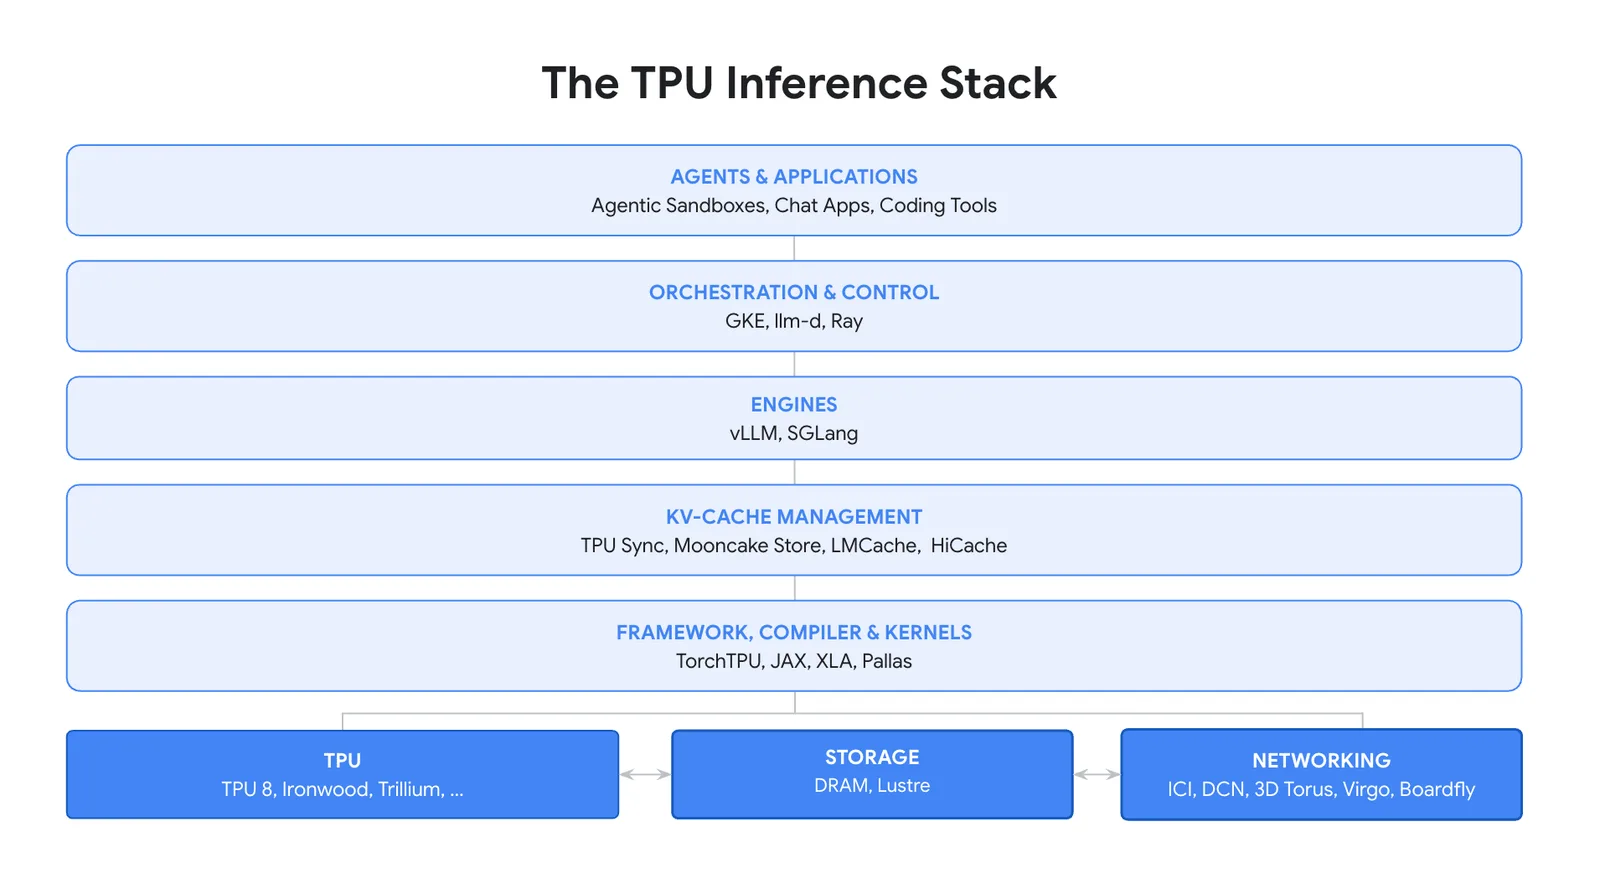
ประกาศนี้เขียนโดย Mark Lohmeyer รองประธานและผู้จัดการทั่วไปฝ่าย AI & Computing Infrastructure และ Bill Jia รองประธานฝ่ายวิศวกรรมของ Google ซึ่งระบุว่าด้วย TorchTPU ชิป TPU กลายเป็นตัวเลือกเนทีฟของ PyTorch ข้างเดียวกับ GPU และ CPU ใช้กับเครื่องมือที่ทีม AI ใช้อยู่แล้ว เช่น vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec และ Hugging Face Google เปิดเผย TorchTPU ครั้งแรกในบล็อกนักพัฒนาเมื่อ 7 เมษายน 2026 และครั้งนี้คือการเปิดซอร์สให้ทุกคนใช้และร่วมพัฒนา
PyTorch บน TPU เดิมยากอย่างไร
ที่ผ่านมา TPU ใช้คู่กับ JAX และ TensorFlow เป็นหลัก บทความของ Google Developers Blog เล่าว่านักพัฒนาที่อยากฝึกโมเดล PyTorch บน TPU ต้องเลือกระหว่างเขียนโค้ดใหม่ทั้งหมดเป็น JAX หรือใช้ torch_xla ที่ Google เรียกว่าเป็นของรุ่นเก่า ส่วนเอกสาร Google Cloud อธิบายว่า PyTorch/XLA ใช้การบันทึกกราฟแบบ lazy tensor ซึ่งมักต้องเพิ่มโค้ดกำหนดส่วนที่คอมไพล์ได้
TorchTPU เปลี่ยนแนวทางเป็นแบบที่คนใช้ PyTorch คุ้นเคย
- รันแบบ eager เป็นค่าเริ่มต้น ใช้รูปแบบหนึ่ง process ต่อหนึ่งอุปกรณ์ตามมาตรฐานของ PyTorch ไม่ต้องพึ่ง JAX runtime
- มี eager 3 โหมด คือ Strict (ค่าเริ่มต้น) Debug ที่รันแบบ synchronous และตรวจขอบเขต tensor และ DeferAndFuse ที่รวมคำสั่งหลายตัวเพื่อลดการอ่านเขียนหน่วยความจำ HBM
- คอมไพล์ด้วย torch.compile ผ่าน TorchDynamo ไปเป็นโค้ดเครื่องของ TPU ผ่าน OpenXLA และ StableHLO แล้วเก็บแคชข้าม process และการรีสตาร์ตงาน
- กระจายงานหลายชิป ด้วย DDP, FSDP2 และ DTensor ผ่าน backend
tpu_dist
เอกสารของ Google Cloud เขียนไว้ชัดว่า "TorchTPU มาแทน PyTorch/XLA" และแนะนำให้เริ่มงานใหม่ด้วย TorchTPU พร้อมย้ายงาน PyTorch/XLA เดิมมาใช้
สิ่งที่อยู่ใน repository ของ TorchTPU
หน้า GitHub ของ google-pytorch/torch_tpu ใช้สัญญาอนุญาต Apache 2.0 มี ATen kernel สำหรับ TPU แคชการคอมไพล์ ตัวอย่างโมเดล Llama, Qwen, ResNet, DLRM, minGPT และ UNet และเครื่องมือดีบักกับวัดประสิทธิภาพ รุ่นสาธารณะล่าสุดบน PyPI คือ 0.2.0 รองรับ Python 3.11 ขึ้นไป ส่วนโน้ตบุ๊กตัวอย่างต้องรันจาก TPU VM โดยหน้า GitHub ระบุว่าเครื่อง v6e ใช้ง่ายที่สุด
| องค์ประกอบ | สิ่งที่ Google ประกาศ 20 ต.ค. 2026 | พาร์ตเนอร์ |
|---|---|---|
| TorchTPU | backend เนทีฟของ PyTorch บน TPU เปิดซอร์สบน GitHub | Meta |
| Hugging Face | Transformers v5 ใช้ device_map="tpu" และ Diffusers รันบน TPU ได้ |
Hugging Face |
| vLLM-TorchTPU | เอนจินให้บริการโมเดลบน TPU ด้วย PyTorch | Inferact |
| SGLang-TorchTPU | เอนจินสำหรับงาน agent และงานที่มีโครงสร้าง | RadixArk |
| TorchTitan บน TPU | สูตรฝึกโมเดลขนาดใหญ่ แยกเป็น fork ของ Google | Meta |
| VeRL | Google ส่ง backend TPU และสูตรตัวอย่างเข้าโปรเจกต์ VeRL สำหรับ reinforcement learning (พรีวิว) | — |
| Ray | จัดตารางงานข้าม CPU, GPU และ TPU ใน workflow เดียว | Anyscale |
| TPU agent suite | ผู้ช่วยตั้งค่าและจูนโมเดลผ่านเครื่องมือเขียนโค้ด AI (early preview) |
ตัวเลขประสิทธิภาพของ PyTorch บน TPU ที่ Google ประกาศ
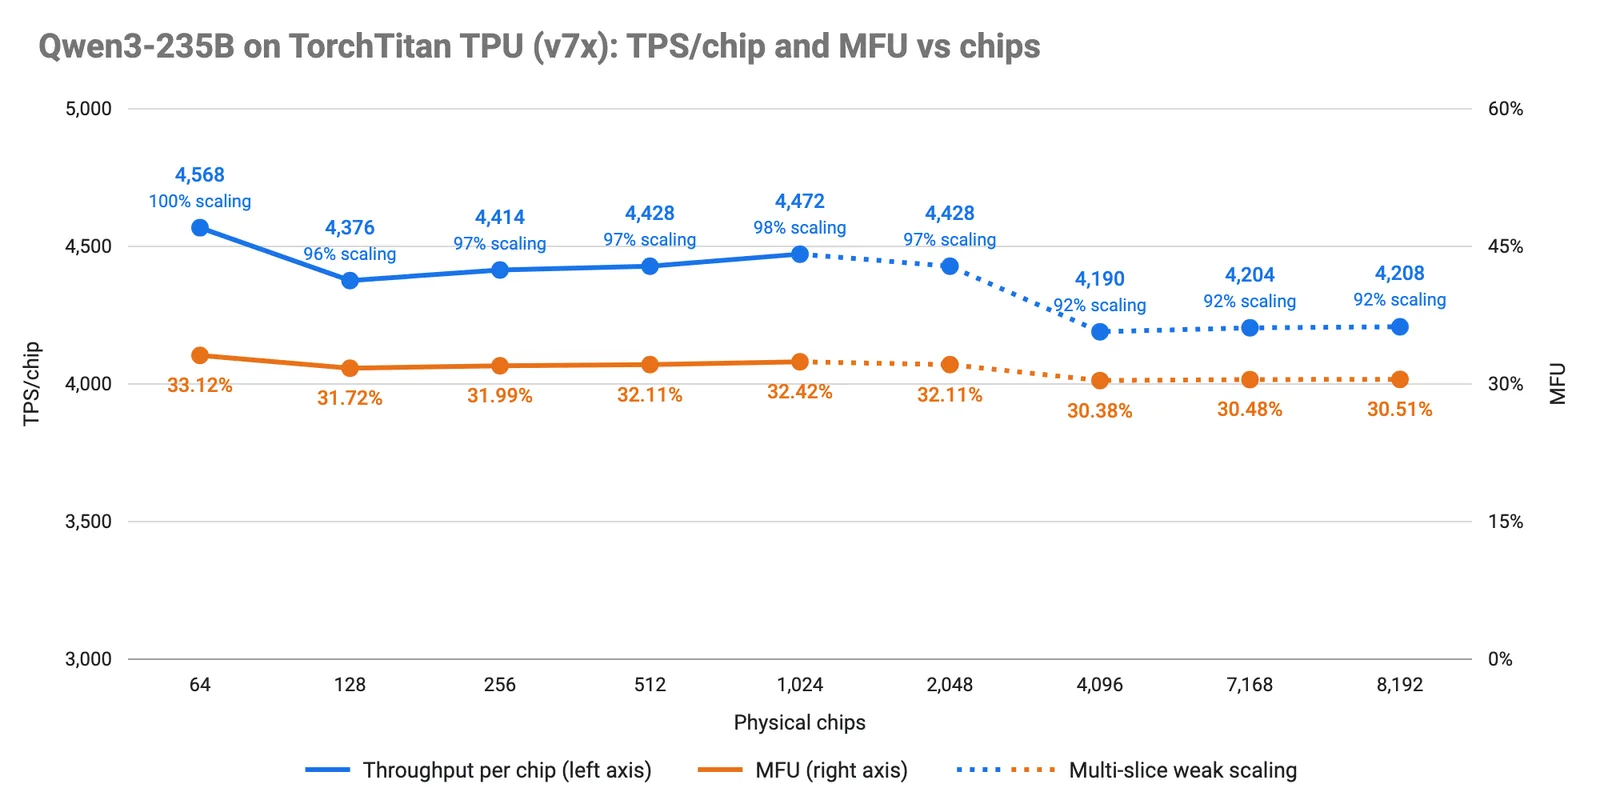
Google ระบุในบล็อก Google Cloud ว่าเส้นทางการฝึกโมเดลของ TorchTPU ผ่าน TorchTitan ได้ Model FLOPs Utilization (MFU) สูงสุด 52% กับ Qwen 3 8B และขยายได้เกือบเป็นเส้นตรงอย่างเสถียรถึง 8,192 ชิป Ironwood (TPU v7x) TorchTitan มีสูตรฝึกโมเดลตั้งแต่ Llama 3 70B และ 405B, Qwen 3 8B และ 32B, Qwen 3 235B แบบ Mixture-of-Experts ไปจนถึง FLUX.1 12B
บทความของ Google Developers Blog เสริมว่าเทคนิค SimpleFSDP ทำให้ TorchTitan บน TPU ทำประสิทธิภาพกับโมเดล FLUX ได้ 99% ของ JAX MaxDiffusion ส่วนฝั่งให้บริการโมเดล Google ระบุว่าเอนจิน vLLM และ SGLang บน TorchTPU ทำงานจริงกับลูกค้ากลุ่มพรีวิวแล้ว และจากการทดสอบสาธารณะ SemiAnalysis InferenceX กับโมเดล Qwen 3.5 บน Ironwood ทีมลดต้นทุนต่ำสุดลงเหลือ 2.01 เซนต์ต่อล้านโทเคน ทั้งหมดนี้เป็นตัวเลขที่ Google วัดและเผยแพร่เอง
Meta และ Hugging Face พูดถึงการรัน PyTorch บน TPU อย่างไร
Jana van Greunen ผู้อำนวยการฝ่ายวิศวกรรม PyTorch ของ Meta กล่าวในประกาศว่า "เราไม่สามารถถูกจำกัดด้วยสถาปัตยกรรมฮาร์ดแวร์แบบเดียว" และระบุว่า TorchTPU ช่วยให้ Meta ส่งงาน PyTorch ขึ้น TPU ของ Google ได้ ทั้งงาน LLM โฆษณา และระบบแนะนำเนื้อหา บทความเรื่องเอนจินให้บริการยังระบุว่า SGLang-TorchTPU ทำงานจริงที่ Meta แล้ว
ฝั่ง Hugging Face นอกจาก device_map="tpu" ใน Transformers v5 แล้ว Google ทำ CI/CD ทดสอบชุด Transformers บน TPU ทุกคืน Jeff Boudier รองประธานฝ่ายผลิตภัณฑ์ของ Hugging Face กล่าวว่า "ความหลากหลายของฮาร์ดแวร์เป็นสิ่งจำเป็นต่อการทำให้ AI แบบโอเพนซอร์สเข้าถึงได้สำหรับทุกคน"
ทำไมเรื่องนี้สำคัญ
ตั้งแต่เปิดเผย TorchTPU ครั้งแรกเมื่อเดือนเมษายน Google ให้เหตุผลว่าผู้ที่อาจใช้ TPU จำนวนมากสร้างโมเดลด้วย PyTorch การที่ PyTorch บน TPU ใช้งานได้แบบเนทีฟจึงเปิดทางให้ลูกค้า Google Cloud ย้ายโค้ดเดิมไปลองบน TPU โดยไม่ต้องเขียนใหม่เป็น JAX ข่าวนี้มาในวันเดียวกับที่ AWS เปิดตัว TorchNeuron ให้ PyTorch รันบนชิป Trainium และ llm-d 1.0 ที่ใช้กระจายงาน inference ข้าม GPU และ TPU บน Kubernetes ทั้ง Google และ AWS จึงเดินทางเดียวกัน คือทำให้ชิป AI ของตัวเองรับโค้ด PyTorch ได้โดยไม่ต้องเขียนใหม่ ซึ่งทำให้การเลือกฮาร์ดแวร์ขึ้นกับราคาและความพร้อมมากขึ้น
ผลต่อองค์กรไทย
- ทีมที่รัน PyTorch บน TPU ผ่าน PyTorch/XLA อยู่ควรวางแผนย้าย Google แนะนำให้ย้ายงานเดิมมาใช้ TorchTPU และเริ่มงานใหม่บน TorchTPU ตั้งแต่ตอนนี้
- ทดสอบ PyTorch บน TPU ด้วยโมเดลจริงก่อนตัดสินใจ ตัวเลข MFU และต้นทุนต่อโทเคนข้างต้นเป็นผลที่ Google วัดเอง ควรวัดกับโมเดล ขนาด batch และความยาว context ขององค์กรเองเทียบกับ GPU
- ตรวจ Region และโควตา TPU ก่อนวางแผน ดูว่า Region ที่องค์กรใช้ได้ โดยเฉพาะงานที่มีข้อกำหนดเรื่องที่ตั้งข้อมูล มี TPU รุ่นที่ต้องการและโควตาพอหรือไม่
- ใช้ Hugging Face เป็นจุดเริ่ม ทีมที่ปรับแต่งโมเดลโอเพนซอร์สอยู่แล้วลองส่งโมเดลขึ้น TPU ด้วย
device_map="tpu"ได้โดยไม่ต้องรื้อ pipeline - ลดการผูกกับฮาร์ดแวร์รายเดียว เขียนโค้ดฝึกและให้บริการโมเดลด้วย API มาตรฐานของ PyTorch ไว้ เพื่อเลือกได้ทั้ง GPU, TPU หรือ Trainium ตามราคาและความพร้อมของแต่ละช่วง
ติดตามข่าวคลาวด์และโครงสร้างพื้นฐาน AI เพิ่มเติมได้ที่หมวดคลาวด์
คำถามที่พบบ่อย
TorchTPU คืออะไร?
TorchTPU คือ backend ที่ทำให้รัน PyTorch บน TPU ของ Google ได้แบบเนทีฟ โดยเรียกอุปกรณ์ด้วย torch.device('tpu') เหมือนเรียก GPU หรือ CPU Google พัฒนาร่วมกับทีม PyTorch ของ Meta และเปิดเป็นโอเพนซอร์สบน GitHub เมื่อ 20 ตุลาคม 2026 ภายใต้สัญญาอนุญาต Apache 2.0
รัน PyTorch บน TPU ต้องแก้โค้ดมากแค่ไหน?
Google ระบุว่า TorchTPU ให้รัน PyTorch บน TPU ได้โดยแก้โค้ดน้อยที่สุด ส่วนใหญ่คือเปลี่ยนการกำหนดอุปกรณ์เป็น tpu แล้วใช้ API มาตรฐานของ PyTorch ต่อได้ ทั้ง eager mode สำหรับดีบัก torch.compile สำหรับงานจริง และ torch.distributed สำหรับฝึกโมเดลหลายชิป
TorchTPU ต่างจาก PyTorch/XLA อย่างไร?
เอกสาร Google Cloud อธิบายว่า PyTorch/XLA ต้องบันทึกกราฟแบบ lazy tensor และมักต้องเพิ่มโค้ดกำหนดส่วนที่คอมไพล์ได้ ส่วน TorchTPU รัน PyTorch บน TPU แบบ eager เป็นค่าเริ่มต้นตามรูปแบบปกติของ PyTorch และ Google ระบุว่า TorchTPU มาแทน PyTorch/XLA โดยแนะนำให้ย้ายงานเดิมมาใช้
องค์กรไทยเริ่มใช้ PyTorch บน TPU ได้อย่างไร?
เริ่มจากติดตั้งด้วยคำสั่ง pip install torch_tpu บน TPU VM ของ Google Cloud แล้วทดลองกับโมเดลจาก Hugging Face ซึ่ง Transformers v5 ส่งขึ้น TPU ได้ด้วย device_map='tpu' ทั้งนี้ควรตรวจก่อนว่า Region ที่ต้องใช้มี TPU รุ่นที่ต้องการ และทดสอบต้นทุนเทียบกับ GPU ด้วยงานจริงขององค์กร
แหล่งอ้างอิง
- TorchTPU is now open source: Run native PyTorch on TPUs — Google Cloud Blog
- PyTorch on Cloud TPU — Google Cloud Documentation
- google-pytorch/torch_tpu — GitHub
- Integrating TorchTPU into TorchTitan and Optimizing Models for TPU — Google Developers Blog
- Announcing New vLLM and SGLang Inference Engines on TPU — Google Developers Blog
บุคคล องค์กร และสถานที่ในข่าวนี้
เลือกชื่อเพื่ออ่านข่าวทั้งหมดที่กล่าวถึง ตัวเลขคือจำนวนข่าว
- องค์กรและบริษัท
- Google80Meta19GitHub28Google Cloud34Hugging Face9AWS41
- ผลิตภัณฑ์และเทคโนโลยี
- PyTorch8Python19Qwen4vLLM7AWS Trainium5llm-d2Kubernetes21
พบข้อมูลคลาดเคลื่อน? แจ้งกองบรรณาธิการ